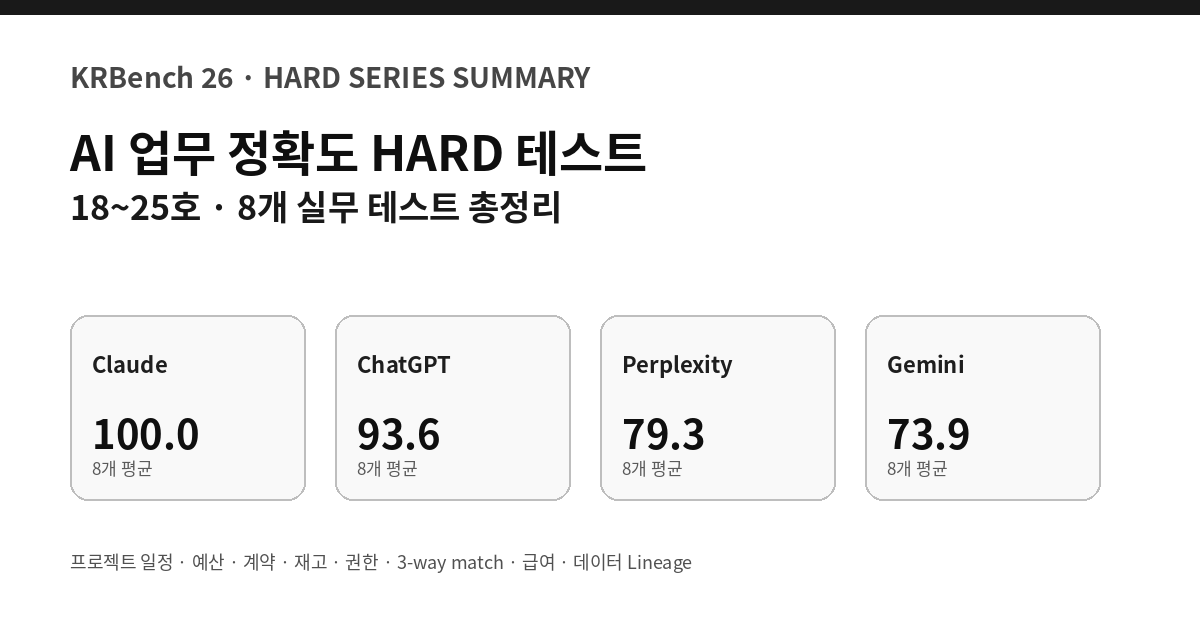
KRBench는 18호부터 테스트 난이도를 크게 올렸습니다. 단순히 행 수를 늘리는 대신, 한 번의 판단이나 계산이 뒤 상태까지 영향을 주는 전역 상태 추적·연쇄 재계산·규칙 우선순위·시간과 금액의 경계 조건을 중심으로 8개 HARD 테스트를 진행했습니다.
이번 글은 18~25호의 결과를 한 번에 정리한 글입니다. 프로젝트 일정, 예산 승인, 계약 청구, 재고 배정, 접근 권한, 발주·입고·인보이스 3-way match, 근태·급여, 데이터 파이프라인 Lineage까지 서로 다른 8개 실무형 문제에서 ChatGPT, Gemini, Claude, Perplexity를 같은 사전 채점 원칙으로 비교했습니다.
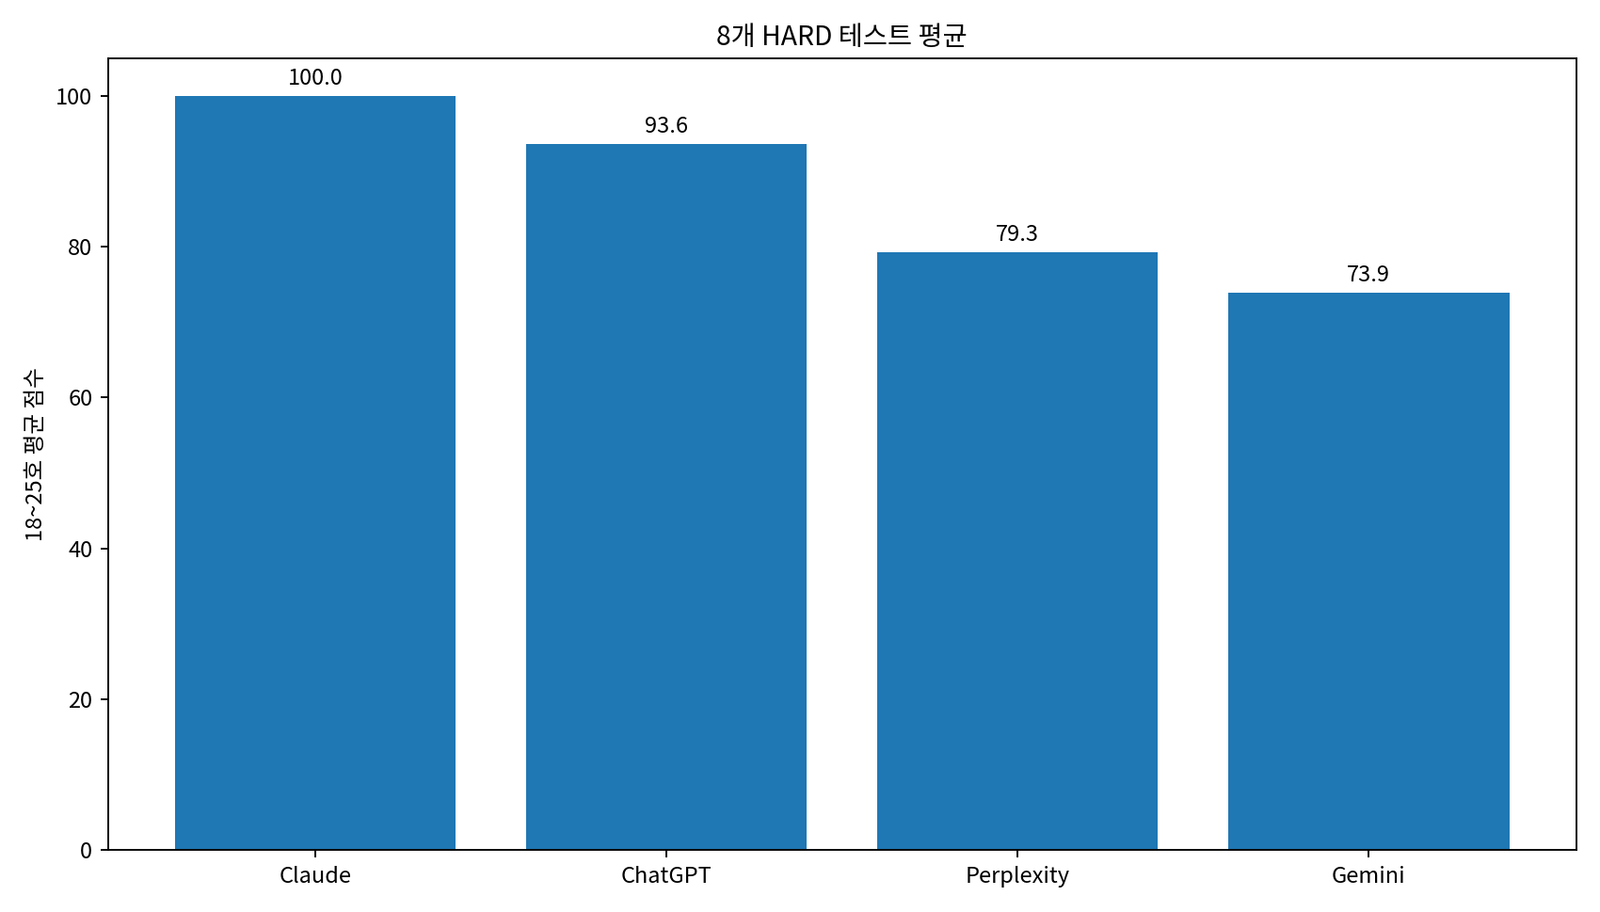
18~25호 8개 테스트 단순 평균
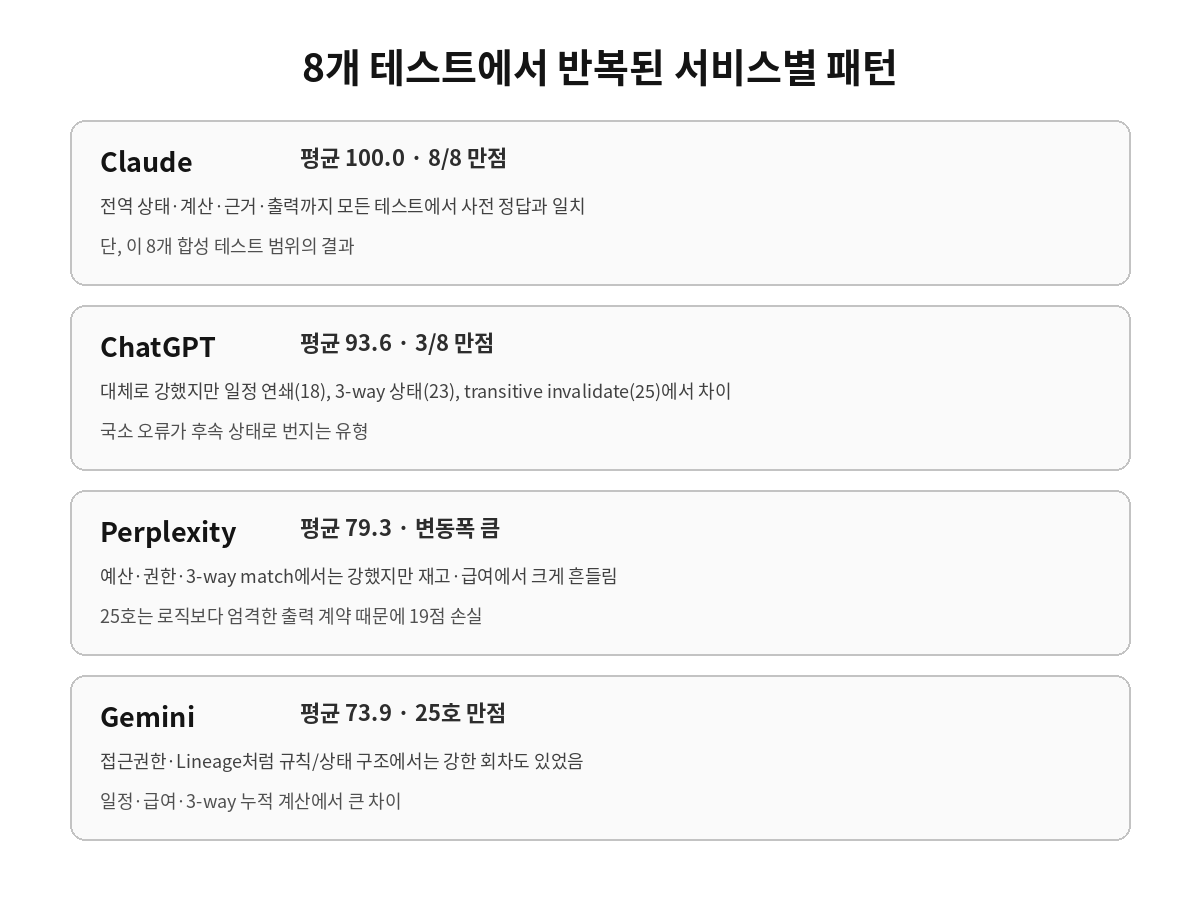
- Claude: 100.0점 · 8회 모두 100점
- ChatGPT: 93.6점 · 100점 3회
- Perplexity: 79.3점 · 100점 1회
- Gemini: 73.9점 · 100점 1회
이 평균은 18~25호의 실제 테스트 결과를 단순 집계한 값입니다. 과제 유형, 테스트 날짜, 서비스의 모델·모드가 다르므로 일반적인 AI 전체 순위로 확대해 해석하지 않습니다.
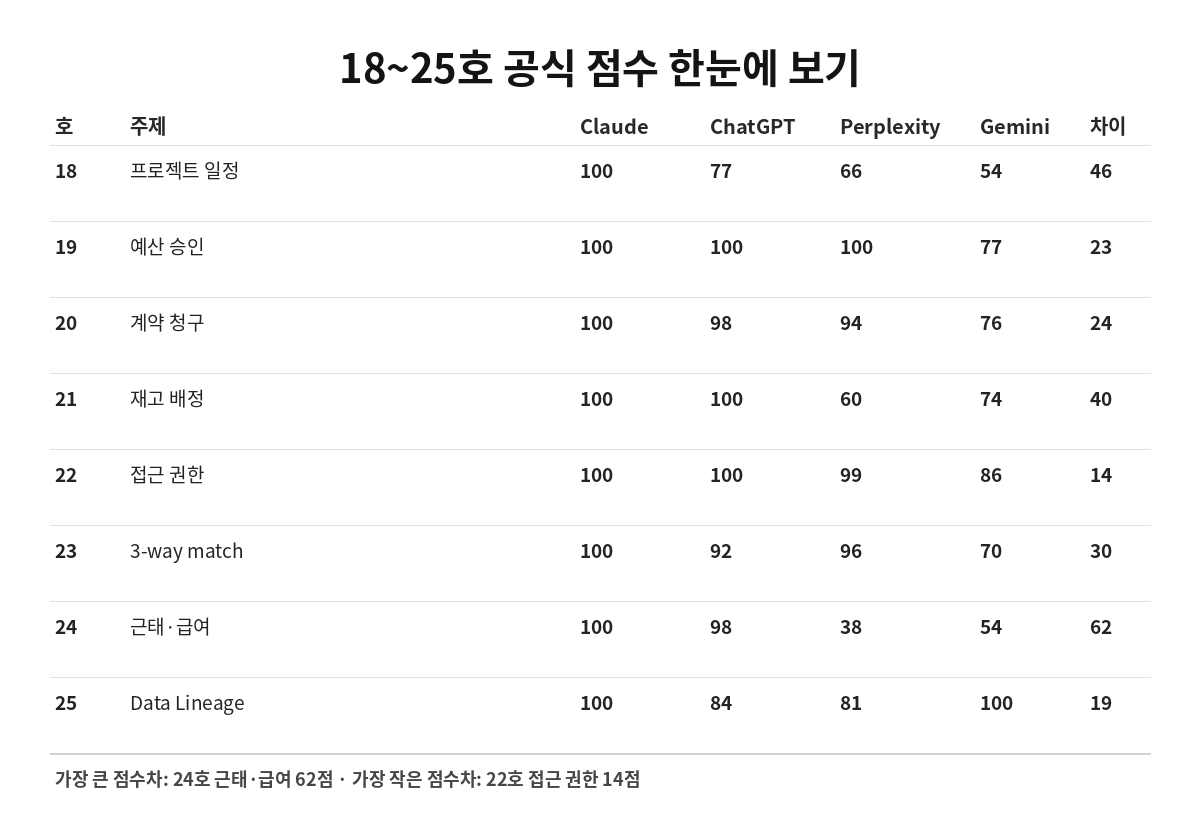
8개 HARD 테스트 전체 점수
| 호 | 테스트 | Claude | ChatGPT | Perplexity | Gemini | 최고-최저 |
|---|---|---|---|---|---|---|
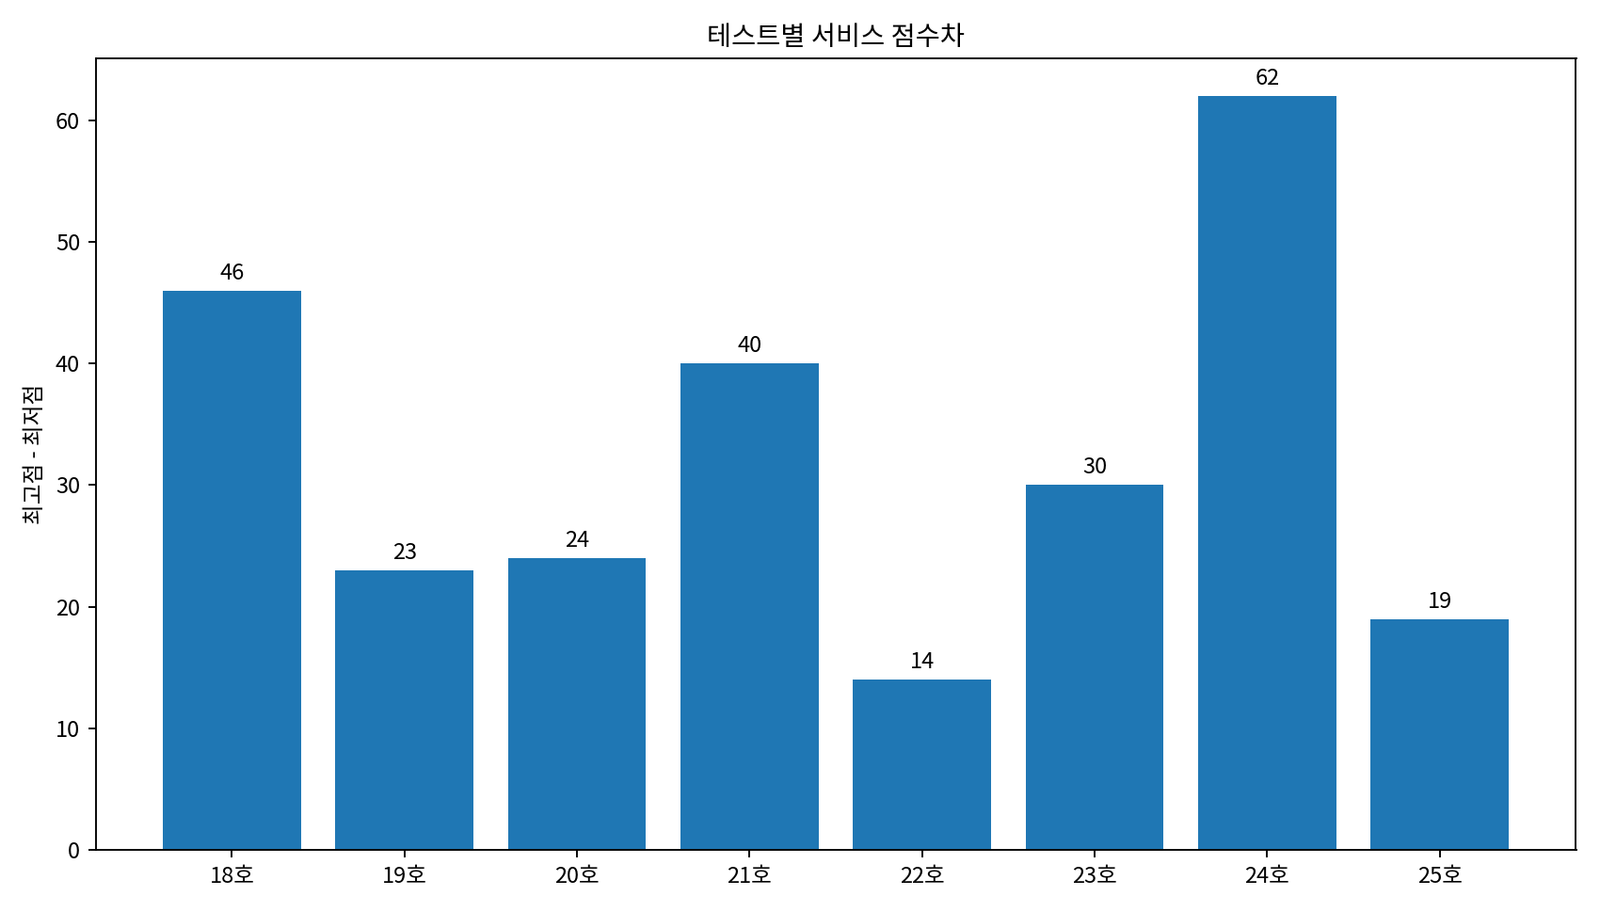
| 18 | 프로젝트 일정 연쇄 재계산 | 100 | 77 | 66 | 54 | 46 |
| 19 | 예산 승인·지출 규정 | 100 | 100 | 100 | 77 | 23 |
| 20 | 계약 변경 이력·청구액 | 100 | 98 | 94 | 76 | 24 |
| 21 | 재고 예약·백오더 전역 재배정 | 100 | 100 | 60 | 74 | 40 |
| 22 | 접근 권한 판정·정책 근거 | 100 | 100 | 99 | 86 | 14 |
| 23 | 발주·입고·인보이스 3-way match | 100 | 92 | 96 | 70 | 30 |
| 24 | 근태·초과근무·야간·휴일 급여 | 100 | 98 | 38 | 54 | 62 |
| 25 | 데이터 파이프라인 Lineage | 100 | 84 | 81 | 100 | 19 |
왜 18호부터 HARD 테스트로 바꿨나
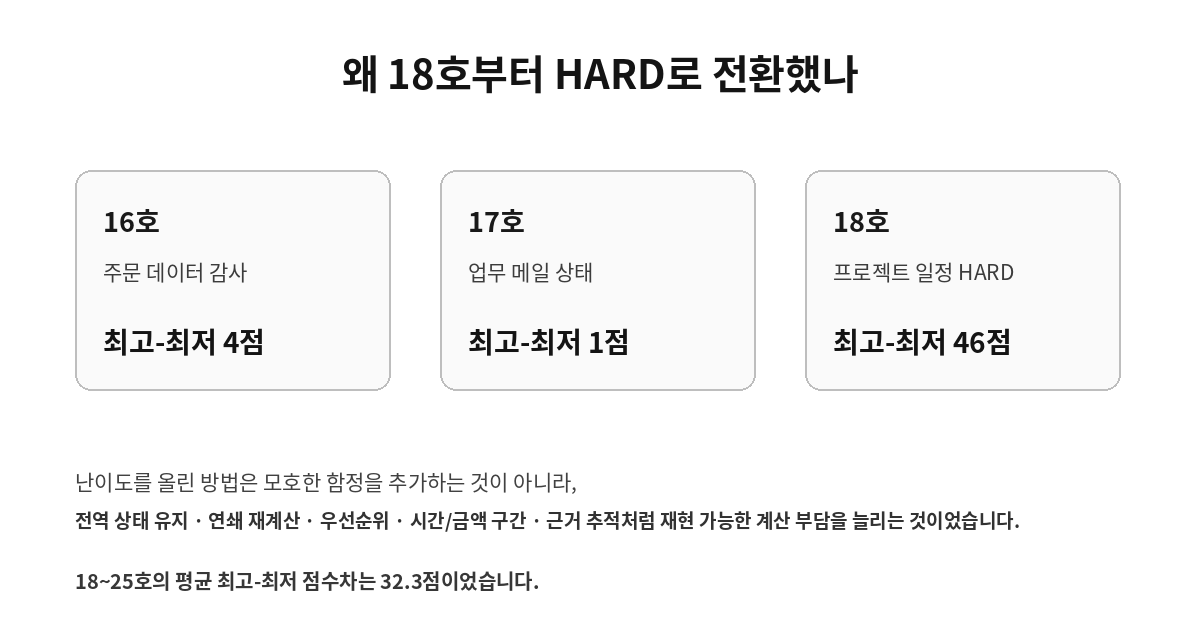
직전 16호 주문 데이터 정합성 감사에서는 최고점과 최저점의 차이가 4점, 17호 업무 메일 상태 추적에서는 1점뿐이었습니다. 당시 테스트도 실제 업무형이었지만, 현재 모델 사이의 차이를 드러내기에는 난이도가 부족했습니다.
18호부터는 모호한 함정을 추가하지 않고 한 번의 상태 변경이 뒤 결과에 다시 영향을 주는 구조를 강화했습니다. 프로젝트 일정의 전역 자원 충돌, 승인 결과에 따른 예산 잔액 변화, COMMIT 이후 재고 잠금, Credit·Void 이후 PO 수량 복구, Shift EDIT/VOID 이후 급여 재계산 같은 식입니다.
그 결과 18~25호의 회차별 최고점과 최저점 차이는 평균 32.3점이었습니다. 다만 이는 모델이 시간에 따라 좋아지거나 나빠졌다는 뜻이 아니라, HARD 설계가 서비스 간 차이를 더 잘 드러냈다는 의미로 봐야 합니다.
Claude: 8개 HARD 테스트에서 모두 100점
Claude는 18~25호 8개 테스트에서 공식 정확도 점수가 모두 100점이었습니다. 일정의 선행조건과 자원 충돌, 예산·Vendor 누적 상태, 계약 변경 이력, 재고 전역 재배정, 접근권한 근거, 3-way match, 급여 프리미엄, 데이터 Lineage까지 사전 Oracle과 일치했습니다.
이번 8개 테스트 안에서는 가장 일관적인 결과입니다. 특히 하나의 오류가 뒤 상태로 전파되기 쉬운 문제에서도 마지막 CHECK까지 상태를 유지했습니다.
다만 이 결과를 모든 실무·모든 모델 버전에서 Claude가 항상 가장 정확하다는 의미로 확대하지 않습니다. 이번 집계는 KRBench가 만든 8개 합성 HARD 테스트와 해당 날짜의 실제 실행 결과에 한정됩니다.
ChatGPT: 평균 93.6점, 대부분 강했지만 전역 상태에서 몇 차례 흔들림
ChatGPT는 19호 예산 승인, 21호 재고 배정, 22호 접근 권한에서 100점을 기록했고 20호와 24호도 98점이었습니다.
차이가 크게 난 회차는 18호 프로젝트 일정 77점과 25호 데이터 파이프라인 84점이었습니다. 18호에서는 중간 일정 차이가 후반 작업까지 연쇄적으로 전파됐고, 25호에서는 이미 transitive INVALIDATE된 Downstream Version을 fallback 후보로 남겨 BLOCKED 판정을 놓쳤습니다.
23호 3-way match에서도 92점으로, Credit·Void·부분 승인처럼 과거 이벤트가 현재 잔량을 다시 바꾸는 구간에서 일부 차이가 있었습니다.
Perplexity: 100점도 있었지만 회차별 변동이 가장 컸다
Perplexity는 19호 예산 승인에서 정확도 100점, 22호 접근 권한에서 99점, 23호 3-way match에서 96점을 기록했습니다. 반면 21호 재고 배정은 60점, 24호 근태·급여는 38점으로 크게 떨어졌습니다.
특히 24호에서는 GrossPayKRW 25건이 모두 사전 정답과 달랐고, 후반 Shift EDIT/VOID 이후 근무시간 상태도 흔들렸습니다.
25호의 81점은 별도로 봐야 합니다. Status, LatestValidRun, AgeMinutes는 모두 25/25였고 Root Source의 의미도 맞았지만, 프롬프트가 요구한 O:R01 형식 대신 O_RAW_ORDERS:R01처럼 전체 Dataset명을 출력했습니다. 사전에 RootSources 문자열을 정확 비교하기로 했기 때문에 19점이 감점됐습니다.
또 19호에서는 정확도는 100점이었지만, “표 하나만 출력”하라는 요구와 달리 표 앞에 계산 설명을 추가해 별도 출력 형식 위반으로 기록했습니다. 즉 Perplexity는 추론 정확도와 출력 계약 준수를 분리해서 보는 것이 특히 중요했습니다.
Gemini: 테스트 유형에 따라 결과 변화가 컸고 25호에서는 100점
Gemini는 18호 프로젝트 일정과 24호 근태·급여에서 각각 54점으로 가장 낮았고, 23호 3-way match도 70점이었습니다. 이 회차들에서는 앞선 상태를 오래 유지하거나 시간·수량·금액 계산을 후속 이벤트에 다시 반영하는 과정에서 차이가 커졌습니다.
반면 22호 접근 권한에서는 86점까지 올라갔고, 25호 데이터 파이프라인 Lineage에서는 100점을 기록했습니다. INVALIDATE cascade, fallback, RESTORE 비전파, SLA 경계까지 전부 사전 정답과 일치했습니다.
한 서비스의 단일 점수만으로 성격을 단정하기보다 어떤 구조의 문제에서 흔들렸는지를 보는 것이 더 유용한 이유입니다.
8개 테스트에서 반복해서 나타난 5가지 오류 유형
주제는 모두 달랐지만 오답이 만들어지는 구조는 몇 가지로 반복됐습니다.
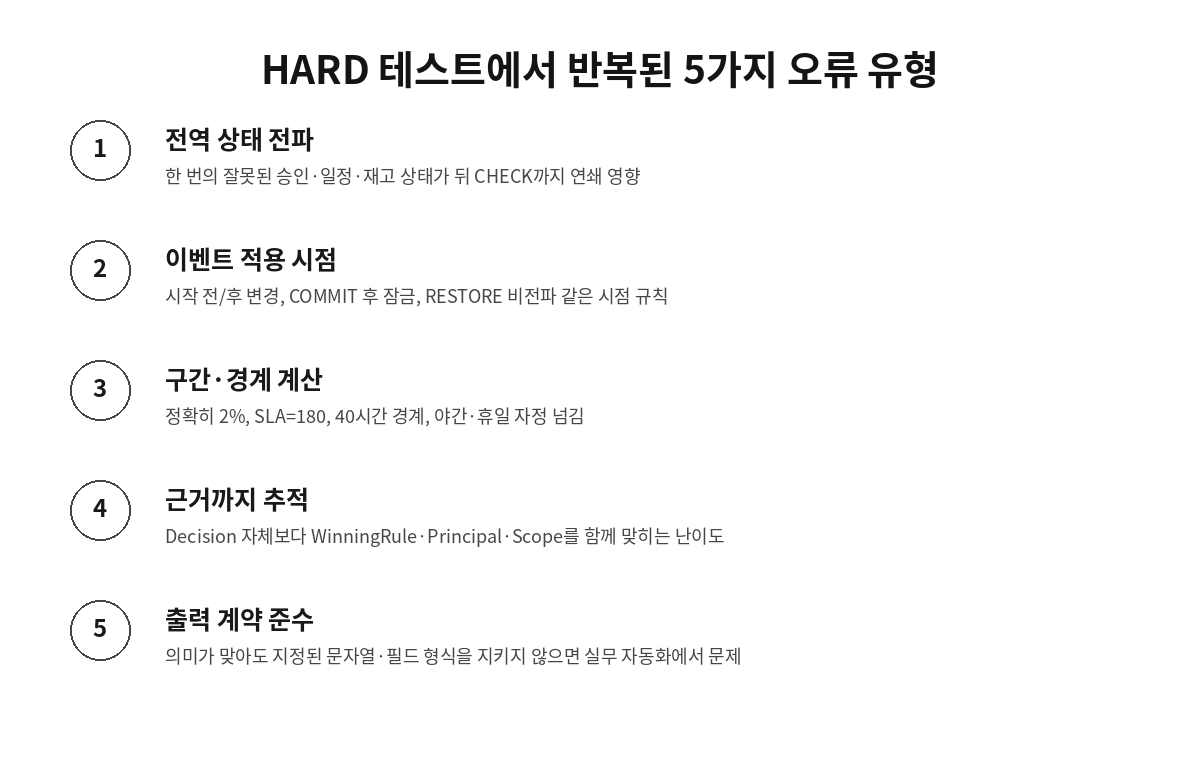
첫째, 전역 상태 전파. 일정 하나, 승인 하나, 재고 배정 하나를 잘못 계산하면 뒤 CHECK의 입력 상태가 달라져 오답이 연속해서 발생했습니다.
둘째, 이벤트 적용 시점. 시작 전과 시작 후의 변경, COMMIT 이후 잠금, DONE 이후 UPDATE 무시, RESTORE의 비전파처럼 같은 이벤트도 언제 발생했는지가 핵심이었습니다.
셋째, 구간과 경계. 정확히 +2%까지 허용, SLA와 정확히 같은 180분은 FRESH, 40시간을 넘는 순간부터 Overtime, 22:00~06:00의 자정 넘김처럼 경계값 하나가 결과를 갈랐습니다.
넷째, 최종 답이 아니라 근거까지 맞히기. 22호에서는 ALLOW/DENY만 보는 것보다 WinningRule, PrincipalMatch, ScopeMatch를 함께 요구하자 차이가 더 커졌습니다.
다섯째, 출력 계약. 실제 업무 자동화에서는 값의 의미가 맞아도 API나 후속 시스템이 요구하는 문자열·필드 형식을 지키지 않으면 실패할 수 있습니다. 25호 Perplexity가 대표 사례였습니다.
8개 테스트가 다룬 실무 영역
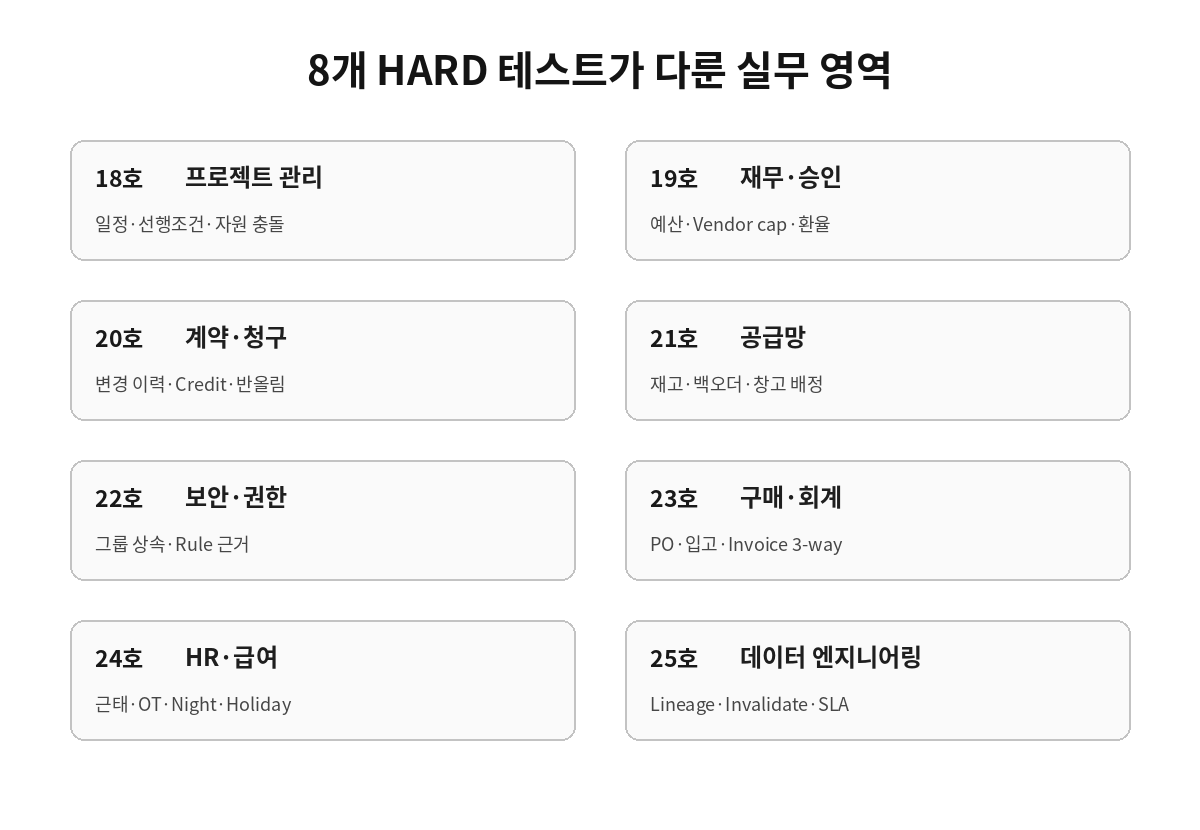
이번 HARD 시리즈는 하나의 직무만 반복하지 않았습니다. 프로젝트 관리, 재무 승인, 계약·청구, 공급망, 보안·접근제어, 구매·회계, HR·급여, 데이터 엔지니어링으로 영역을 넓혔습니다.
공통점은 모두 한 번의 답변에서 많은 상태를 동시에 유지해야 하고, 중간 이벤트가 이후 결과를 바꾸는 실무형 문제라는 점입니다.
점수만으로 “최고의 AI”를 정하면 안 되는 이유
8개 평균만 보면 Claude 100.0, ChatGPT 93.6, Perplexity 79.3, Gemini 73.9 순입니다. 하지만 이 숫자는 어디까지나 KRBench 18~25호 조건 안에서의 평균입니다.
테스트 날짜가 서로 다르고 서비스의 모델과 모드도 업데이트될 수 있습니다. 또한 예산 규정과 급여 계산, 접근권한과 데이터 Lineage는 요구 능력이 다릅니다. 따라서 이 글의 목적은 하나의 영구적인 AI 순위를 만드는 것이 아니라, 복잡한 업무를 맡겼을 때 어떤 종류의 오류가 실제로 발생했는지를 기록하는 데 있습니다.
응답시간도 같은 이유로 평균 순위를 만들지 않았습니다. 각 서비스에서 각 테스트마다 한 번만 측정한 값이라 서버 상태와 처리 모드의 영향을 받을 수 있기 때문입니다.
18~25호 개별 테스트 보기
23호 · 발주·입고·인보이스 3-way match
부분 승인, Credit, Void, Return이 현재 PO와 입고 잔량을 어떻게 바꾸는지 추적했습니다.
→ 23호 결과 보기24호 · 근태·초과근무·야간·휴일 급여
Shift EDIT/VOID, PTO, 자정 넘김, Overtime·Night·Holiday 프리미엄 중첩을 계산했습니다.
→ 24호 결과 보기25호 · 데이터 파이프라인 Lineage
DAG, transitive INVALIDATE, fallback, RESTORE, backfill과 SLA 상태를 추적했습니다.
→ 25호 결과 보기이번 총정리의 한계
- 18~25호는 모두 KRBench가 만든 합성 실무 데이터와 명시적 가상 정책을 사용했습니다.
- 각 테스트의 주제와 난이도 구조가 달라 평균 점수가 동일한 능력 하나를 측정한다고 볼 수 없습니다.
- 테스트 날짜가 2026-09-27부터 2026-10-07까지 다르고, 서비스 모델·모드 표기도 회차별로 달라질 수 있습니다.
- Perplexity 25호처럼 공식 점수에 출력 계약 준수가 포함된 회차가 있으므로 총점과 오류 성격을 함께 봐야 합니다.
- 응답시간은 각 서비스·테스트별 단일 실행 측정값이며 평균 속도 순위로 일반화하지 않았습니다.
다음 글: 11~25호 전체 업무 벤치마크 최종결산
26호에서는 난이도를 크게 높인 18~25호 HARD 8편만 묶었습니다. 다음 총정리에서는 11~25호 전체 업무 벤치마크를 문서 근거 추적, 규정 판단, 상태 추적, 계산·정산, 전역 연쇄 추론으로 다시 분류해 어떤 업무에서 어떤 오류가 반복됐는지 정리할 예정입니다.
11~20호 중간결산도 함께 보기
HARD 전환 전후를 포함해 첫 10개 업무 벤치마크의 반복 오류와 점수 흐름을 먼저 정리한 글입니다.
→ 11~20호 업무 벤치마크 중간결산 보기11호부터 25호까지 15개 업무 테스트를 전부 묶으면 어떤 패턴이 남을까?
문서 근거, 규정 판단, 상태 추적, 계산·정산, 전역 연쇄 추론으로 다시 분류해 전체 점수와 반복 오류를 최종 정리했습니다.
→ KRBench 업무 정확도 15개 테스트 최종결산 보기KRBench는 서비스 간 차이를 만들기 위해 정답을 바꾸지 않습니다. 결과를 보기 전에 정답과 채점 기준을 고정하고, 차이가 작든 크든 첫 응답에서 확인된 결과를 그대로 기록합니다.