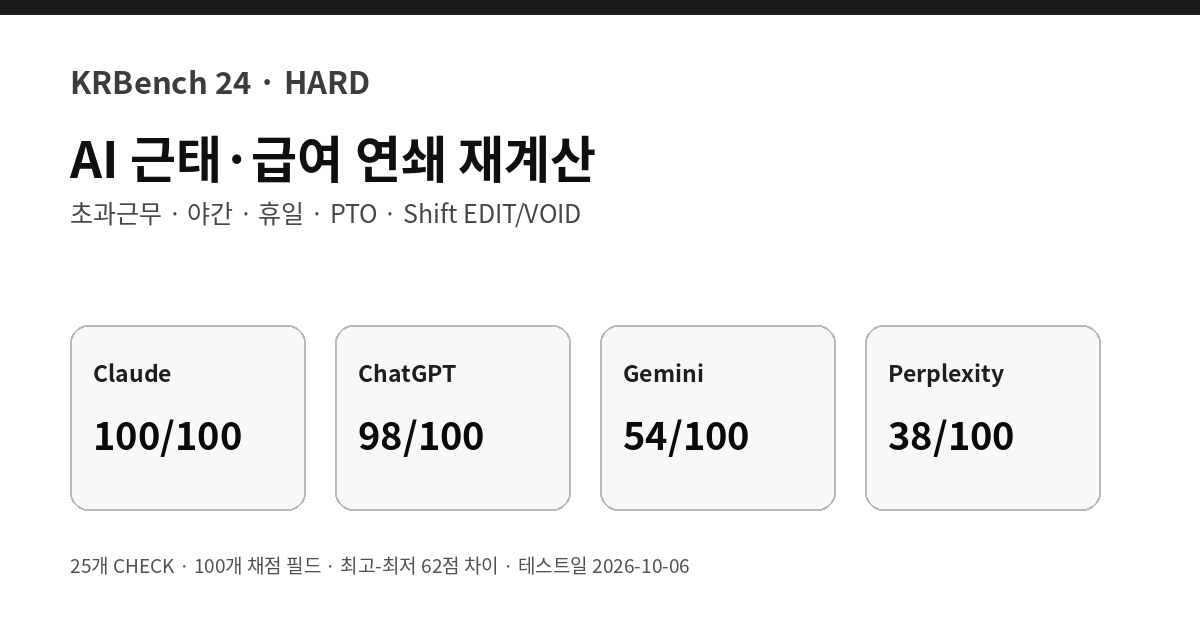
근태와 주간 급여 계산은 총 근무시간만 더한다고 끝나지 않습니다. Shift가 수정되거나 무효화되고, PTO가 별도로 남아 있고, 자정을 넘는 근무에 야간·휴일 프리미엄이 겹치면 앞선 이벤트를 정확히 유지한 채 다시 계산해야 합니다.
KRBench 24호에서는 직원 5명, 두 개의 주간 범위, 회사 지정 휴일 2일과 70개 순차 이벤트를 사용했습니다. 공식 채점은 C01~C25의 WorkHours, OvertimeHours, NightHours, GrossPayKRW 네 필드, 총 100점입니다.
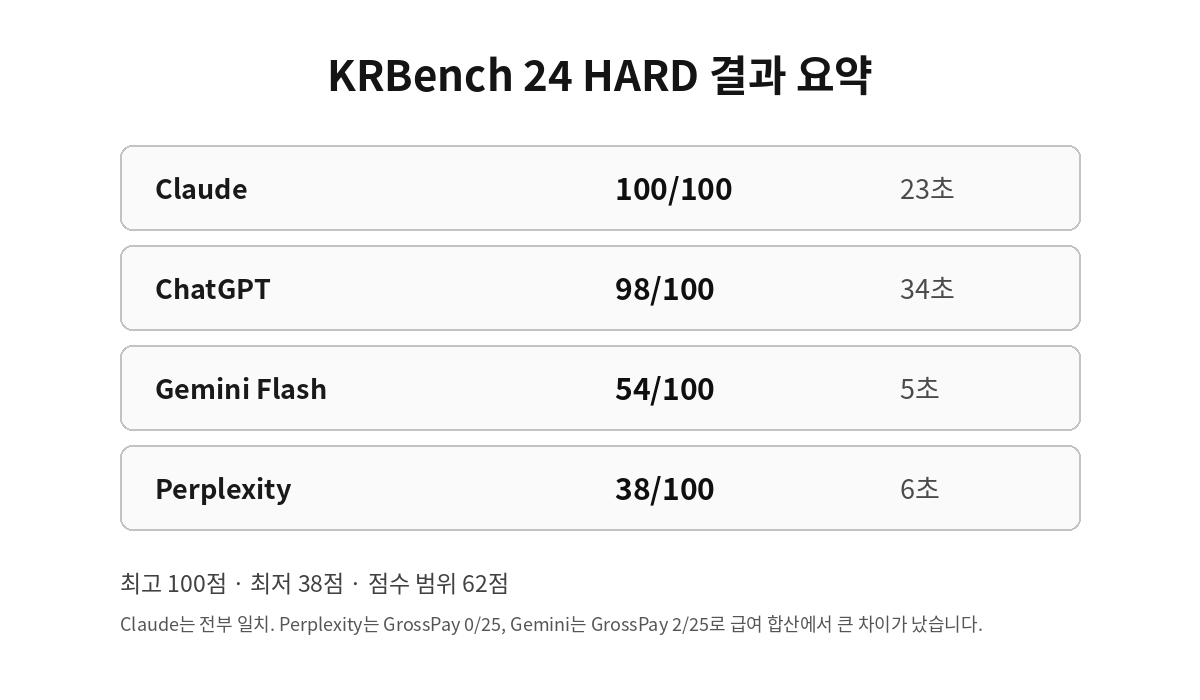
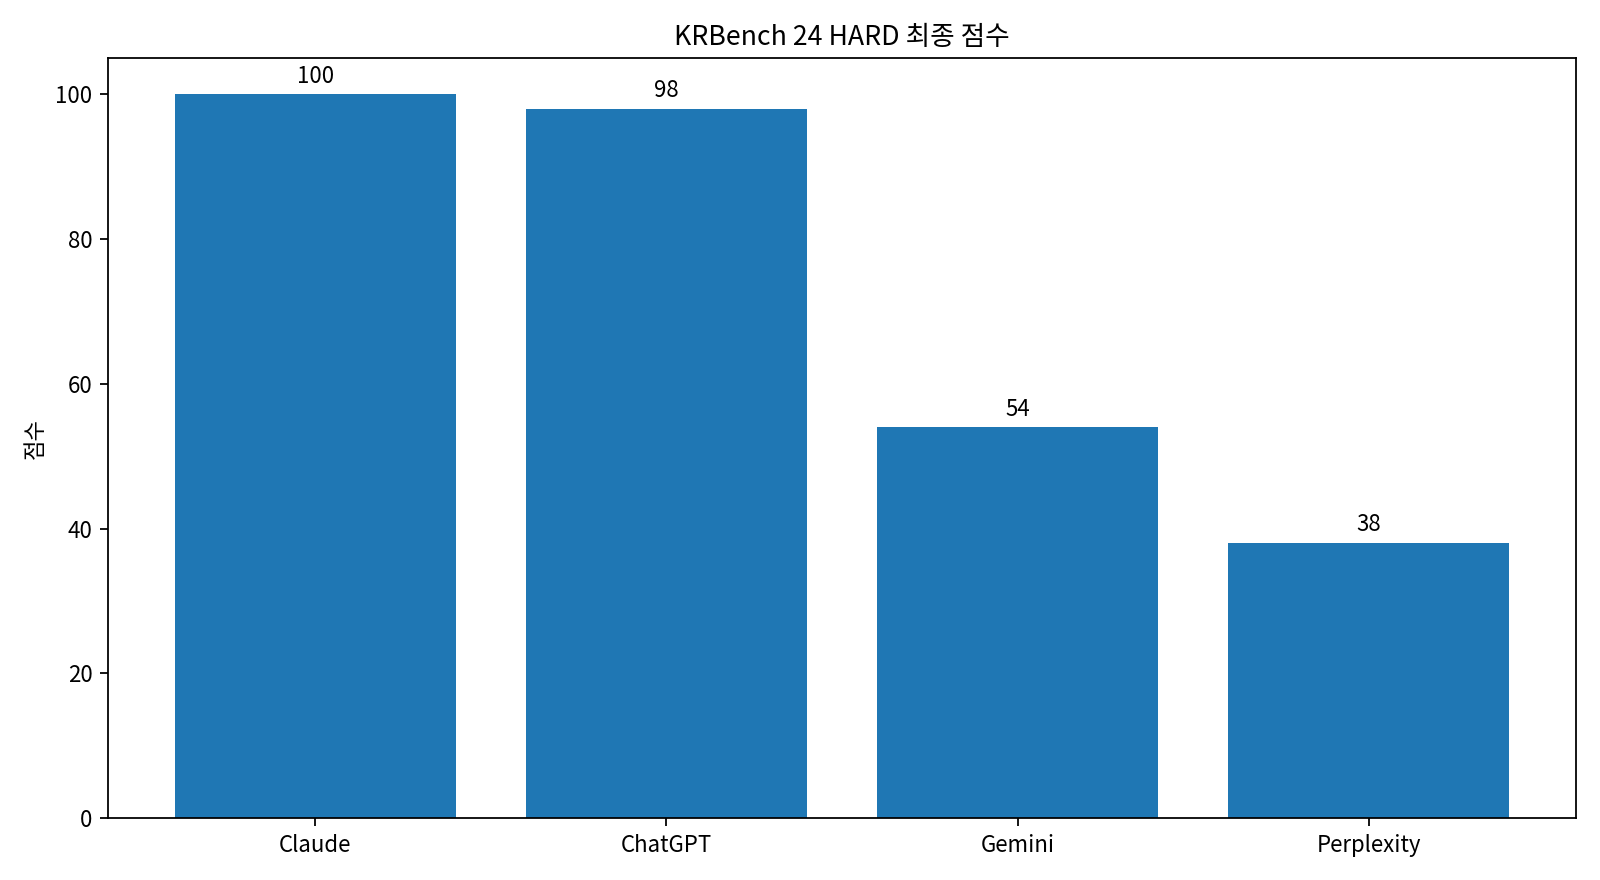
결과 요약
- Claude Sonnet 5.5 · 중간: 100/100 · 23초
- ChatGPT: 98/100 · 34초
- Gemini Flash: 54/100 · 5초
- Perplexity: 38/100 · 6초
- 최고점과 최저점의 차이는 62점이었습니다.
테스트 방법: 시간 종류를 따로 추적한 뒤 급여에서 중첩
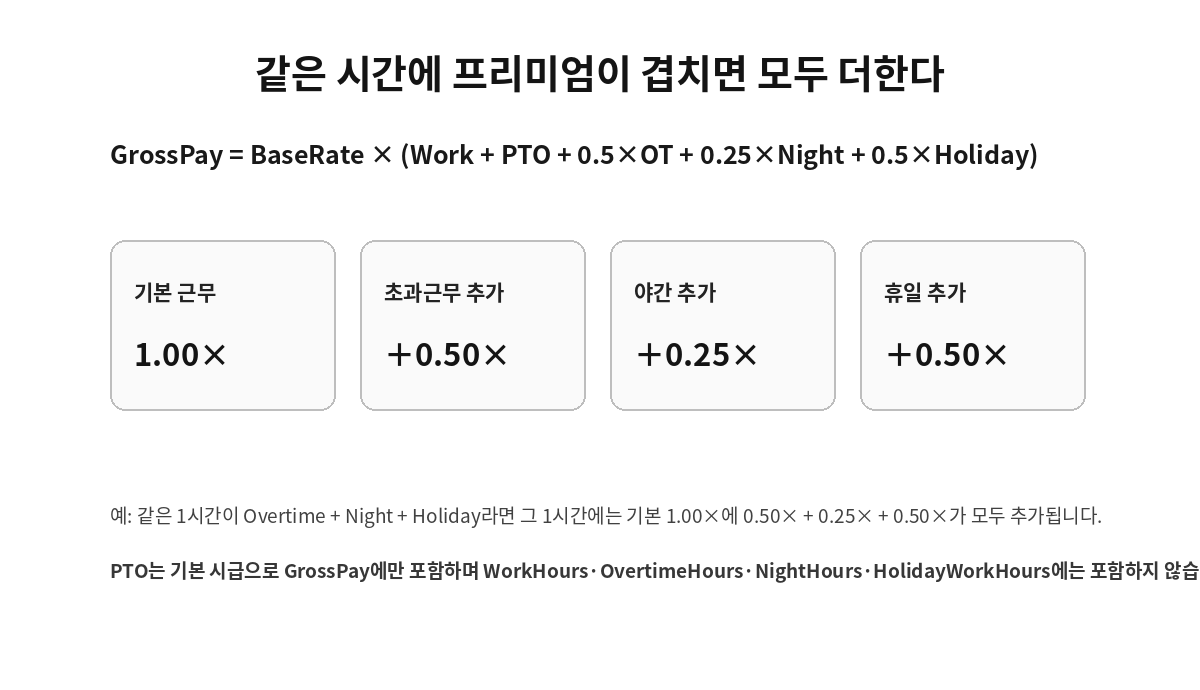
WorkHours는 활성 Shift의 Start~End에서 무급 Break를 뺀 실제 근무시간입니다. 같은 주의 실제 근무시간이 40시간을 넘는 시점부터 OvertimeHours가 발생하며, PTO는 이 40시간 기준에 포함하지 않았습니다.
NightHours는 실제 시각 기준 22:00~06:00, HolidayWorkHours는 회사 지정 휴일의 실제 달력 날짜 00:00~24:00에 수행한 근무시간입니다. 자정을 넘는 Shift도 야간·휴일 시간은 실제 시간 구간으로 나눠 계산했습니다.
초과근무·야간·휴일 프리미엄은 서로 겹칠 수 있다
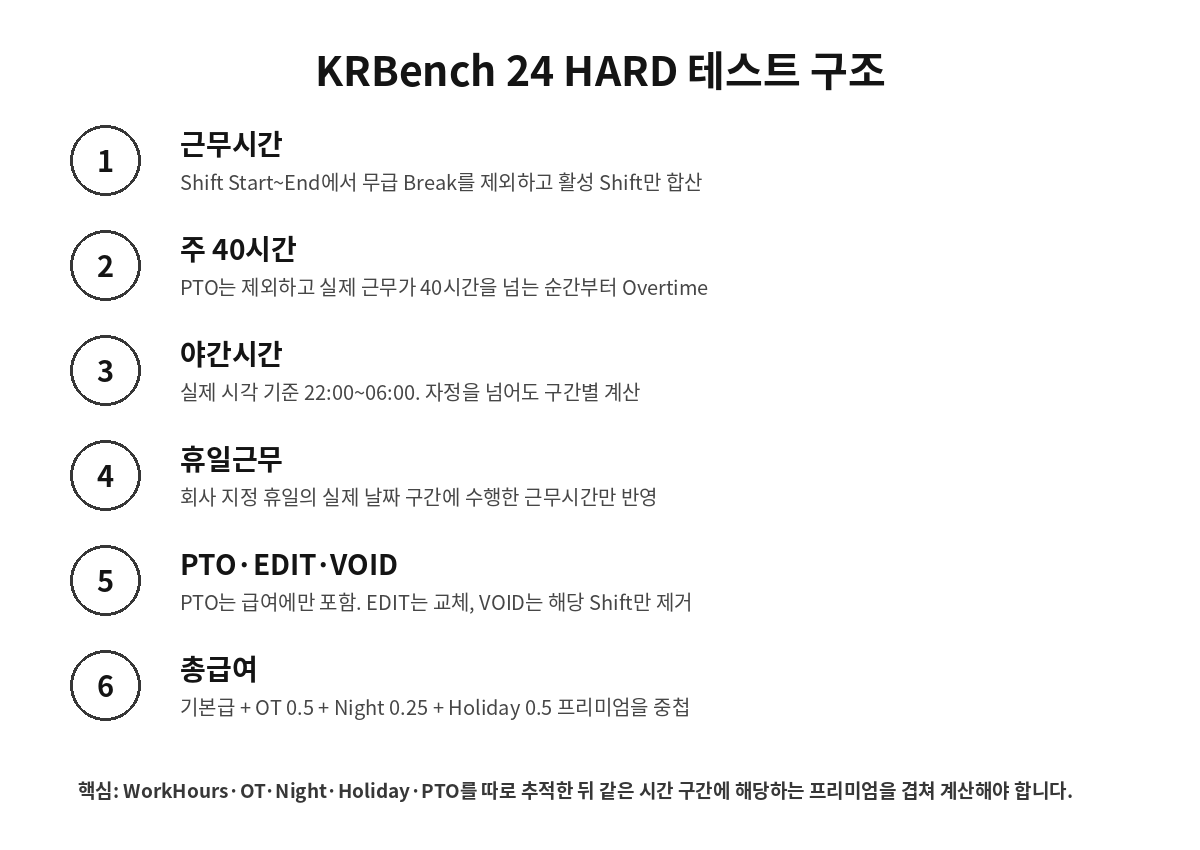
이번 테스트의 GrossPayKRW는 다음 식으로 고정했습니다.
BaseRate × (WorkHours + PTOHours + 0.5×OvertimeHours + 0.25×NightHours + 0.5×HolidayWorkHours)
같은 근무시간이 초과근무이면서 야간이고 동시에 회사 지정 휴일에 걸리면 해당 프리미엄은 모두 중첩합니다. PTO는 기본 시급으로 GrossPay에 포함하지만 WorkHours, OvertimeHours, NightHours, HolidayWorkHours에는 포함하지 않았습니다.
EDIT는 교체하고 VOID는 제거하지만 PTO는 별도 상태다
EDIT_SHIFT는 같은 Shift ID의 기존 내용을 완전히 교체합니다. VOID_SHIFT 이후에는 그 Shift를 근무시간 계산에서 제외합니다. 반면 이미 등록된 PTO는 별도 VOID_PTO가 없다면 그대로 유효합니다.
이 구분은 ChatGPT가 놓친 두 CHECK에서 직접 변별 요소가 됐습니다. Shift가 제거됐다고 해서 별도로 존재하는 PTO까지 사라지는 것은 아닙니다.
채점 기준: 25개 CHECK × 4개 필드 = 100점
| 항목 | CHECK당 | 총 배점 |
|---|---|---|
| WorkHours | 1점 | 25점 |
| OvertimeHours | 1점 | 25점 |
| NightHours | 1점 | 25점 |
| GrossPayKRW | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
40과 40.0처럼 값이 같은 숫자 표기는 동등하게 처리했습니다. 숨은 정답과 채점 기준은 서비스 결과를 보기 전에 결정론적 시간구간 계산 엔진으로 생성해 고정했고, 이벤트별 상태와 CHECK 계산 결과도 Oracle trace로 보존했습니다.
전체 결과: Claude 100점, Perplexity 38점
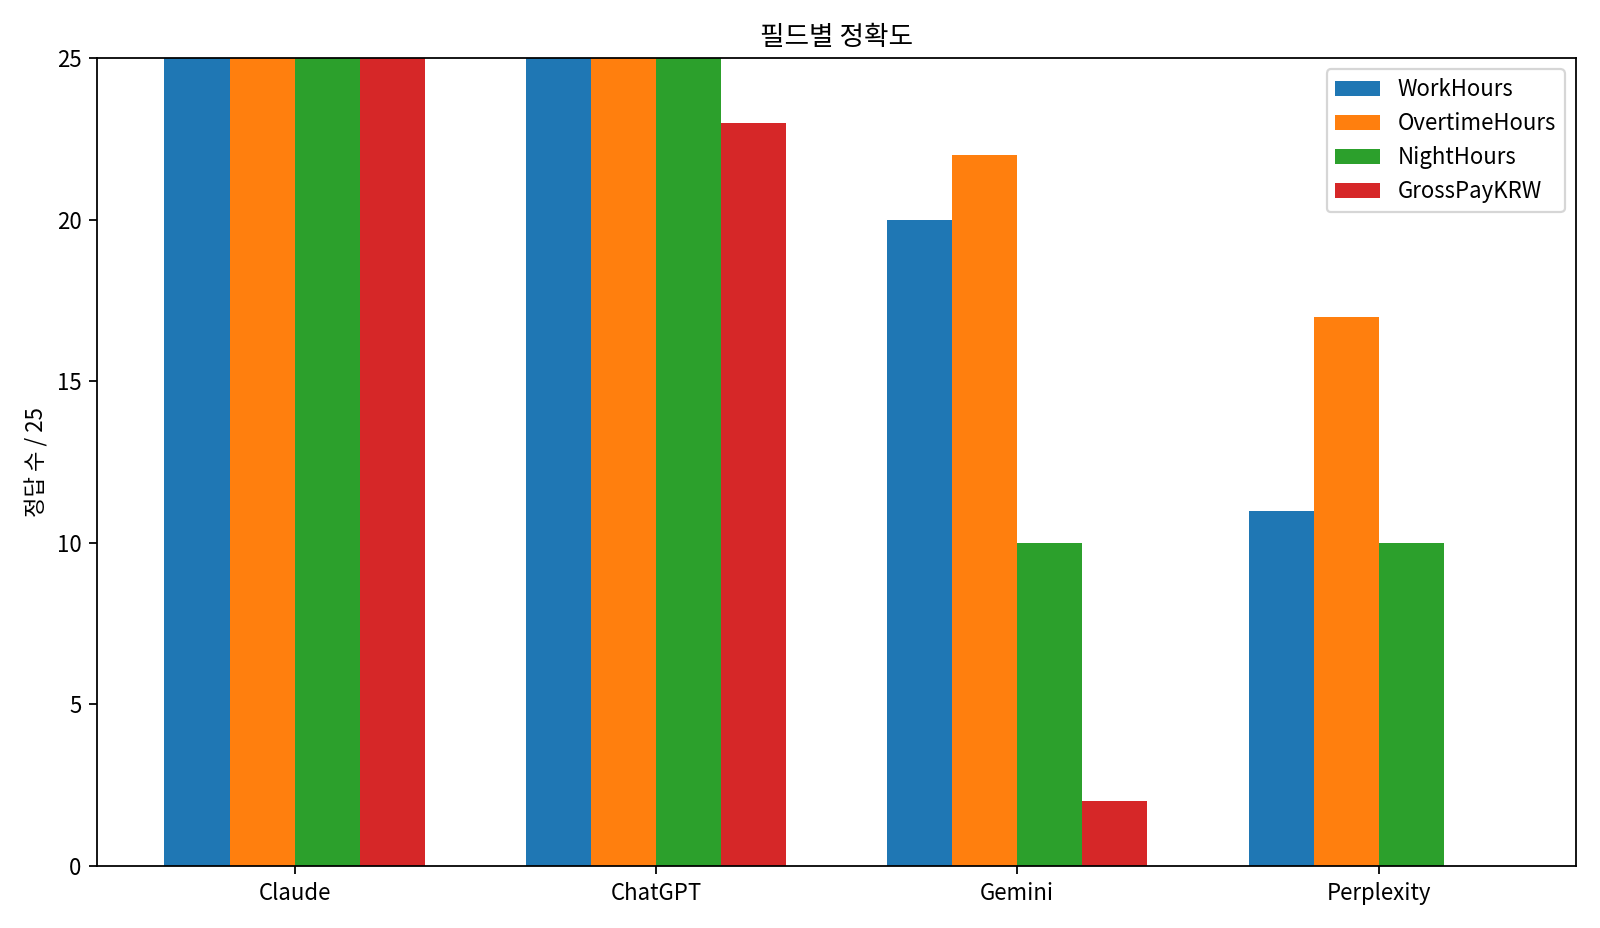
| 서비스 | WorkHours | OvertimeHours | NightHours | GrossPayKRW | 총점 | 응답시간 |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 · 중간 | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 23초 |
| ChatGPT | 25/25 | 25/25 | 25/25 | 23/25 | 98/100 | 34초 |
| Gemini Flash | 20/25 | 22/25 | 10/25 | 2/25 | 54/100 | 5초 |
| Perplexity | 11/25 | 17/25 | 10/25 | 0/25 | 38/100 | 6초 |
Claude: 100개 채점 필드 모두 일치
Claude Sonnet 5.5 · 중간은 C01~C25의 네 필드를 모두 맞혀 100점을 기록했습니다. 자정을 넘는 야간 Shift, 40시간 경계에서 Shift 일부만 Overtime이 되는 경우, 회사 지정 휴일과 야간·초과근무 프리미엄 중첩, PTO와 Shift 상태 분리를 모두 사전 Oracle과 동일하게 계산했습니다.
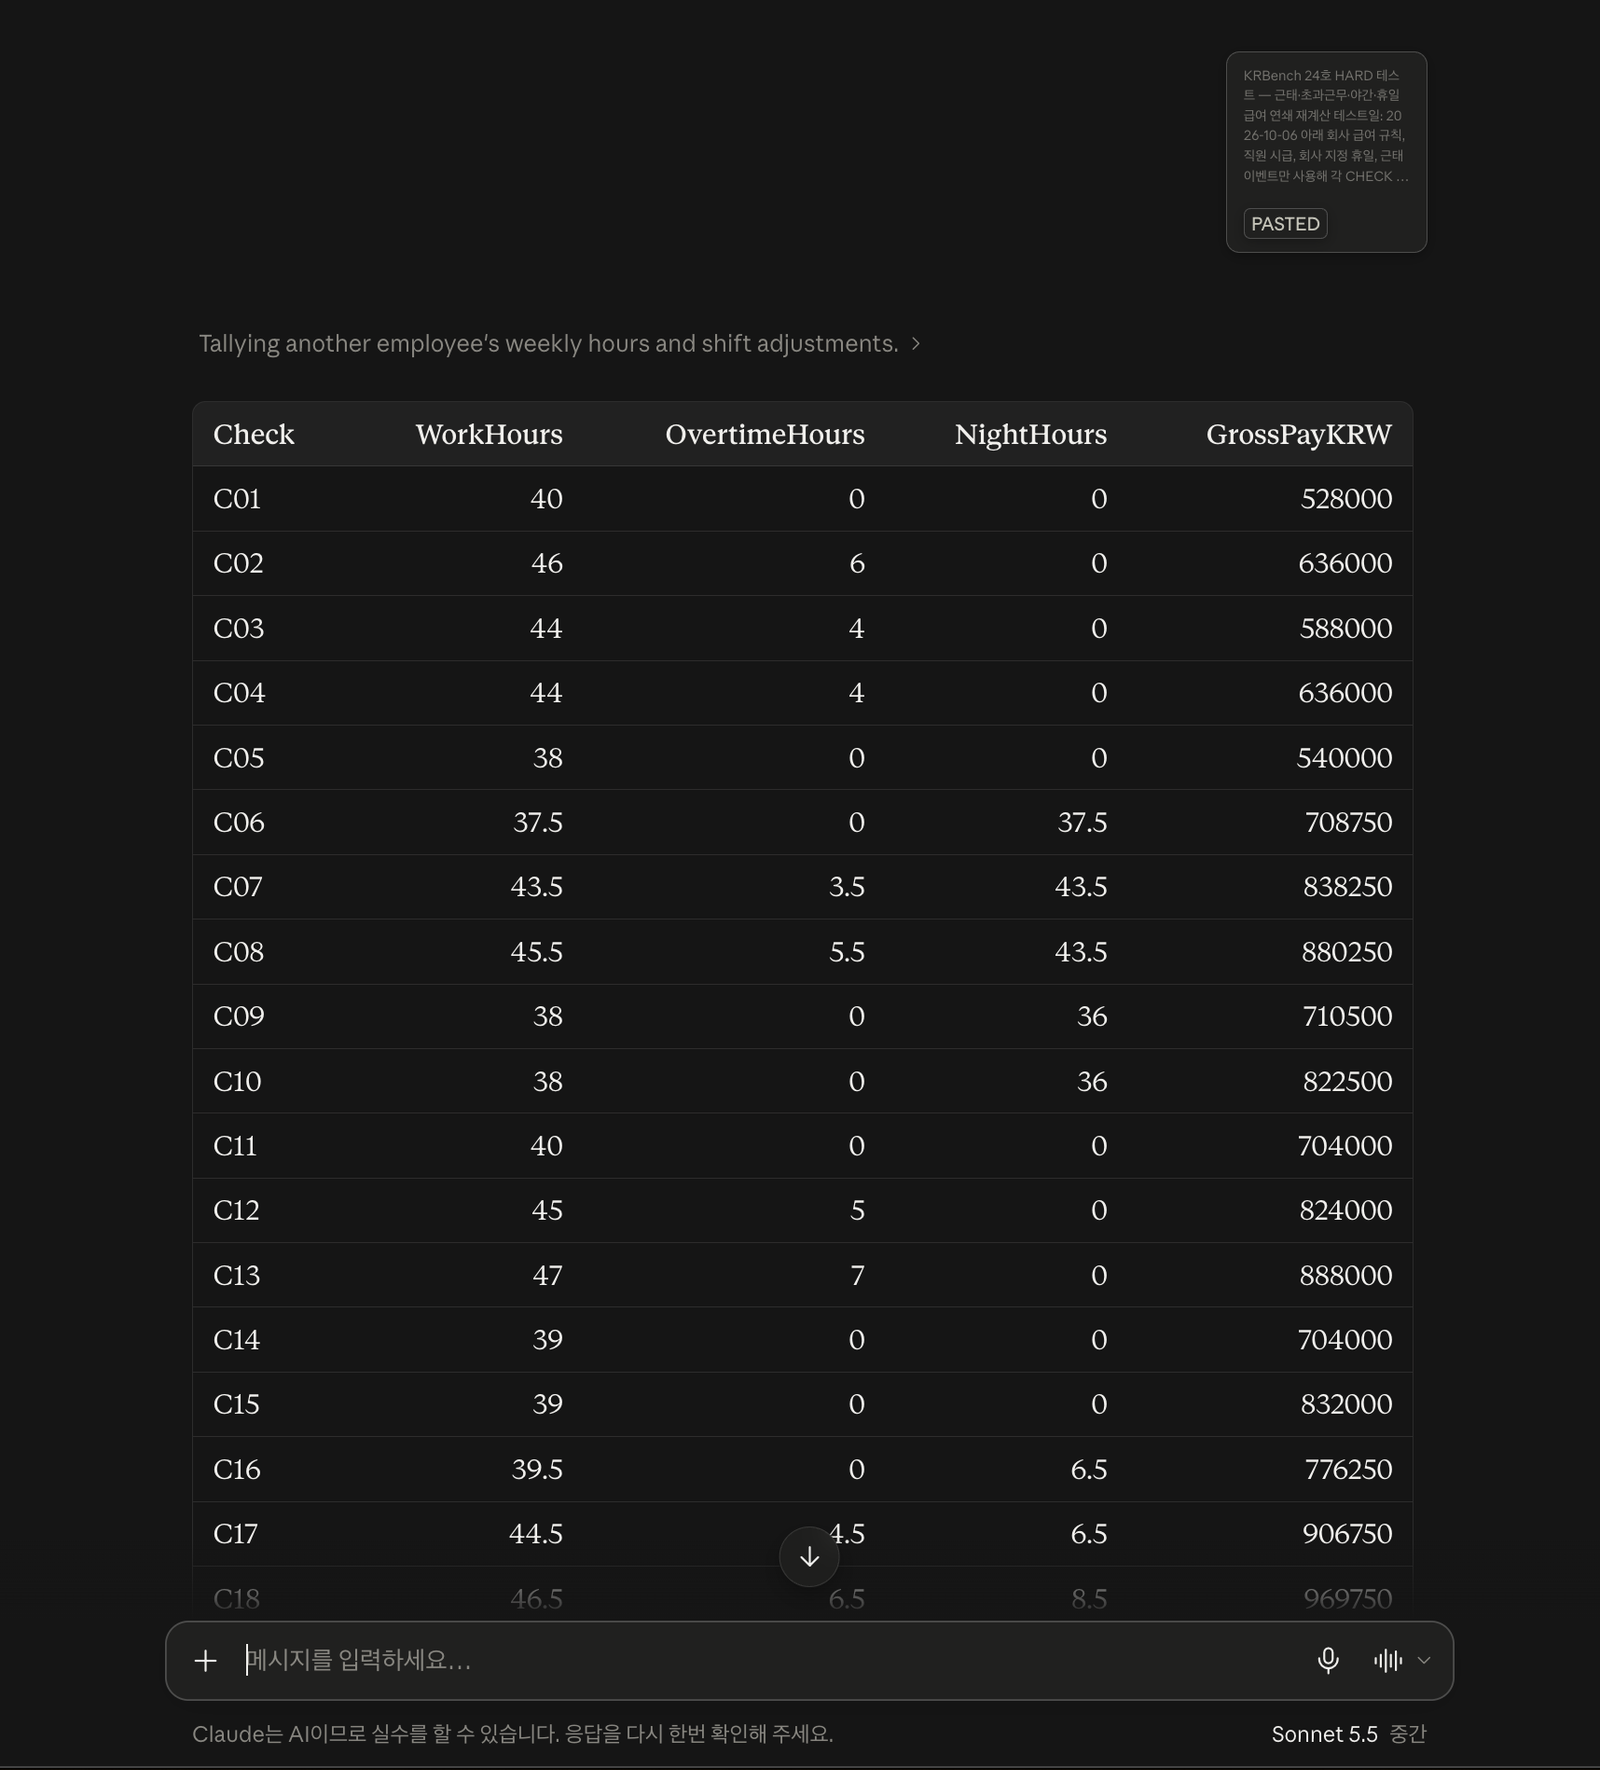
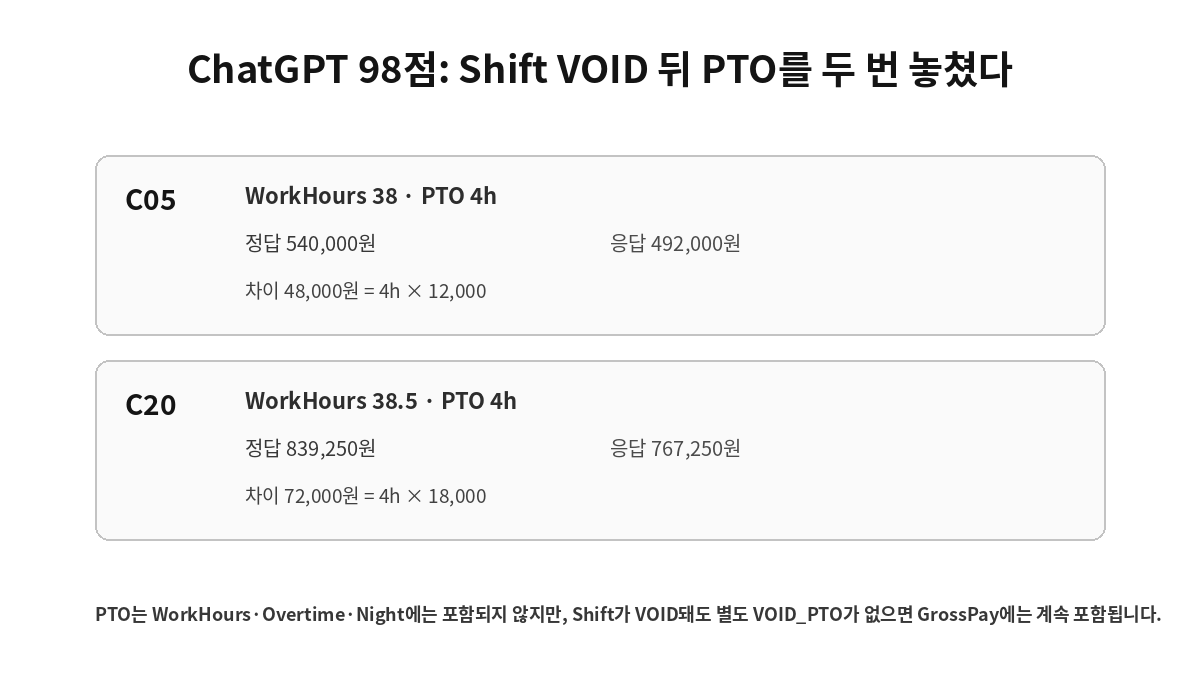
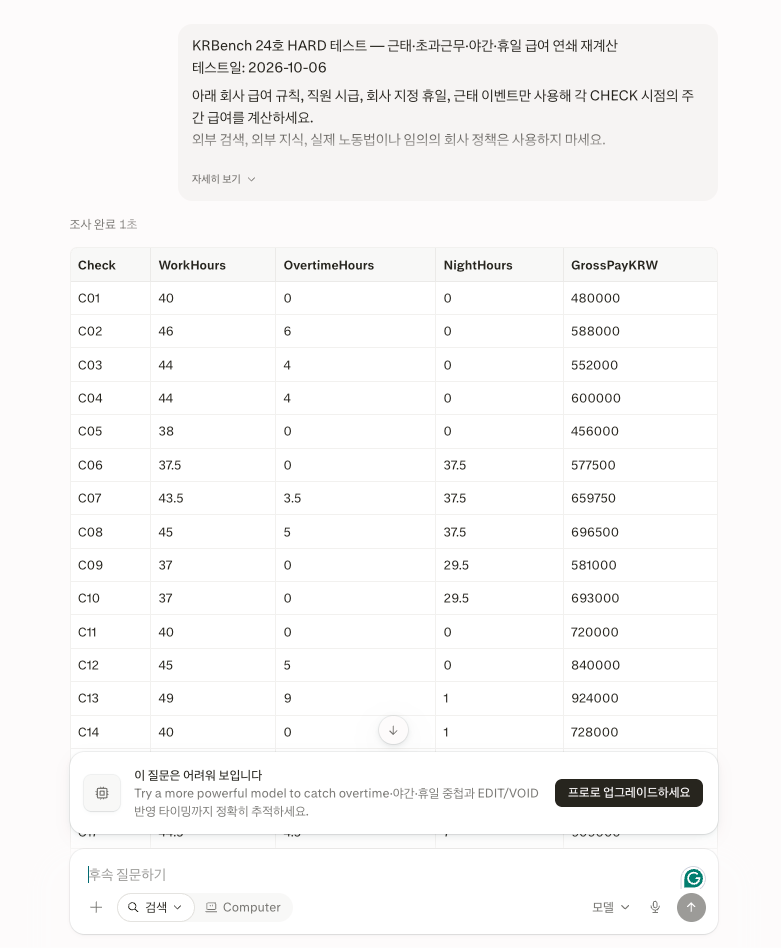
ChatGPT 98점: 시간 계산은 전부 맞고 PTO 급여 두 건만 누락
ChatGPT는 WorkHours, OvertimeHours, NightHours를 각각 25/25로 모두 맞혔습니다. 차이는 C05와 C20의 GrossPayKRW 두 필드뿐이었습니다.
C05에서는 PTO 4시간을 추가한 뒤 S106 Shift를 VOID했습니다. Shift는 제거되지만 PTO101은 그대로 활성 상태이므로 급여에 4시간 × 12,000원 = 48,000원이 남아야 합니다. 사전 정답은 540,000원이지만 ChatGPT는 492,000원을 출력했습니다.
C20도 같은 형태입니다. PTO401 4시간은 유지되므로 72,000원이 급여에 남아야 하지만, ChatGPT는 이를 제외해 839,250원 대신 767,250원을 출력했습니다.
Gemini 54점: 야간시간과 최종 급여에서 큰 차이
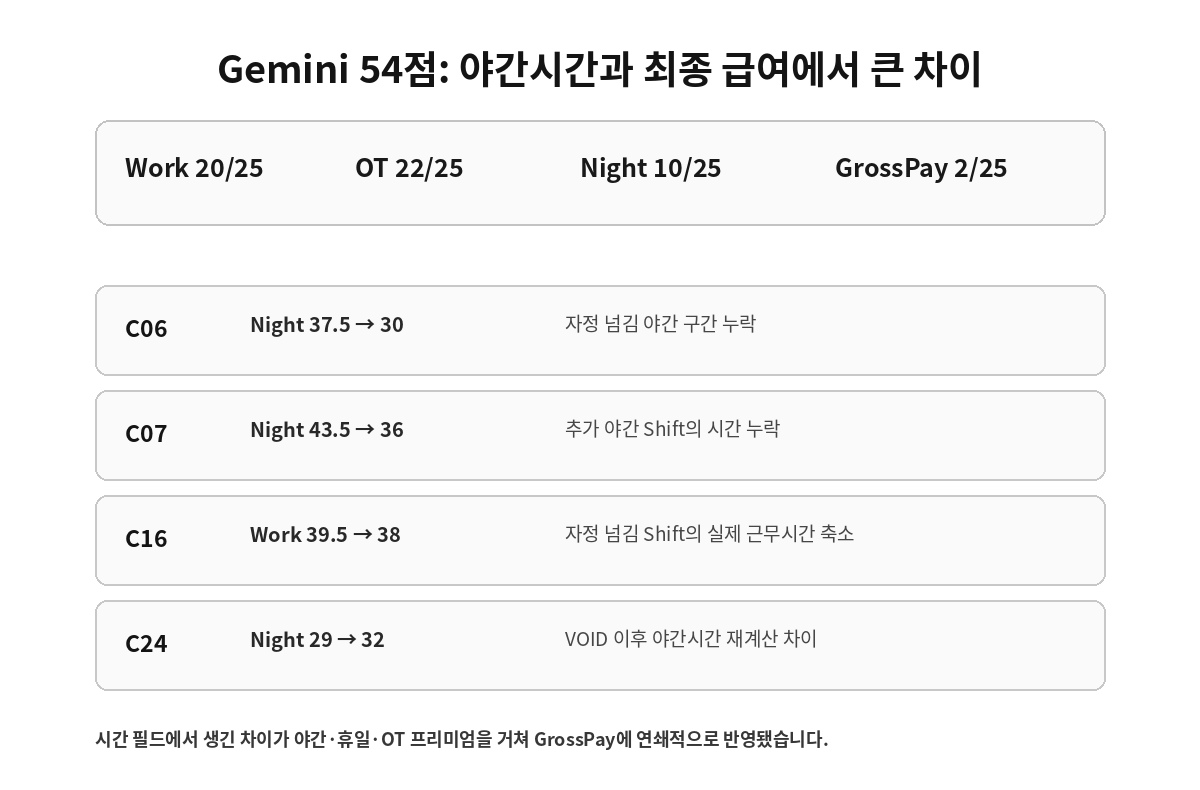
Gemini Flash는 WorkHours 20/25, OvertimeHours 22/25로 기본 근무시간과 초과근무는 상대적으로 높은 정확도를 보였습니다. 반면 NightHours는 10/25, GrossPayKRW는 2/25였습니다.
C06의 경우 WorkHours 37.5시간과 OvertimeHours 0시간은 정확했지만 NightHours를 사전 정답 37.5시간보다 낮은 30시간으로 계산했습니다. C07도 WorkHours와 OvertimeHours는 맞았지만 NightHours는 43.5시간 대신 36시간이었습니다.
E04 구간인 C16~C20에서는 WorkHours 자체도 계속 1.5시간 작게 계산됐고, 후반부에는 Shift VOID 이후 야간시간 재계산에서도 차이가 나타났습니다. 이런 시간 필드 차이가 각종 프리미엄을 거쳐 최종 GrossPay에 연쇄적으로 반영됐습니다.
Perplexity 38점: 모든 CHECK에서 하나 이상 차이
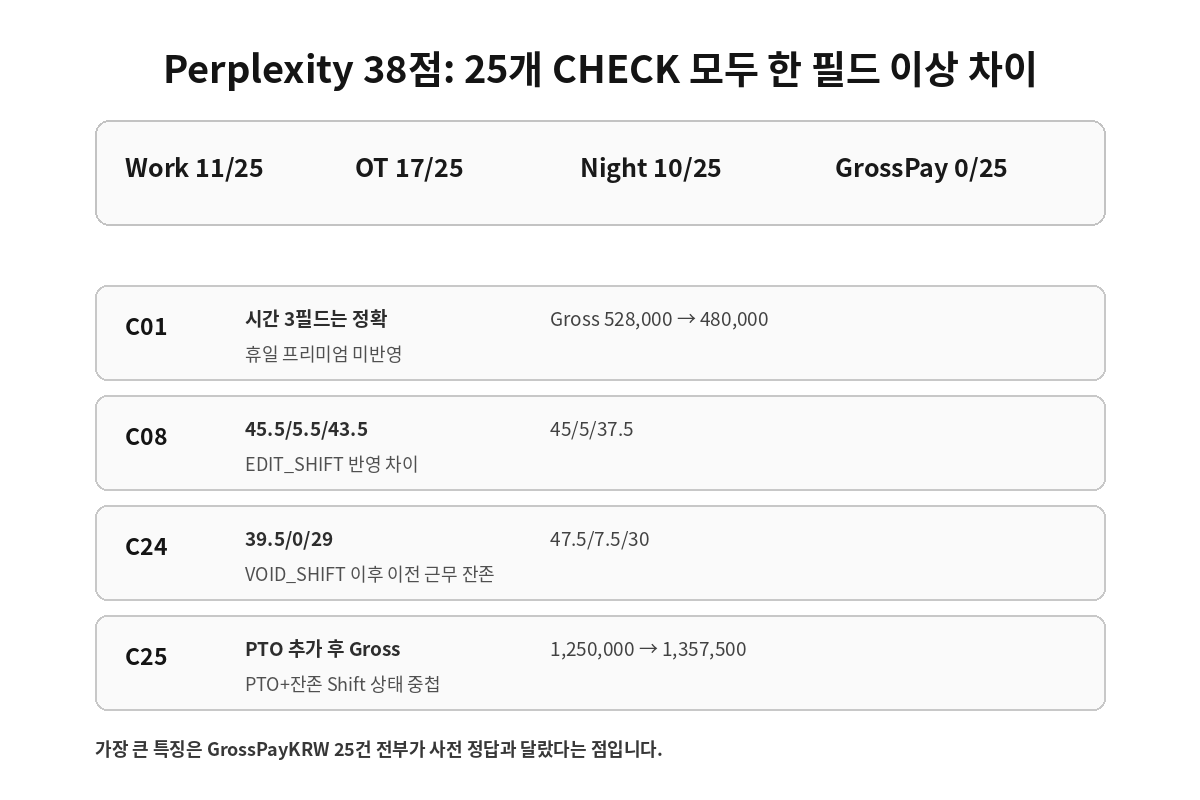
Perplexity는 WorkHours 11/25, OvertimeHours 17/25, NightHours 10/25, GrossPayKRW 0/25로 총 38점을 기록했습니다. 25개 CHECK 모두에서 적어도 한 필드가 사전 정답과 달랐습니다.
C01처럼 WorkHours, OvertimeHours, NightHours를 모두 맞힌 경우에도 GrossPay는 사전 정답 528,000원 대신 480,000원이었습니다. 즉 시간 집계가 정확한 CHECK에서도 휴일 프리미엄을 포함한 최종 급여식 적용에서 차이가 있었습니다.
후반부에는 상태 추적 차이도 커졌습니다. C24의 사전 정답은 WorkHours 39.5, OvertimeHours 0, NightHours 29이지만 Perplexity는 47.5, 7.5, 30으로 출력했습니다. 직전 VOID_SHIFT 이후 제거되어야 할 근무가 뒤 계산에 남은 형태와 일치하는 결과입니다.
응답시간: 5초부터 34초
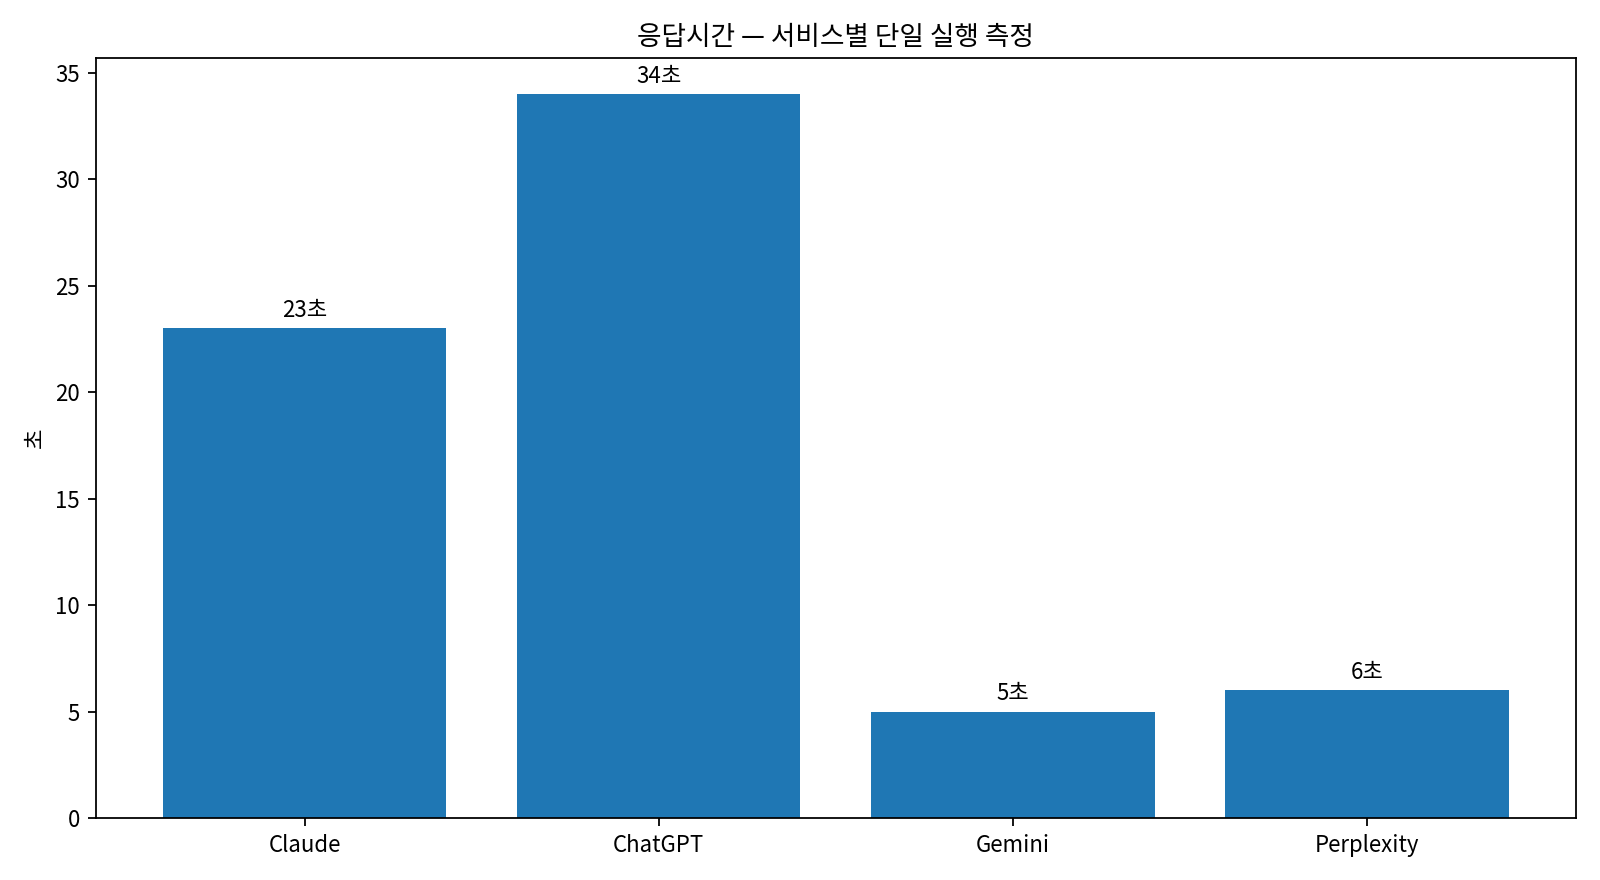
실측 응답시간은 Gemini 5초, Perplexity 6초, Claude 23초, ChatGPT 34초였습니다. 각 서비스에서 한 번만 측정한 값이므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
ChatGPT 화면에는 내부 처리시간으로 28초가 표시됐지만, 공식 기록은 다른 서비스와 동일하게 사용자가 전송 후 최종 답변이 화면에 모두 출력될 때까지 직접 측정한 34초를 사용했습니다.
NotebookLM은 공식 비교에서 제외
이번 테스트는 문서에서 정보를 검색하는 작업이 아니라 하나의 긴 근태 이벤트 스트림을 순서대로 처리하고 매 CHECK마다 다시 계산하는 일반 채팅형 상태 문제입니다. NotebookLM은 다른 서비스와 동일한 일반 채팅 입력 경로를 맞추기 어려워 공식 비교에서 제외했습니다.
24호에서 확인된 점
이번 조건에서는 WorkHours 하나를 맞히는 것과 최종 급여를 맞히는 것 사이에 큰 차이가 있었습니다. 야간·휴일·초과근무 시간을 서로 독립적으로 추적하고, 겹치는 시간에는 프리미엄을 동시에 적용하며, PTO는 별도 상태로 유지해야 최종 GrossPay까지 맞힐 수 있었습니다.
Claude는 100개 필드를 모두 맞혔고 ChatGPT도 98점이었지만, Gemini와 Perplexity에서는 시간 구간 해석과 상태 변경이 최종 급여까지 연쇄적으로 확대됐습니다. 이번 테스트의 최고·최저 점수 차이는 62점이었습니다.
이번 테스트의 한계
- 실제 노동법이나 실제 기업의 급여 규칙이 아니라 KRBench가 만든 합성 회사 정책입니다.
- 직원은 5명이고 테스트 범위는 두 주로 제한했습니다.
- 세금, 4대보험, 월급제, 주휴수당, 실제 법정 휴일 규칙, 교대수당 등은 포함하지 않았습니다.
- 회사 지정 휴일과 프리미엄 배율은 테스트를 위해 명시적으로 고정한 가상 규칙입니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
관련 KRBench 테스트
발주·입고·반품·Credit·Void가 이어지면 AI가 최종 Invoice 지급액을 정확히 계산할까?
8개 PO의 순차 이벤트와 25개 Invoice CHECK로 승인 여부, 지급액, 잔여 PO 수량, 거절 사유를 비교했습니다.
→ AI 3-way match 연쇄 정산 HARD 테스트 보기11호~20호 업무 벤치마크 10편을 한 번에 보면?
문서 근거, 규정 판단, 상태 추적, 일정·예산·계약 계산에서 반복된 오류 유형과 HARD 전환 전후를 중간결산으로 정리했습니다.
→ KRBench 업무 벤치마크 10편 중간결산 보기Source 무효화와 Downstream Lineage가 얽히면 AI가 최신 VALID 데이터 상태를 정확히 추적할까?
8개 Dataset의 RUN·INVALIDATE·RESTORE·backfill 이벤트와 25개 CHECK로 상태, 최신 Run, 나이, Root Source를 100점으로 비교했습니다.
→ AI 데이터 파이프라인 Lineage HARD 테스트 보기KRBench는 결과 차이가 크거나 작더라도 사전 정답과 채점 기준을 바꾸지 않고, 같은 조건에서 확인된 첫 응답을 그대로 기록합니다.