접근 권한 판정은 단순히 사용자와 권한표 한 줄을 비교하는 문제로 끝나지 않습니다. 사용자가 여러 그룹을 상속받고, 정책 우선순위가 바뀌고, 리소스가 다른 트리로 이동하고, Rule이 추가·회수되면 같은 사용자와 같은 Action이라도 CHECK 시점에 따라 결과가 달라질 수 있습니다.
KRBench 22호에서는 사용자·그룹·리소스·정책의 초기 상태와 45개 순차 이벤트를 하나의 상태 문제로 구성했습니다. 공식 채점은 C01~C25의 Decision, WinningRule, PrincipalMatch, ScopeMatch 네 필드, 총 100점입니다.
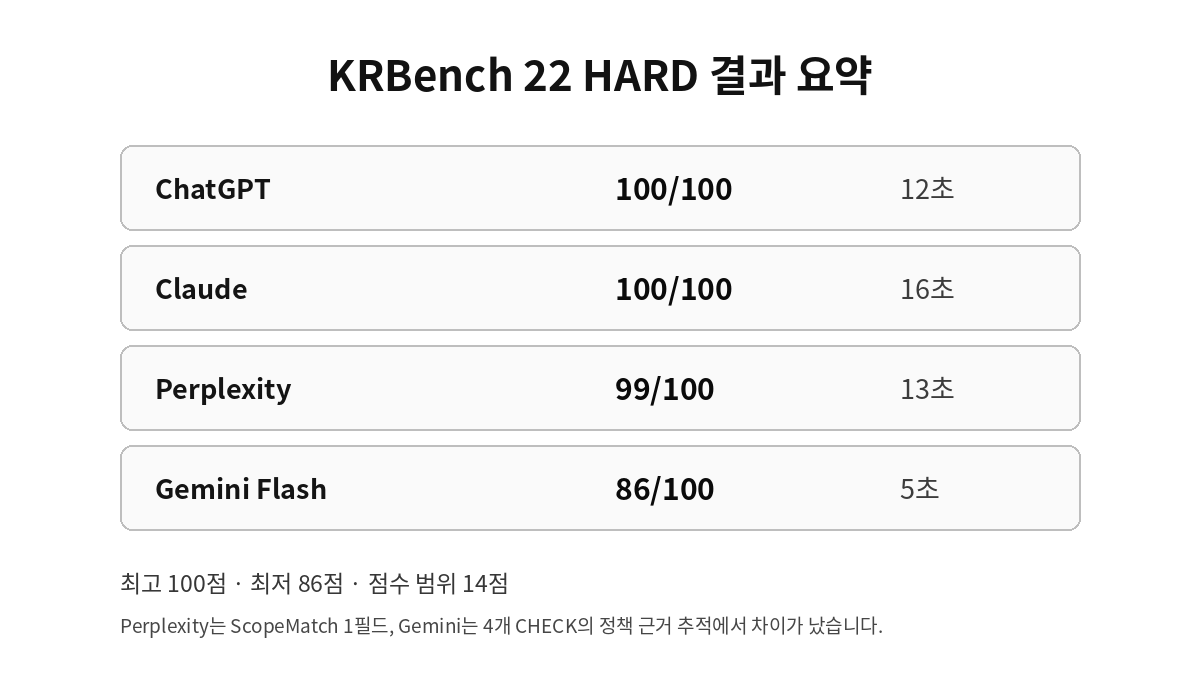
결과 요약
- ChatGPT: 100/100 · 12초
- Claude Sonnet 5.5 · 중간: 100/100 · 16초
- Perplexity: 99/100 · 13초
- Gemini Flash: 86/100 · 5초
- ChatGPT와 Claude는 100개 채점 필드가 모두 사전 Oracle과 일치했습니다.
테스트 방법: 접근 결정뿐 아니라 실제 승리한 Rule까지 추적
초기 데이터에는 사용자 8명, 그룹 8개, 직접 그룹 멤버십과 그룹 간 상속 관계, 리소스 트리, 활성 정책 Rule이 포함됩니다. 이후 사용자·그룹 변경, 사용자 DISABLE/ENABLE, Rule 추가·회수·Priority 변경, Resource 이동과 CHECK 이벤트를 Seq 순서대로 처리했습니다.
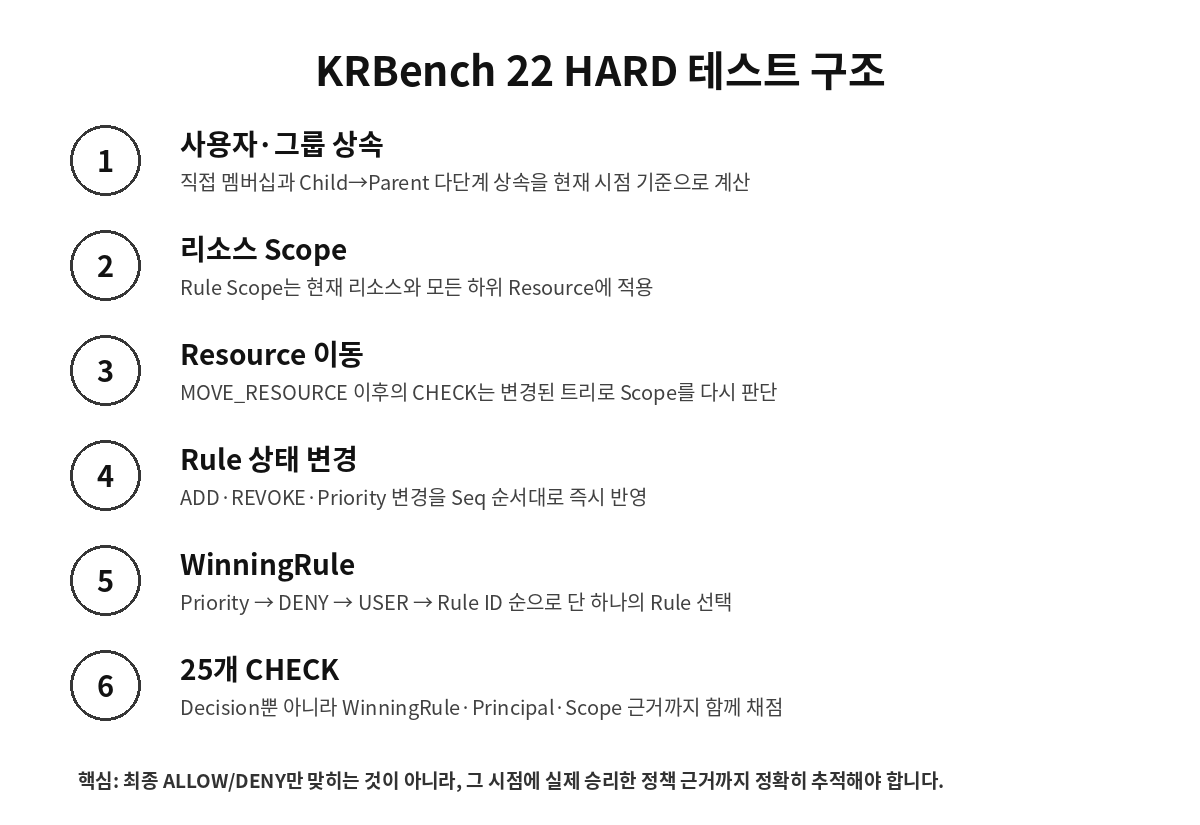
CHECK 시점에 적용 가능한 Rule이 여러 개라면 Priority가 큰 Rule → 같은 Priority에서는 DENY → USER Principal → Rule ID 사전순으로 하나의 WinningRule을 선택합니다. 사용자가 DISABLED라면 다른 정책보다 먼저 SYSTEM_DISABLED로 거절합니다.
이번 테스트는 최종 ALLOW 또는 DENY만 맞히면 끝나는 구조가 아닙니다. 실제로 선택된 Rule과 그 Rule이 어떤 Principal과 Scope로 적용됐는지까지 정확히 출력해야 합니다.
Resource가 이동하면 같은 Rule도 더 이상 적용되지 않을 수 있다
정책 Scope는 해당 Resource 자체와 현재 하위 Resource에 적용됩니다. 따라서 MOVE_RESOURCE 이벤트 뒤에는 과거 트리가 아니라 변경된 현재 리소스 트리를 사용해 Scope를 다시 판단해야 합니다.
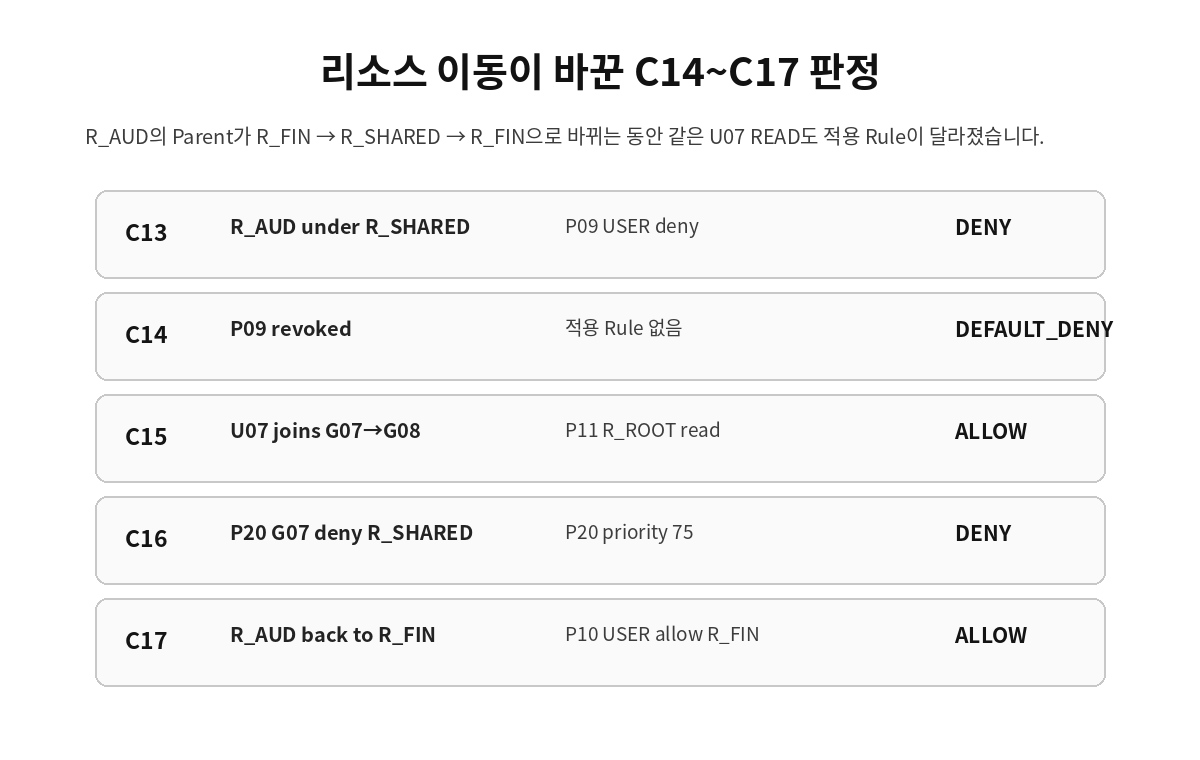
C14~C17 구간에서는 R_AUD가 R_SHARED 아래에 있다가 다시 R_FIN으로 이동합니다. 동시에 U07의 그룹 멤버십과 Rule도 바뀌어 DEFAULT_DENY, 그룹 상속 Rule, DENY Rule, USER ALLOW Rule이 순서대로 승자가 됩니다.
채점 기준: 25개 CHECK × 4개 필드 = 100점
| 항목 | CHECK당 | 총 배점 |
|---|---|---|
| Decision | 1점 | 25점 |
| WinningRule | 1점 | 25점 |
| PrincipalMatch | 1점 | 25점 |
| ScopeMatch | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
숨은 정답과 채점 기준은 서비스 결과를 보기 전에 결정론적 정책 엔진으로 생성해 고정했습니다. 사용자 상태, 그룹 멤버십, 그룹 상속, 리소스 트리와 활성 Rule의 시점별 상태도 Oracle trace로 보존했습니다.
전체 결과: 86점부터 100점
| 서비스 | Decision | WinningRule | PrincipalMatch | ScopeMatch | 총점 | 응답시간 |
|---|---|---|---|---|---|---|
| ChatGPT | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 12초 |
| Claude Sonnet 5.5 · 중간 | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 16초 |
| Perplexity | 25/25 | 25/25 | 25/25 | 24/25 | 99/100 | 13초 |
| Gemini Flash | 23/25 | 21/25 | 21/25 | 21/25 | 86/100 | 5초 |
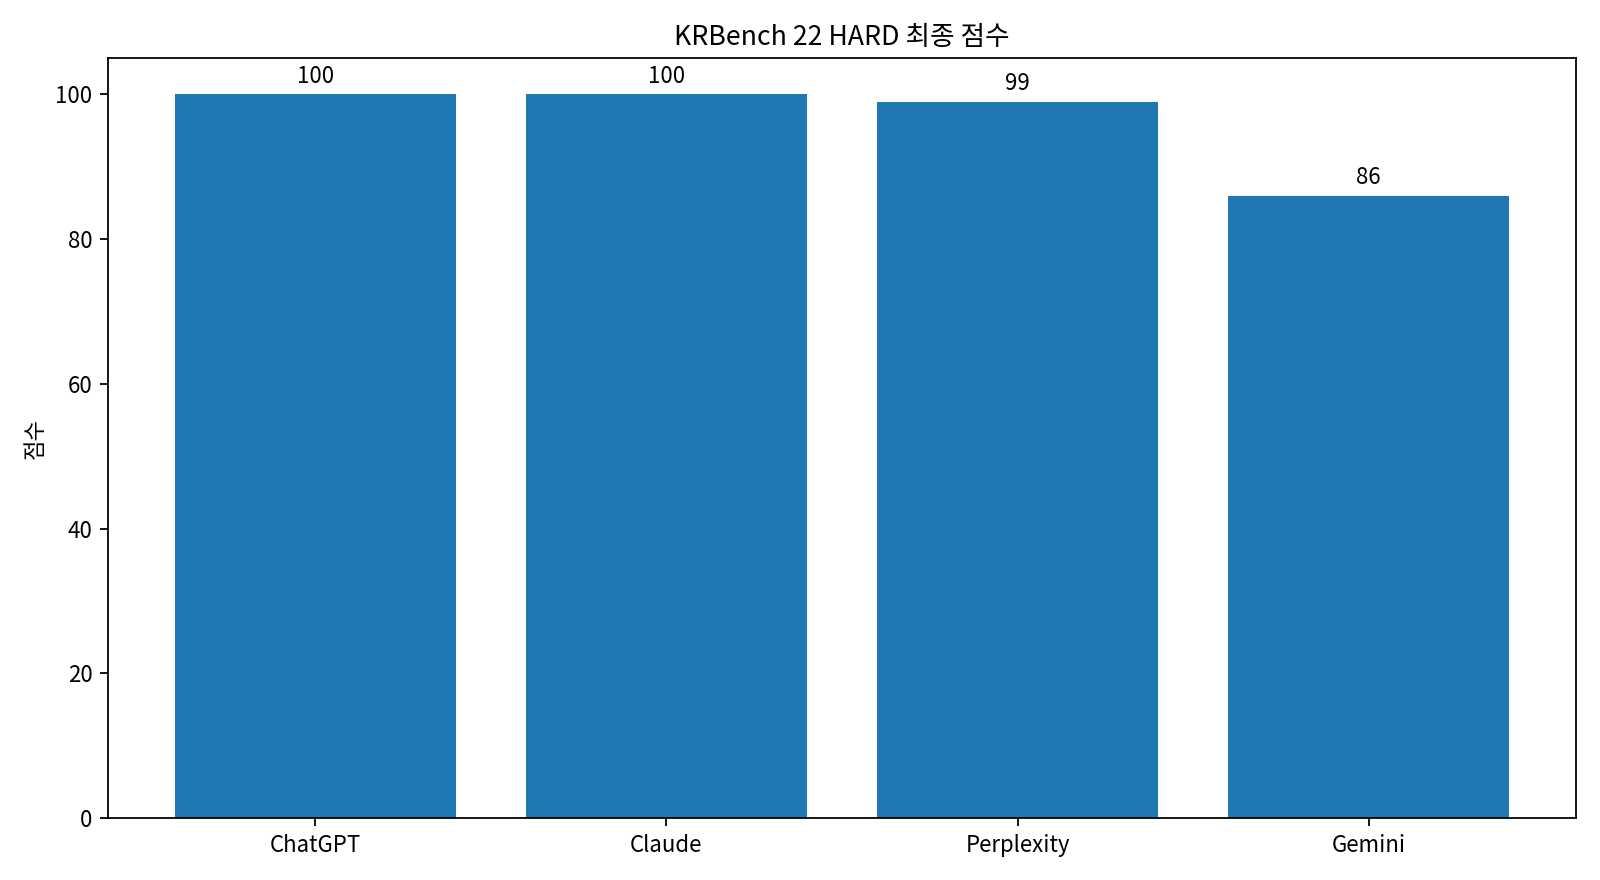
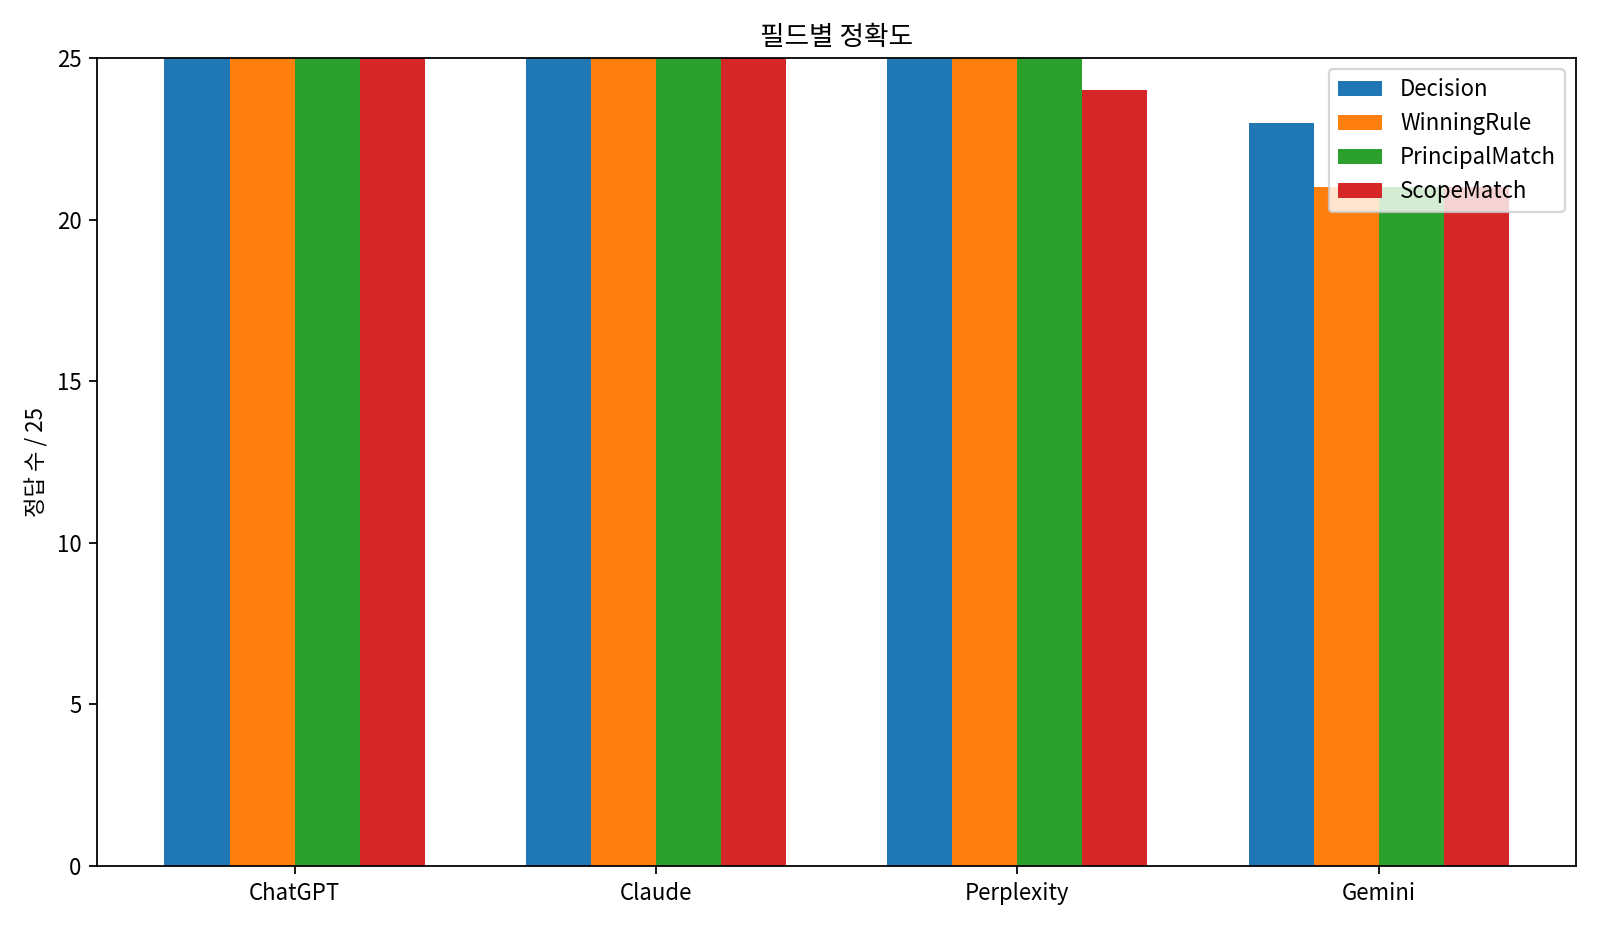
이번 테스트에서는 최종 Decision만 보면 네 서비스 모두 비교적 높은 정확도를 보였습니다. 하지만 실제 WinningRule과 Principal, Scope를 함께 요구하자 Gemini에서는 더 많은 차이가 나타났습니다.
ChatGPT: 100개 채점 필드 모두 일치
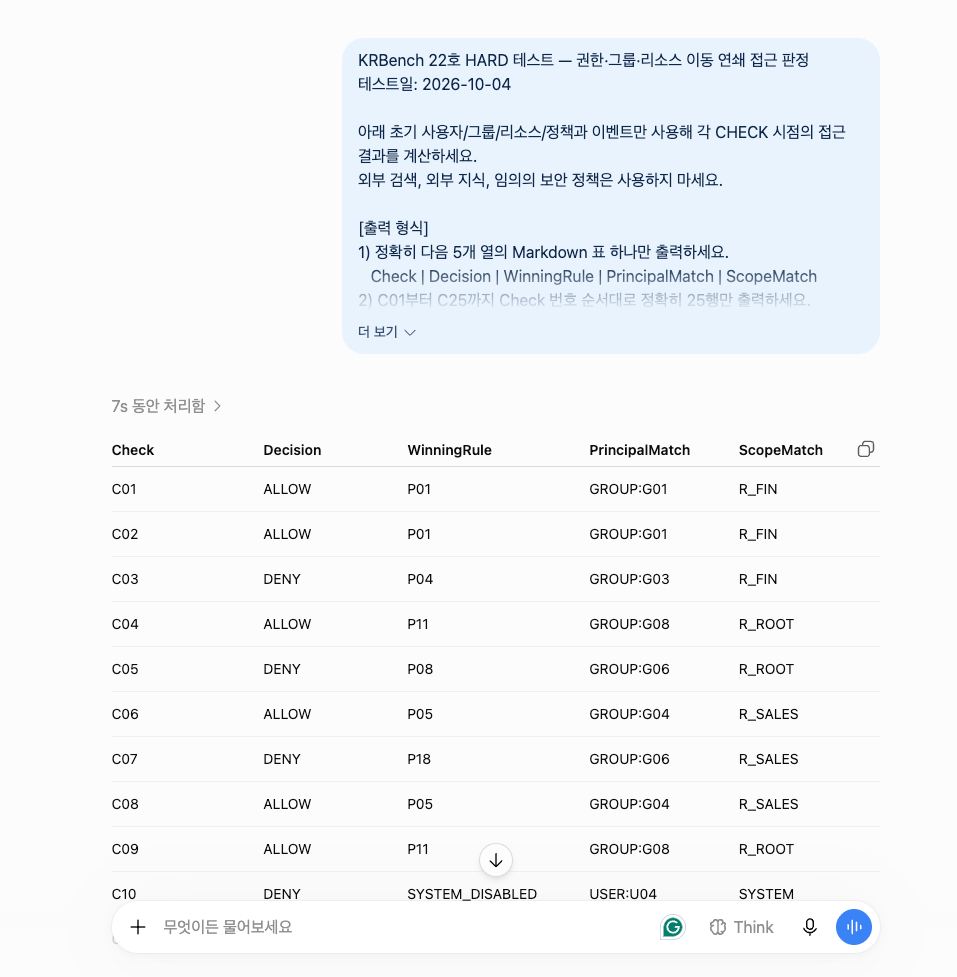
ChatGPT는 C01~C25의 Decision, WinningRule, PrincipalMatch, ScopeMatch를 모두 맞혀 100점을 기록했습니다. 그룹 상속과 사용자 비활성화, Resource 이동, Rule 회수·Priority 변경, DEFAULT_DENY까지 사전 Oracle과 일치했습니다.
Claude: 100점, 정책 근거까지 전부 일치
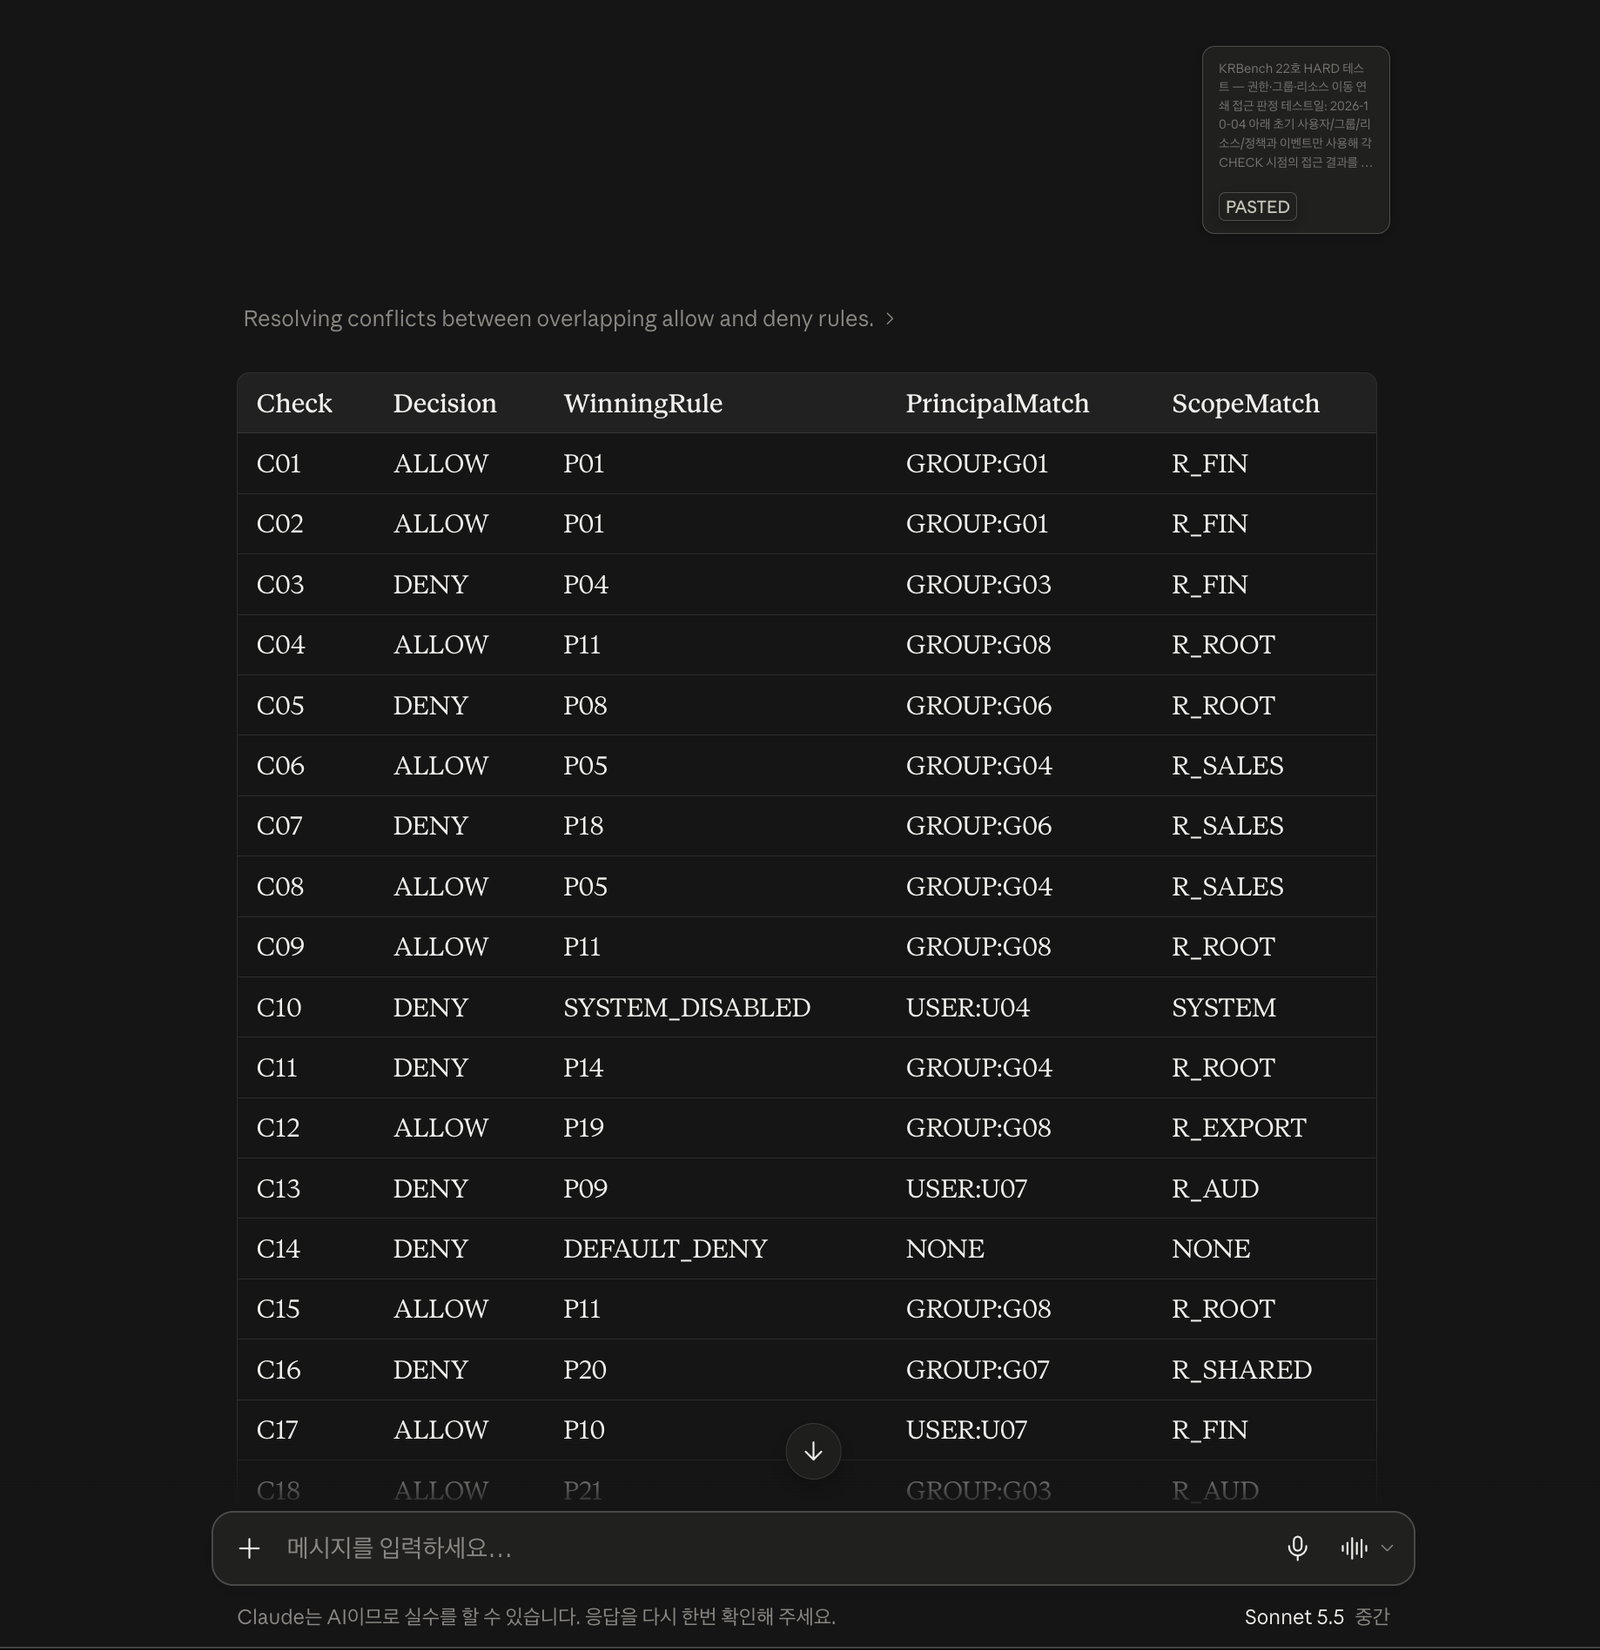
Claude Sonnet 5.5 · 중간도 100개 필드를 전부 맞혔습니다. 특히 C14의 DEFAULT_DENY, C15의 그룹 상속에 따른 P11, C19의 Priority 변경 뒤 P04, C22의 그룹 변경 직전 DEFAULT_DENY까지 모두 정확했습니다.
Perplexity 99점: Decision과 WinningRule은 25건 모두 정확
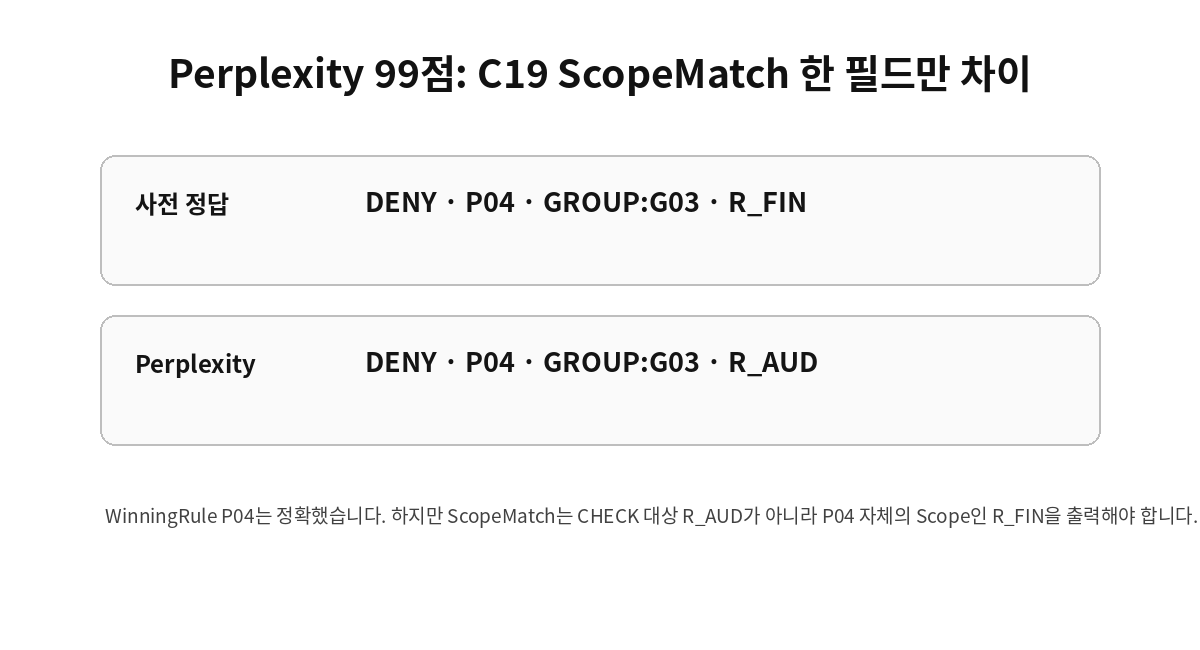
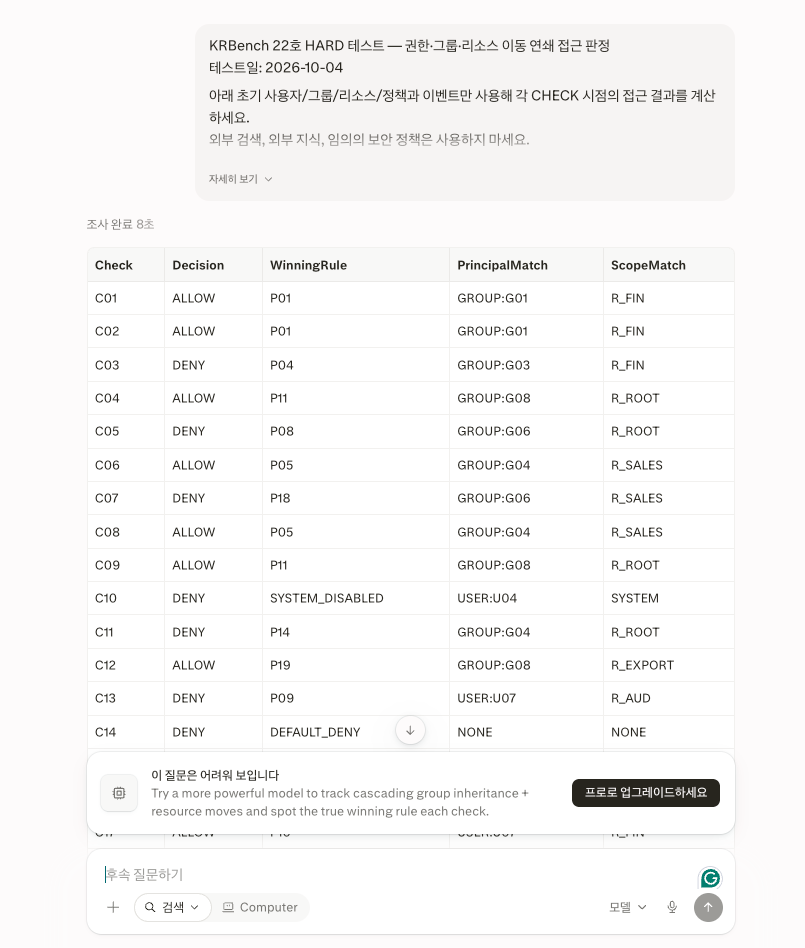
Perplexity는 Decision, WinningRule, PrincipalMatch를 25개 모두 맞혔습니다. 차이는 C19의 ScopeMatch 한 필드뿐이었습니다.
C19에서 WinningRule은 P04로 정확히 선택했습니다. 다만 ScopeMatch는 CHECK 대상 Resource인 R_AUD가 아니라 선택된 P04 Rule의 Scope인 R_FIN을 출력해야 합니다. Perplexity는 이 한 칸을 R_AUD로 출력했습니다.
Gemini 86점: 최종 Decision보다 정책 근거 추적에서 더 큰 차이
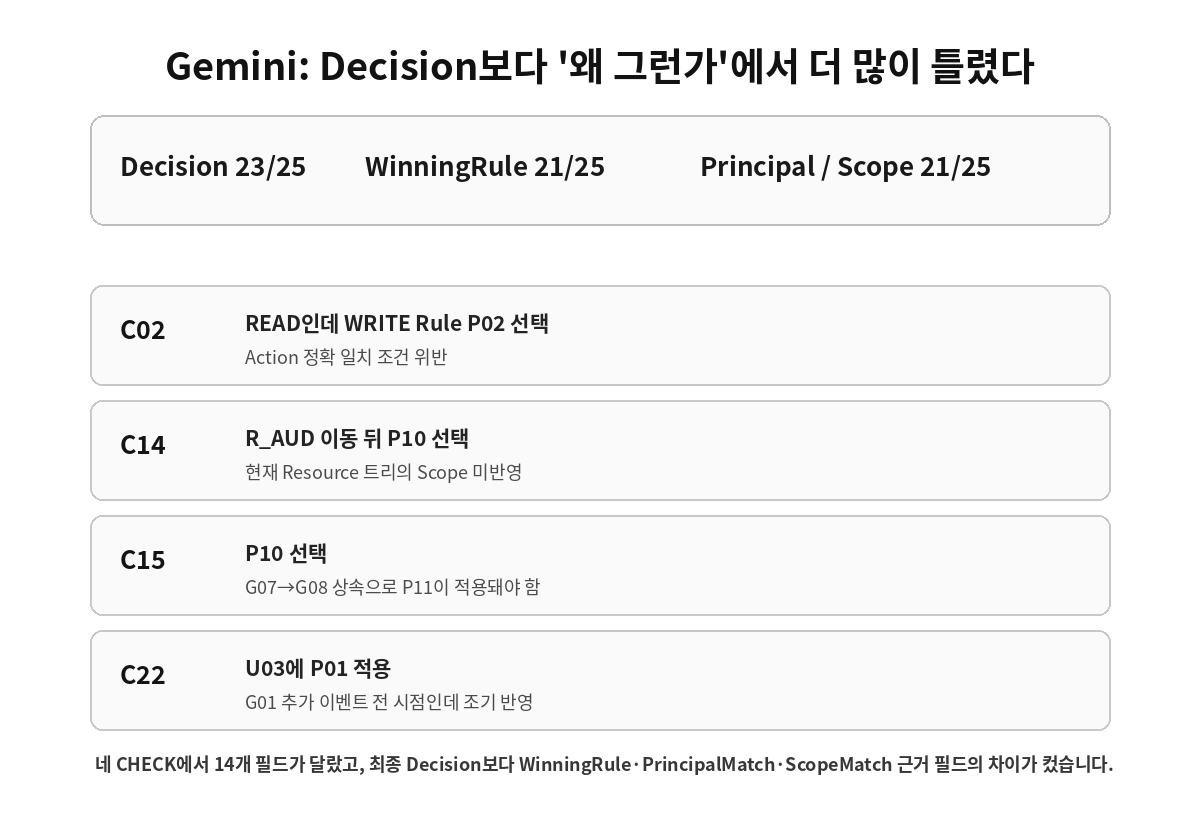
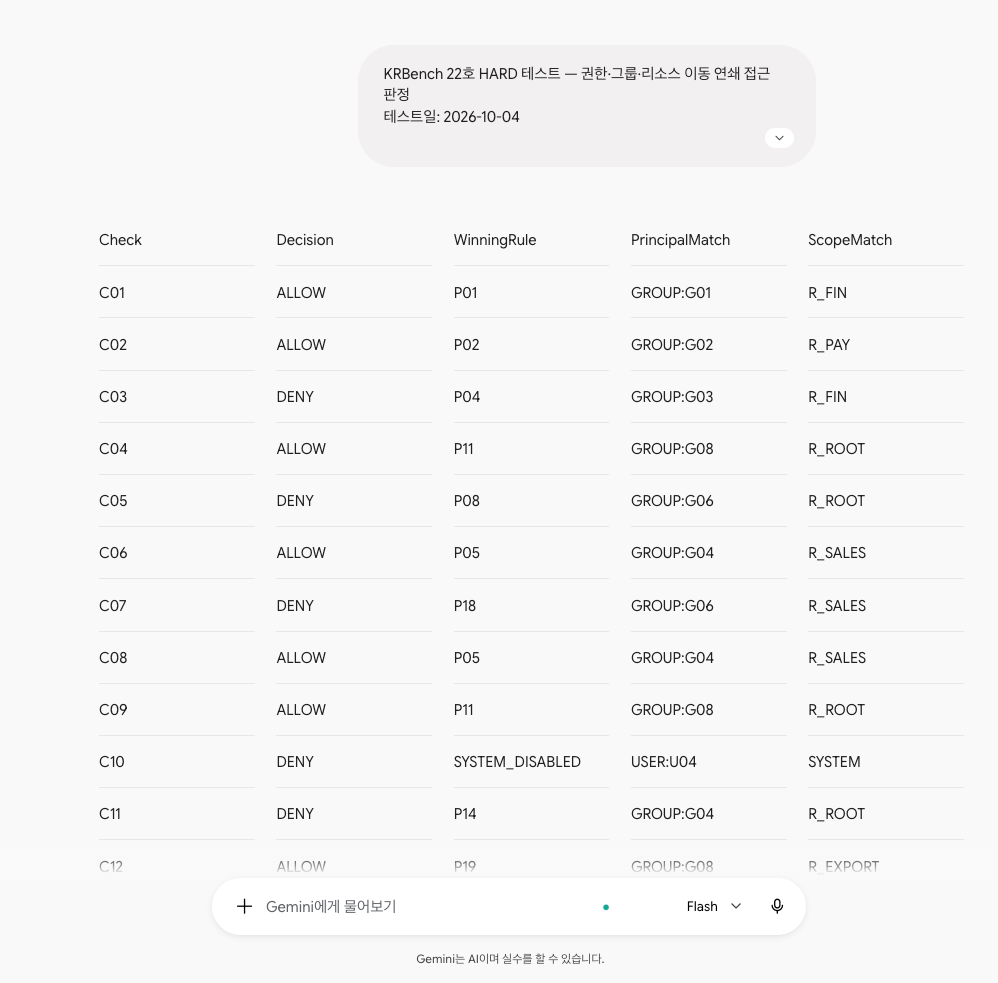
Gemini Flash는 Decision 23/25를 기록했지만 WinningRule, PrincipalMatch, ScopeMatch는 각각 21/25였습니다. 차이가 난 CHECK는 C02, C14, C15, C22 네 건입니다.
C02에서는 CHECK Action이 READ인데 WRITE용 P02를 WinningRule로 선택했습니다. C14와 C15에서는 R_AUD가 R_SHARED 아래로 이동한 현재 Resource 트리를 반영하지 않고 R_FIN Scope의 P10을 적용했습니다. C22에서는 U03이 아직 G01에 추가되기 전인데 P01을 적용했습니다.
응답시간: 5초부터 16초
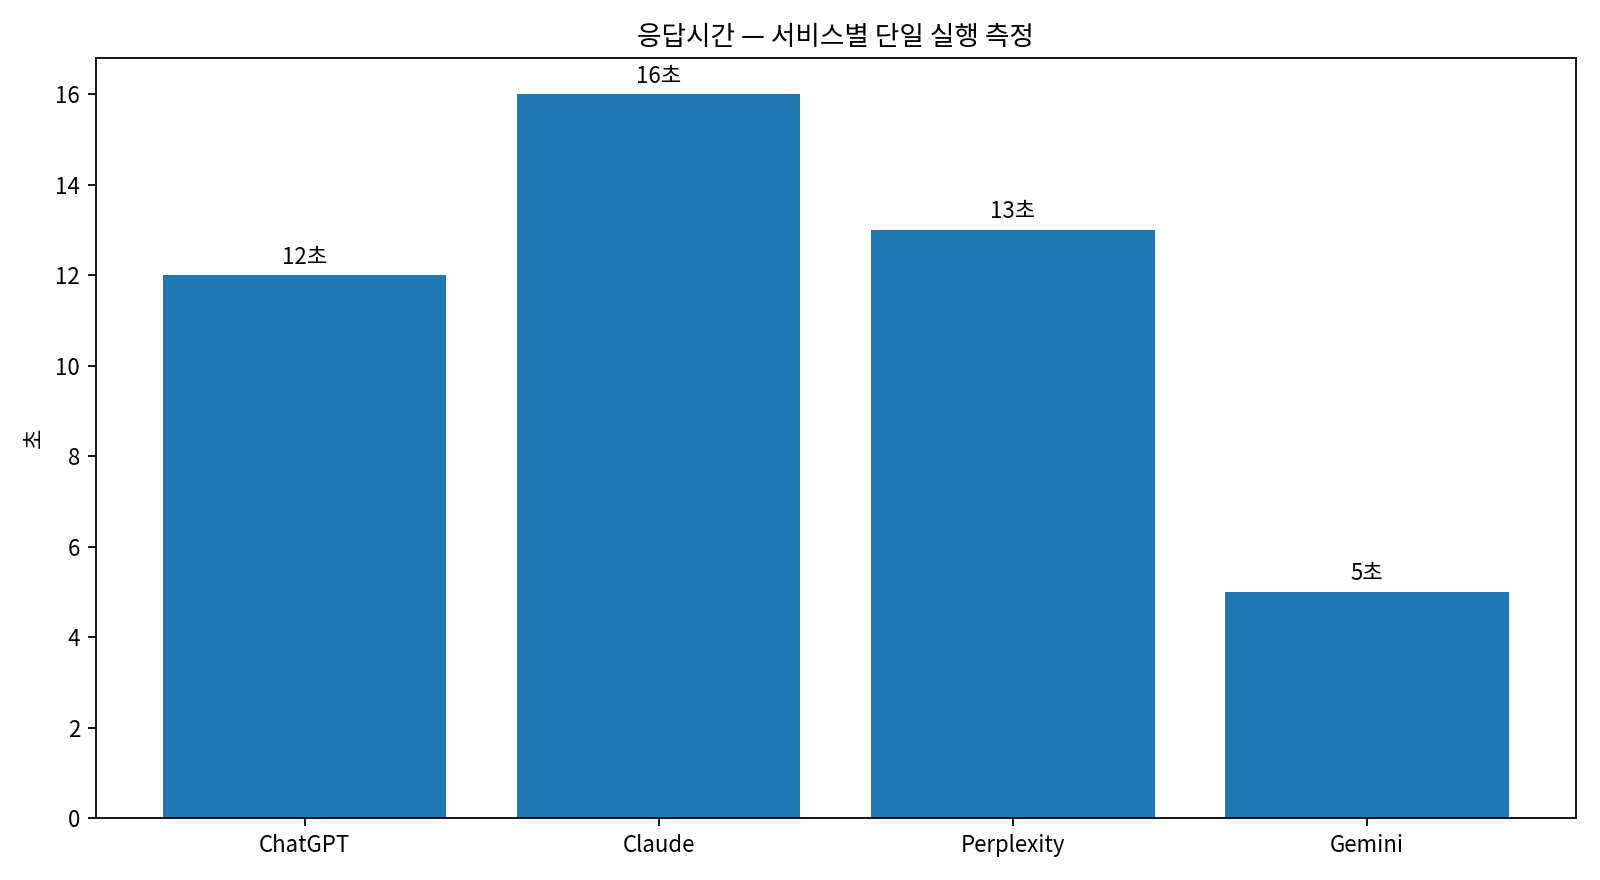
실측 응답시간은 Gemini 5초, ChatGPT 12초, Perplexity 13초, Claude 16초였습니다. 각 서비스에서 한 번만 측정한 값이므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
NotebookLM은 공식 비교에서 제외
이번 테스트는 여러 문서에서 근거를 찾는 작업이 아니라 하나의 긴 정책·상태 프롬프트 안에서 이벤트를 순서대로 적용하는 일반 채팅형 판단 문제입니다. NotebookLM은 다른 서비스와 동일한 일반 채팅 입력 경로를 맞추기 어려워 공식 비교에서는 제외했습니다.
22호에서 확인된 점
이번 조건에서는 ALLOW 또는 DENY 결과만 요구했다면 서비스 간 차이가 더 작게 보였을 가능성이 있습니다. 하지만 어떤 Rule이 승리했고, 그 Rule이 어떤 Principal과 Scope로 적용됐는지까지 함께 채점하면서 정책 근거 추적의 차이가 드러났습니다.
특히 Resource 이동처럼 정책 문구 자체는 바뀌지 않았지만 적용 대상 트리가 달라지는 상황, 그리고 그룹 변경 이벤트가 CHECK 직전인지 직후인지 구분해야 하는 상황이 변별 요소가 됐습니다.
이번 테스트의 한계
- 실제 IAM 제품이나 기업 보안 정책이 아니라 KRBench가 만든 합성 정책입니다.
- 사용자 8명, 그룹 8개, 제한된 Resource 트리와 Action으로 단순화했습니다.
- 조건부 접근, 시간대, IP, MFA, 역할 만료, ABAC 속성은 포함하지 않았습니다.
- Rule 충돌 해소 순서는 테스트용으로 명시적으로 고정한 가상 정책입니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
관련 KRBench 테스트
안전재고·우선순위·COMMIT이 겹치면 AI가 재고 예약을 끝까지 다시 계산할까?
3개 창고와 4개 SKU의 90개 이벤트를 처리하고 25개 주문의 상태·배정량·백오더·창고별 배정을 비교했습니다.
→ AI 재고 예약·백오더 HARD 테스트 보기11호~20호 업무 벤치마크 10편을 한 번에 보면?
문서 근거, 규정 판단, 상태 추적, 일정·예산·계약 계산에서 반복된 오류 유형과 HARD 전환 전후를 중간결산으로 정리했습니다.
→ KRBench 업무 벤치마크 10편 중간결산 보기발주·입고·반품·Credit·Void가 이어지면 AI가 최종 Invoice 지급액을 정확히 계산할까?
8개 PO의 순차 이벤트와 25개 Invoice CHECK로 승인 여부, 지급액, 잔여 PO 수량, 거절 사유를 100점으로 비교했습니다.
→ AI 3-way match 연쇄 정산 HARD 테스트 보기KRBench는 결과 차이가 크거나 작더라도 사전 정답과 채점 기준을 바꾸지 않고, 같은 조건에서 확인된 첫 응답을 그대로 기록합니다.