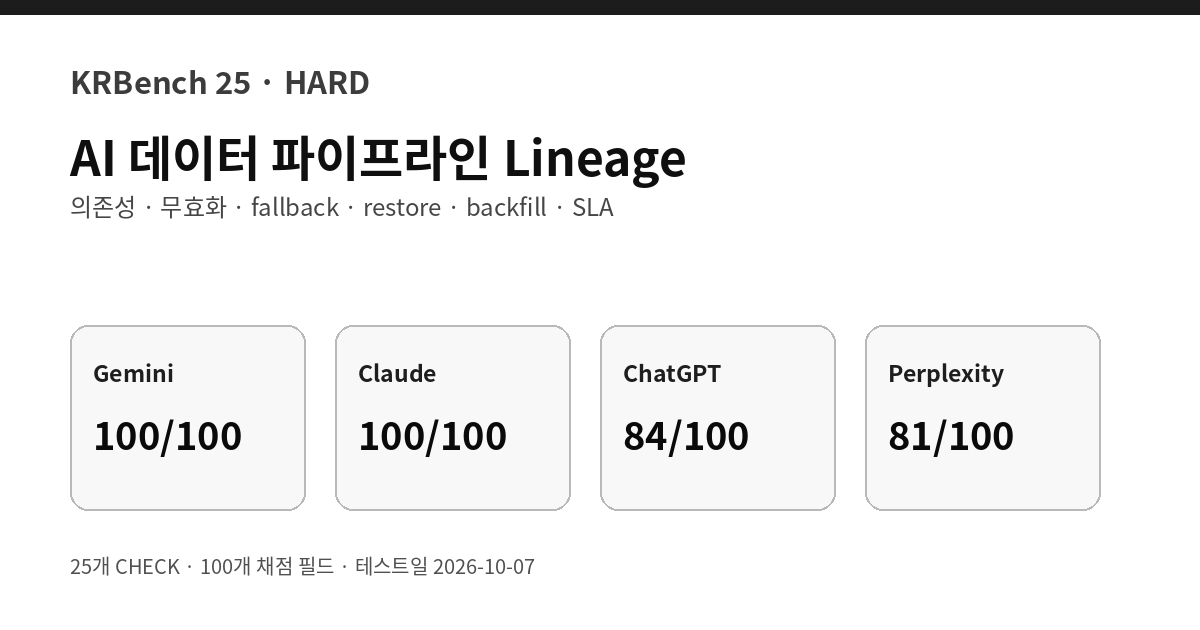
데이터 파이프라인에서 최신 Source가 생겼다고 모든 Downstream 데이터가 자동으로 최신 상태가 되는 것은 아닙니다. 이미 생성된 Version은 당시 실제로 사용한 Dependency와 Root Source를 그대로 기억하고, 특정 Run이 무효화되면 그 Run을 사용한 Downstream Version까지 연쇄적으로 사용할 수 없게 될 수 있습니다.
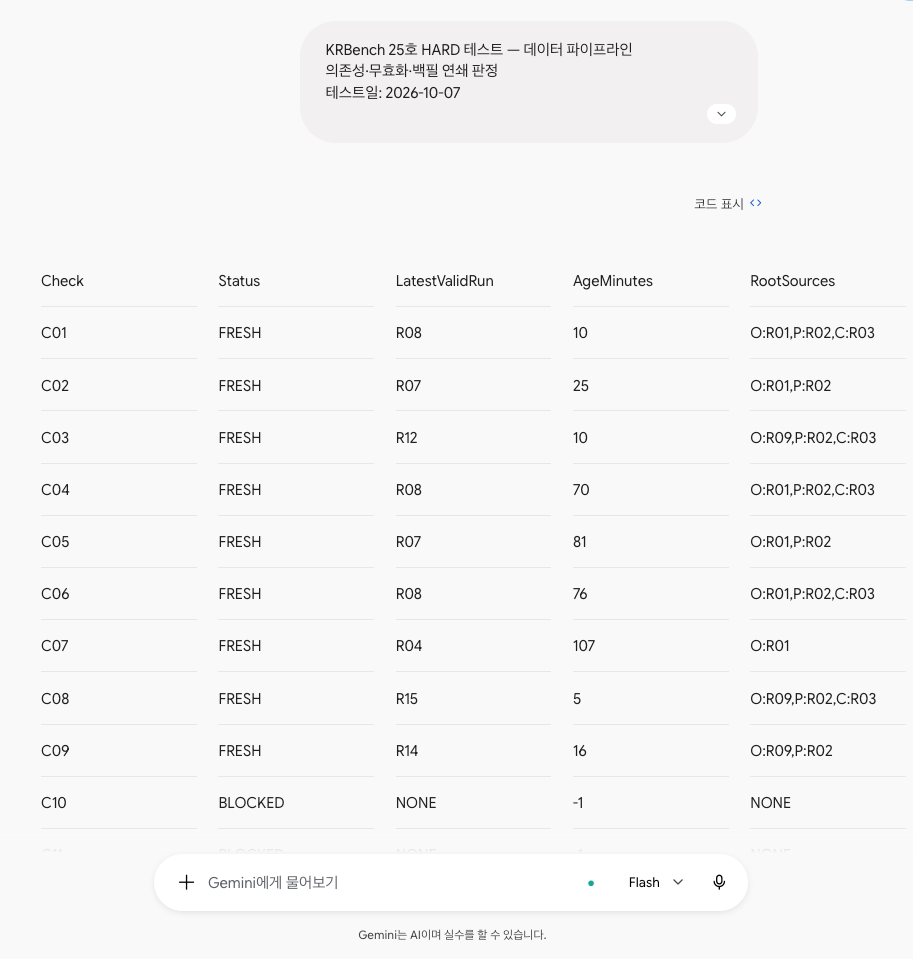
KRBench 25호는 이런 상황을 하나의 긴 이벤트 스트림으로 만들었습니다. Source·정제·지표·매출·대시보드로 이어지는 DAG에서 RUN, INVALIDATE, RESTORE, rerun/backfill과 SLA 판정을 순서대로 처리하게 했습니다.
공식 채점은 C01~C25의 Status, LatestValidRun, AgeMinutes, RootSources 네 필드, 총 100점입니다. 이번 25호는 현재 업무 정확도 HARD 시리즈의 마지막 개별 테스트입니다.
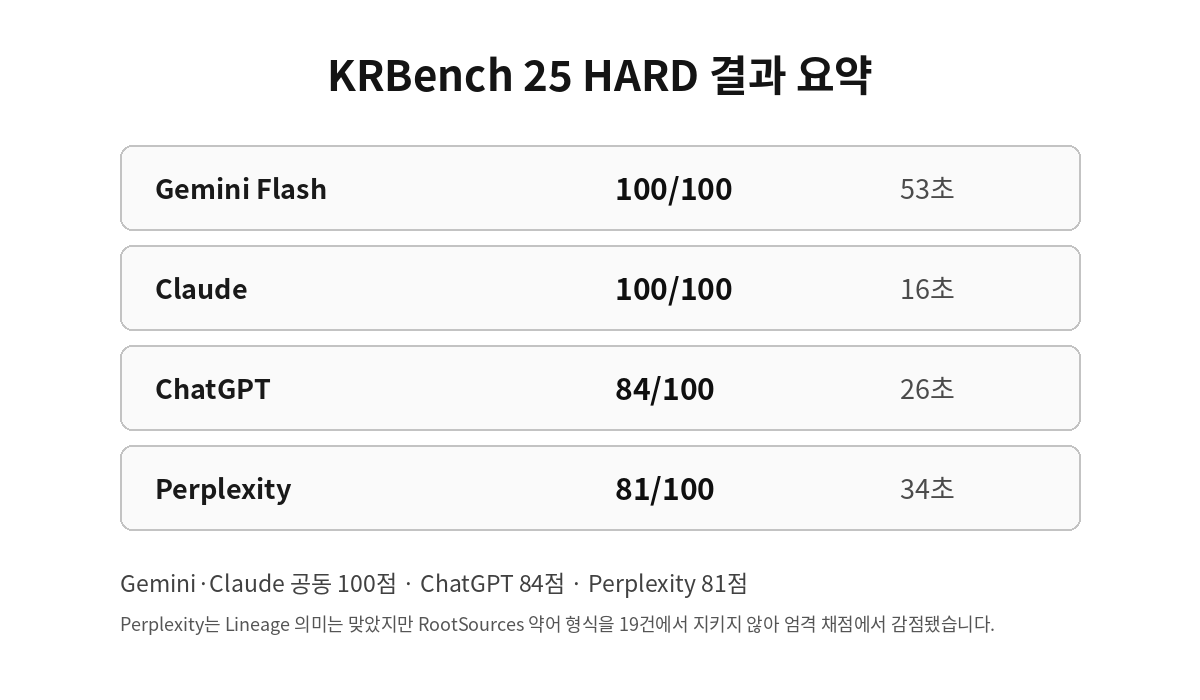
결과 요약
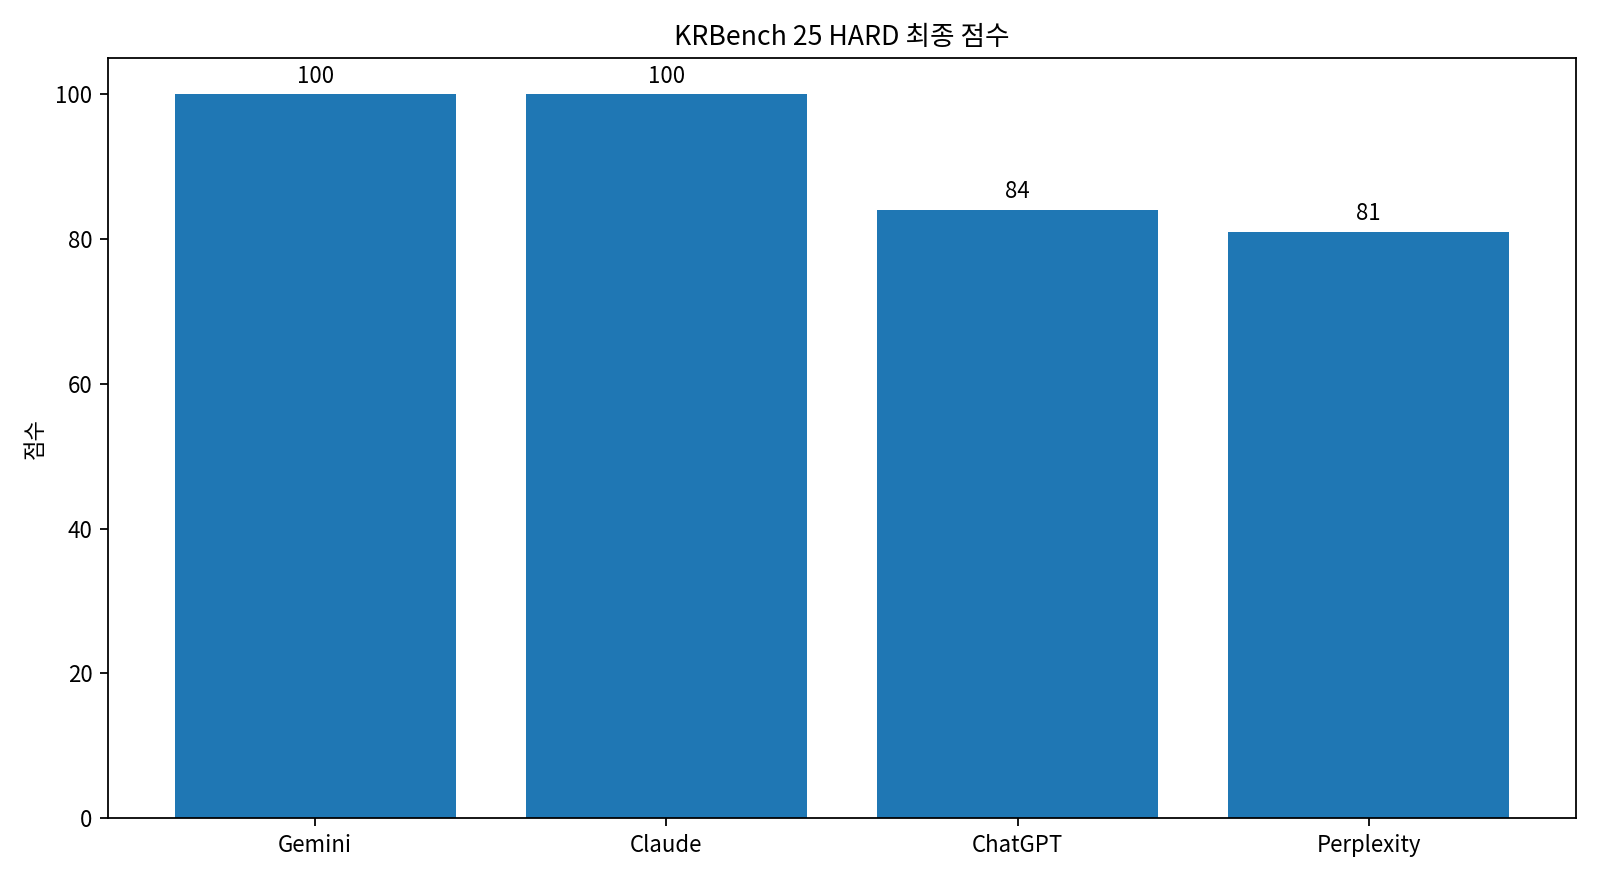
- Gemini Flash: 100/100 · 53초
- Claude Sonnet 5.5 · 중간: 100/100 · 16초
- ChatGPT: 84/100 · 26초
- Perplexity: 81/100 · 34초
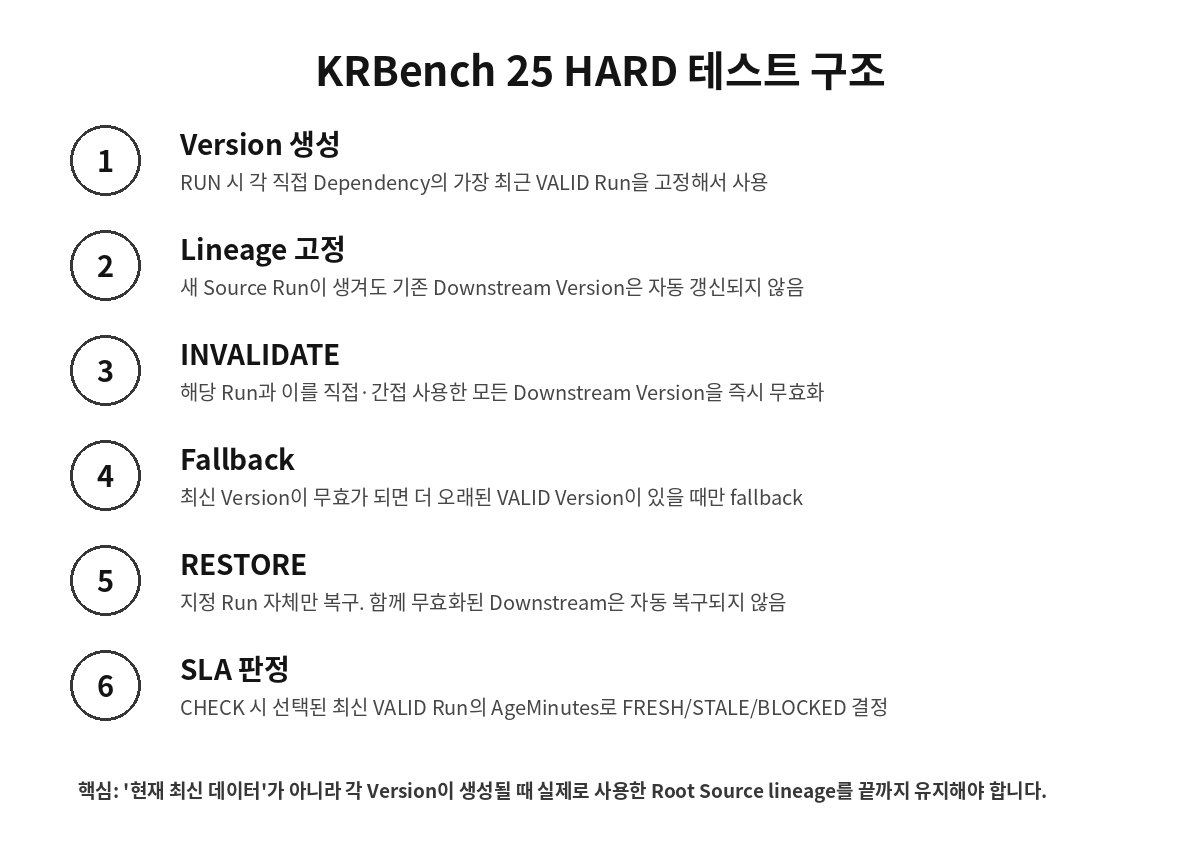
테스트 구조: 현재 값이 아니라 Version Lineage를 추적
각 RUN이 성공하면 하나의 Version을 만듭니다. Derived Dataset은 실행 시점에 각 직접 Dependency에서 가장 최근의 VALID Run을 하나씩 선택하고, 그 Version이 실제로 사용한 Root Source를 고정해서 기억합니다.
중요한 규칙은 새 Source Run이 생겨도 이미 만들어진 Downstream Version이 자동으로 바뀌지 않는다는 점입니다. 새 Source를 반영하려면 해당 Downstream을 다시 RUN해야 합니다.
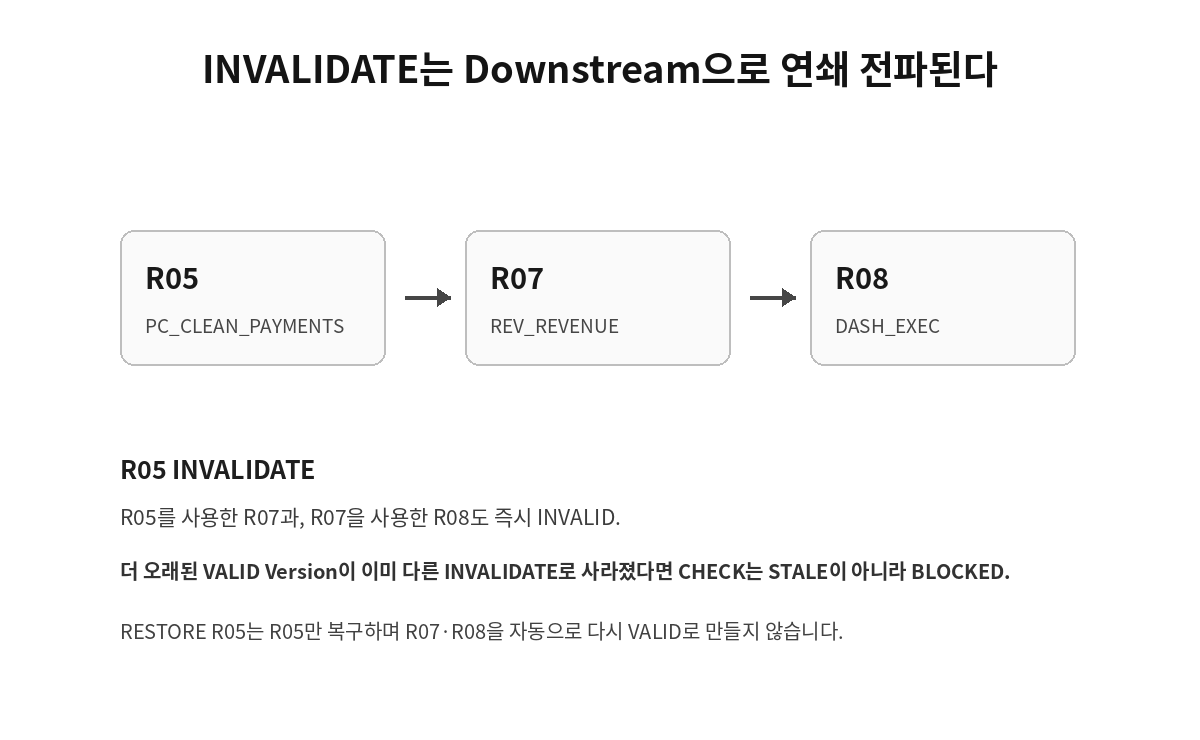
INVALIDATE는 직접·간접 Downstream까지 전파
특정 Run이 INVALIDATE되면 해당 Run만 무효화되는 것이 아닙니다. 그 Run을 직접 또는 간접 Lineage로 사용한 기존 Downstream Version도 즉시 INVALID가 됩니다.
이후 CHECK에서는 무효 Version을 제외하고 더 오래된 VALID Version이 남아 있으면 fallback합니다. 하지만 사용할 수 있는 VALID Version이 하나도 없으면 STALE이 아니라 BLOCKED입니다.
RESTORE는 해당 Run만 복구
RESTORE는 지정된 Run 자체만 다시 VALID로 만듭니다. 이전 INVALIDATE에서 함께 무효화된 Downstream Version은 자동으로 복구하지 않습니다.
따라서 Source를 RESTORE했다고 과거 Dashboard Version까지 다시 VALID가 되는 것이 아닙니다. Downstream을 다시 최신 상태로 만들려면 필요한 Dataset을 새로 RUN해야 합니다.
Freshness는 선택된 LatestValidRun의 나이로 판정
CHECK 시점에 해당 Dataset의 가장 최근 VALID Version을 찾은 뒤, 생성 시각과 CHECK 시각의 차이를 AgeMinutes로 계산했습니다. Dataset별 SLA보다 작거나 정확히 같으면 FRESH, SLA를 넘으면 STALE입니다.
예를 들어 REV_REVENUE의 SLA가 180분일 때 AgeMinutes가 정확히 180분이면 FRESH이고, 200분이면 STALE입니다.
채점 기준: 25개 CHECK × 4개 필드 = 100점
| 항목 | CHECK당 | 총 배점 |
|---|---|---|
| Status | 1점 | 25점 |
| LatestValidRun | 1점 | 25점 |
| AgeMinutes | 1점 | 25점 |
| RootSources | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
RootSources는 단순 의미 일치가 아니라 사전에 지정한 출력 규격까지 정확 비교했습니다. 예를 들어 O:R01,P:R02,C:R03처럼 O/P/C 약어 순서를 사용하고 쉼표 뒤에는 공백을 넣지 않는 조건입니다.
숨은 정답과 채점 기준은 서비스 결과를 보기 전에 결정론적 Lineage 상태 엔진으로 생성해 고정했습니다. 결과 확인 후 INVALIDATE·RESTORE 규칙이나 배점을 바꾸지 않았습니다.
전체 결과: Gemini·Claude 공동 100점
| 서비스 | Status | LatestValidRun | AgeMinutes | RootSources | 총점 | 응답시간 |
|---|---|---|---|---|---|---|
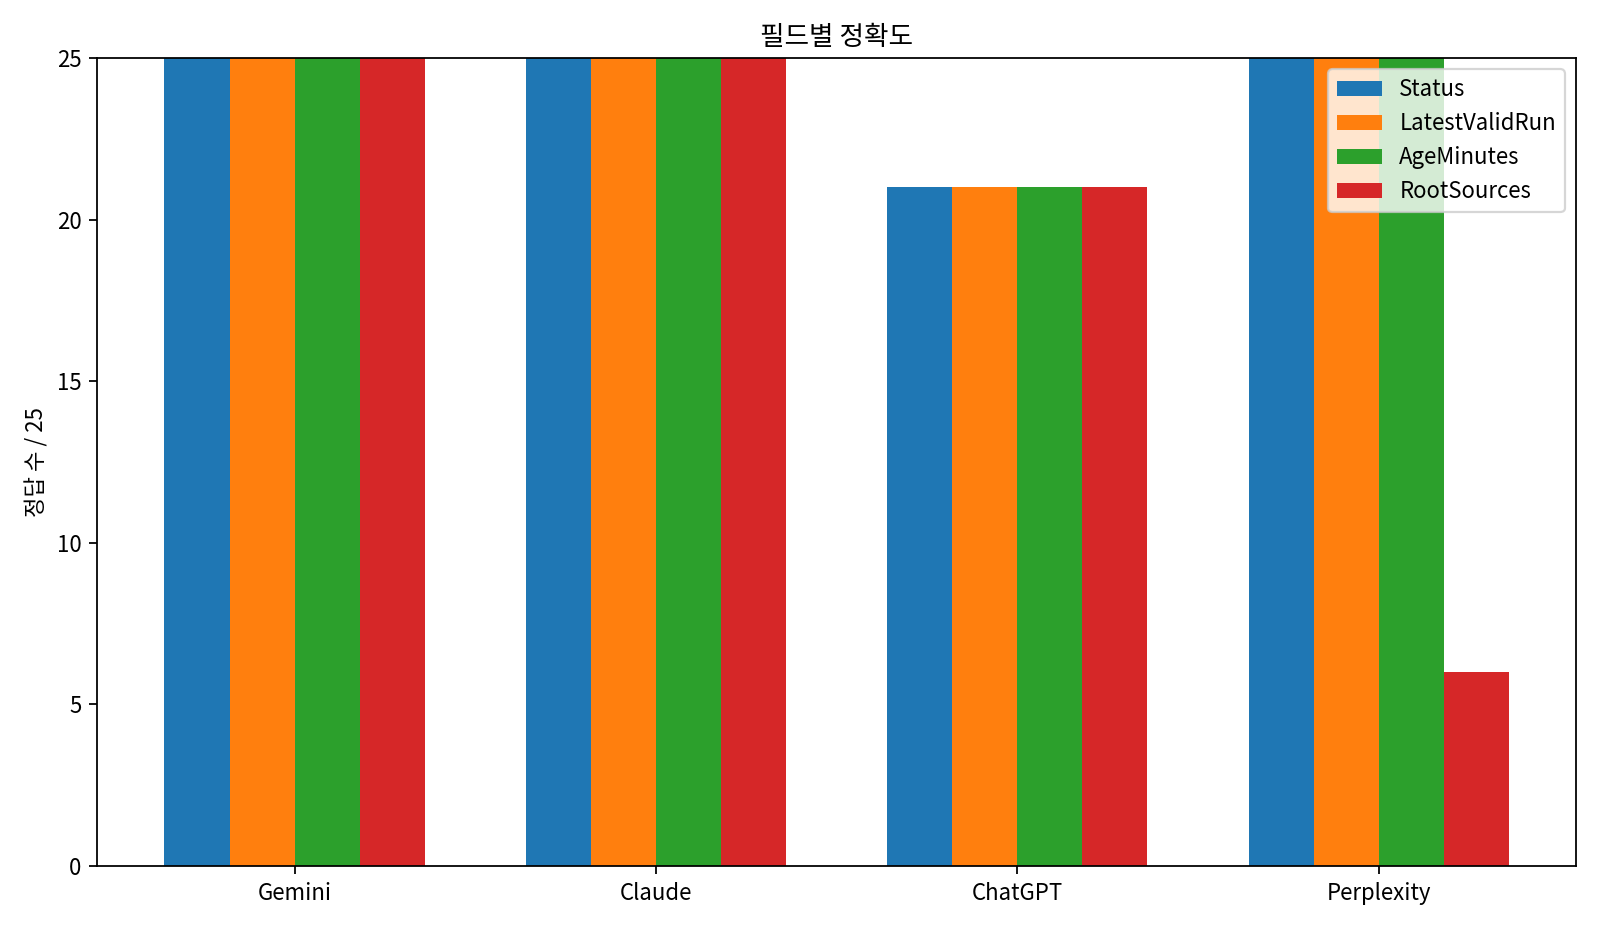
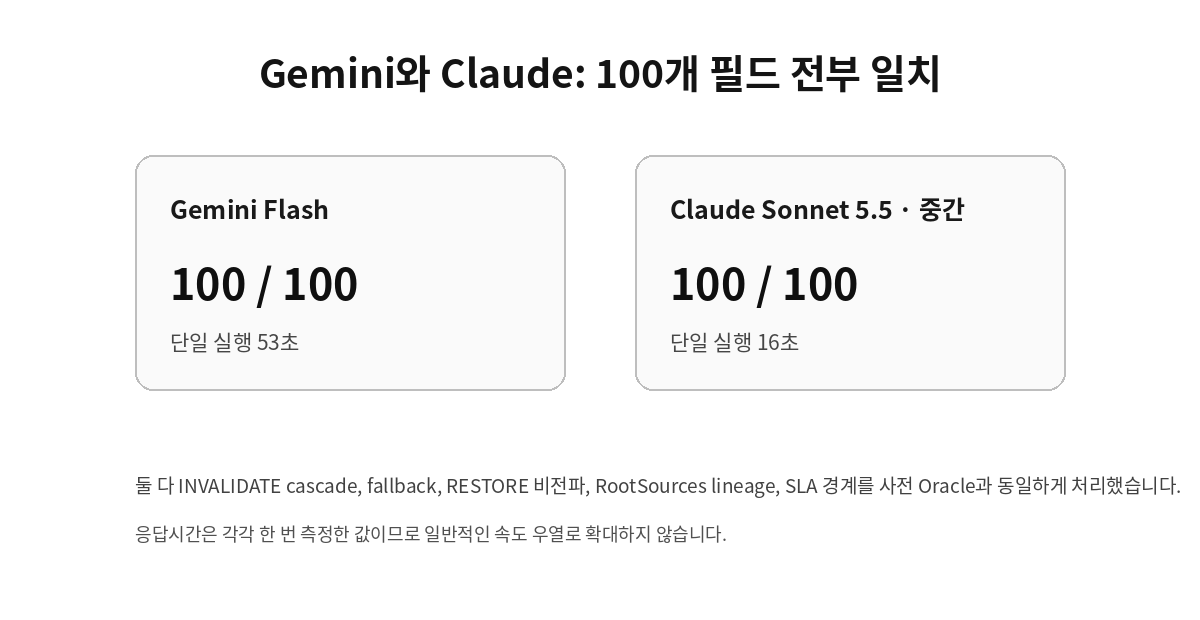
| Gemini Flash | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 53초 |
| Claude Sonnet 5.5 · 중간 | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 16초 |
| ChatGPT | 21/25 | 21/25 | 21/25 | 21/25 | 84/100 | 26초 |
| Perplexity | 25/25 | 25/25 | 25/25 | 6/25 | 81/100 | 34초 |
Gemini·Claude: 100개 필드 모두 일치
Gemini Flash와 Claude Sonnet 5.5 · 중간은 C01~C25의 네 필드를 모두 맞혀 각각 100점을 기록했습니다.
두 서비스 모두 Source 무효화의 transitive cascade, 최신 Version 무효화 뒤의 fallback, RESTORE 비전파, rerun 이후 Root Source 교체, 정확히 SLA와 같은 경계값까지 사전 Oracle과 동일하게 처리했습니다.
ChatGPT 84점: 무효화된 Downstream을 fallback 후보로 남김
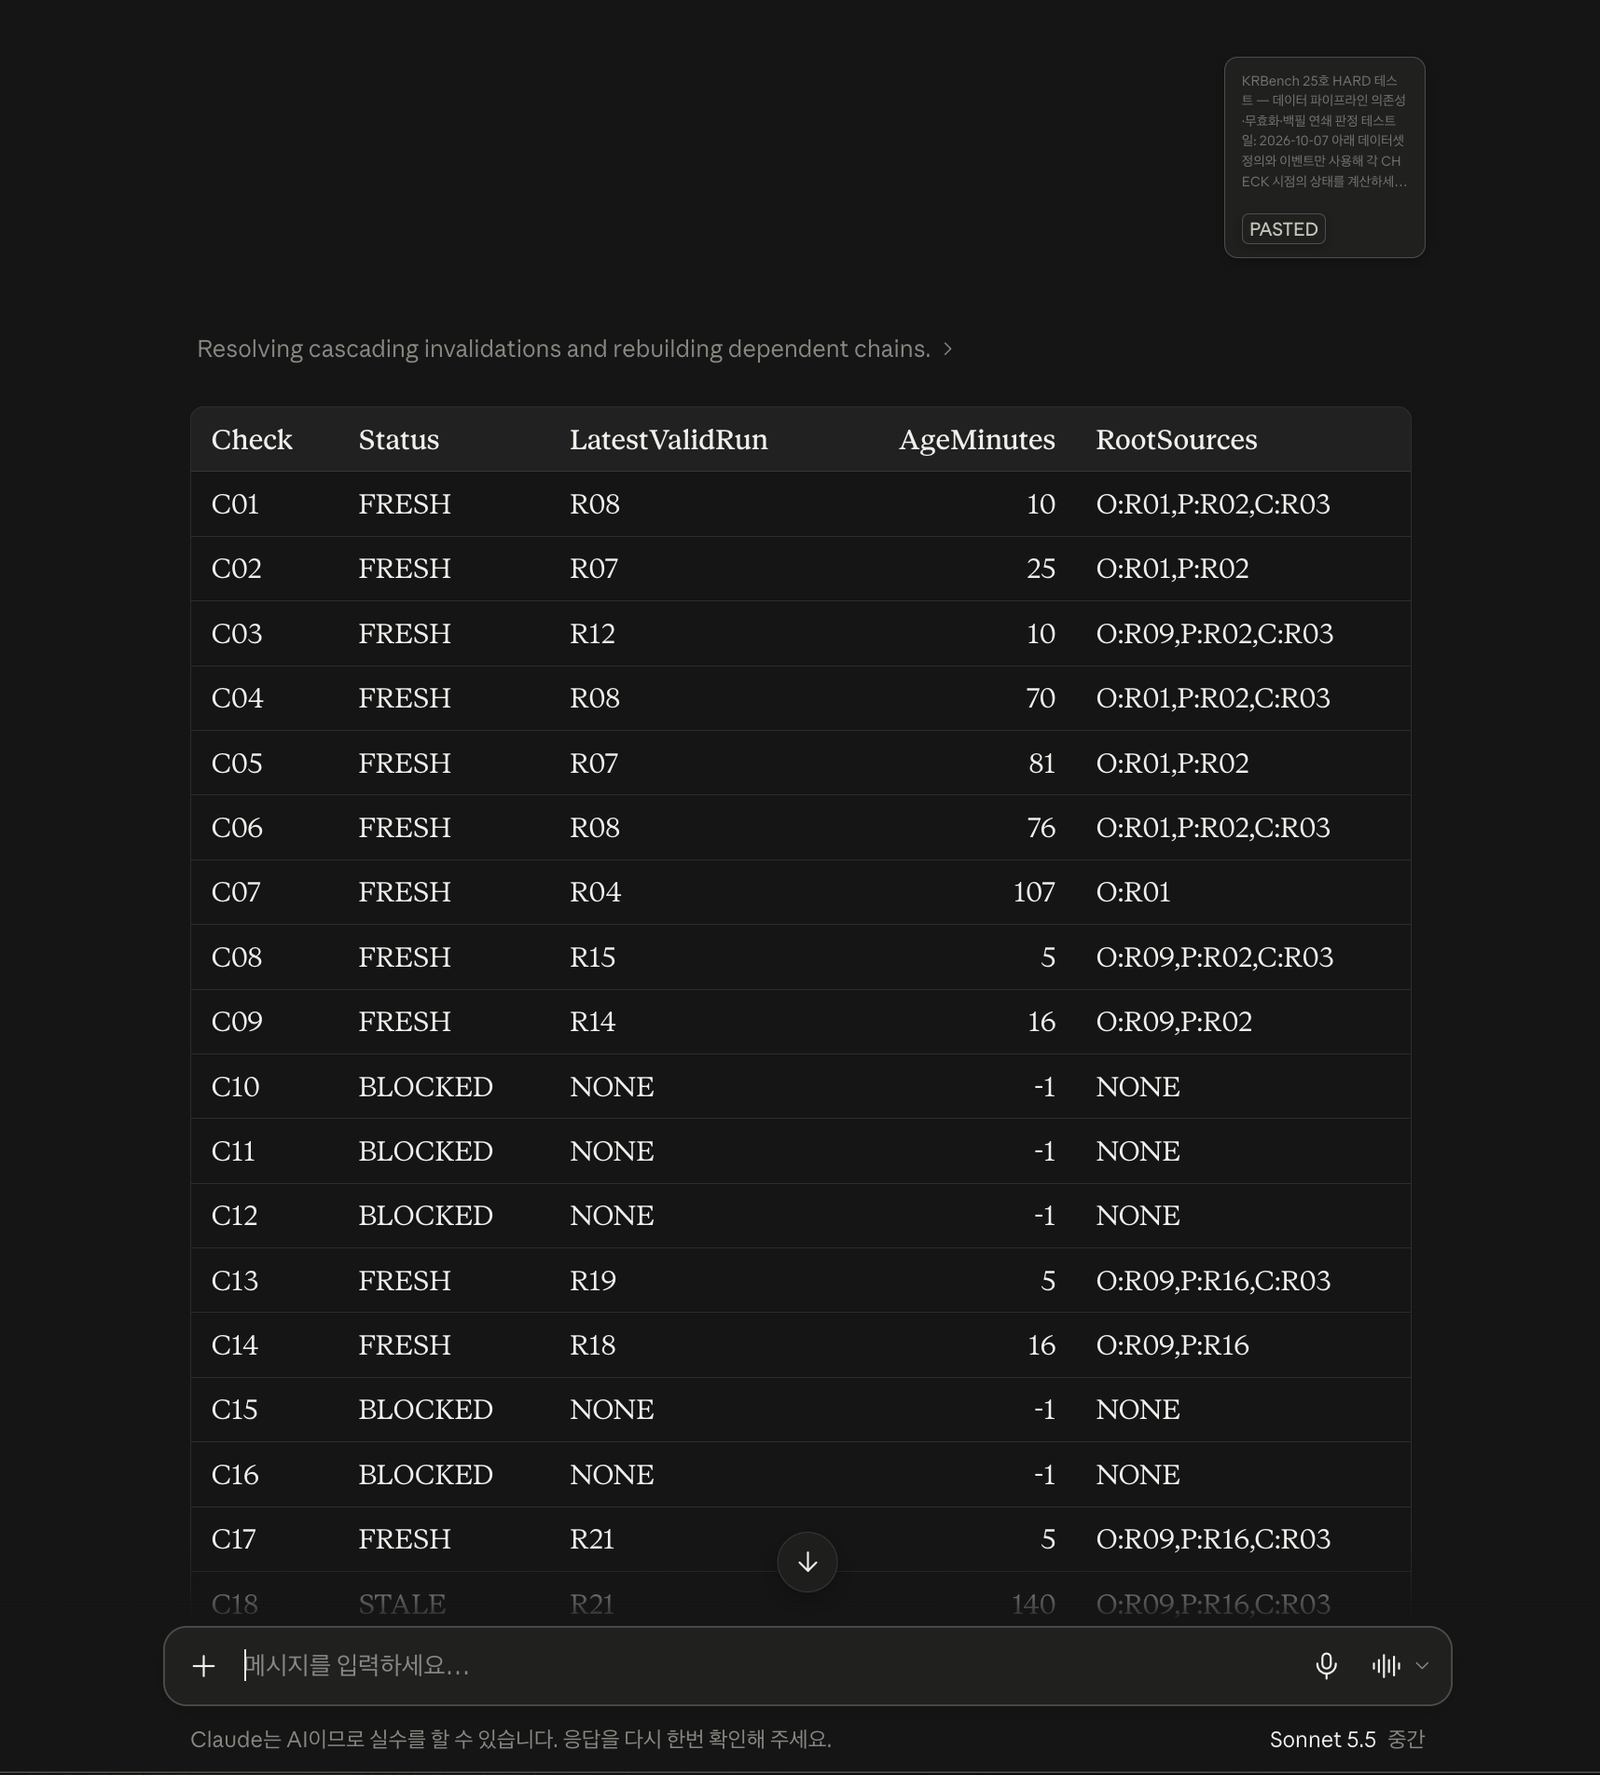
ChatGPT는 C10, C11, C15, C24 네 CHECK에서 차이가 났습니다. 네 건 모두 Status, LatestValidRun, AgeMinutes, RootSources가 함께 달라 총 16점이 감점됐습니다.
C10과 C11 직전에는 R05가 INVALIDATE됩니다. R05를 직접 사용한 R07뿐 아니라 R07을 사용한 R08까지 모두 INVALID가 되어야 합니다. 이 시점에는 해당 Dataset에서 사용할 수 있는 VALID Version이 없으므로 BLOCKED가 사전 정답입니다.
ChatGPT는 R07 또는 R08을 오래된 fallback 후보로 다시 사용했습니다. 즉 Version이 오래됐는지보다, 이미 transitive INVALIDATE로 무효화됐는지를 끝까지 유지하는 부분에서 차이가 발생했습니다.
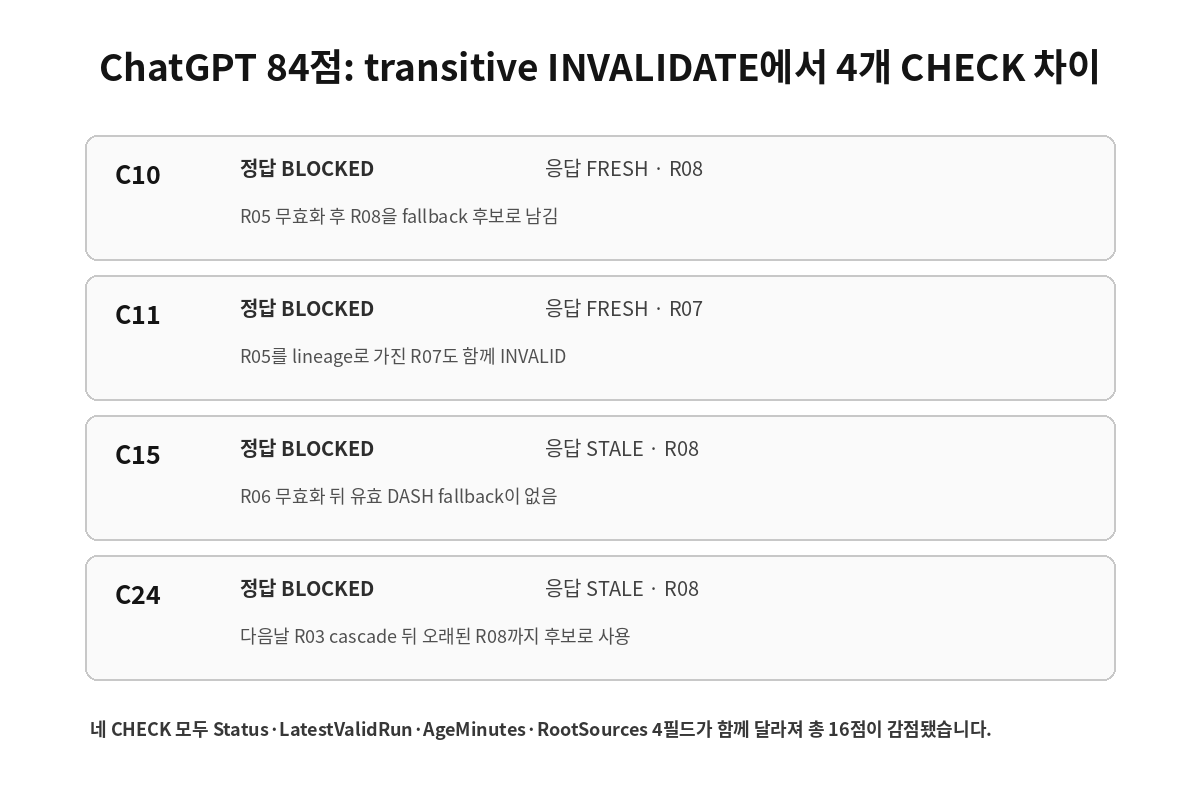
Perplexity 81점: Lineage 판단은 맞고 출력 계약에서 감점
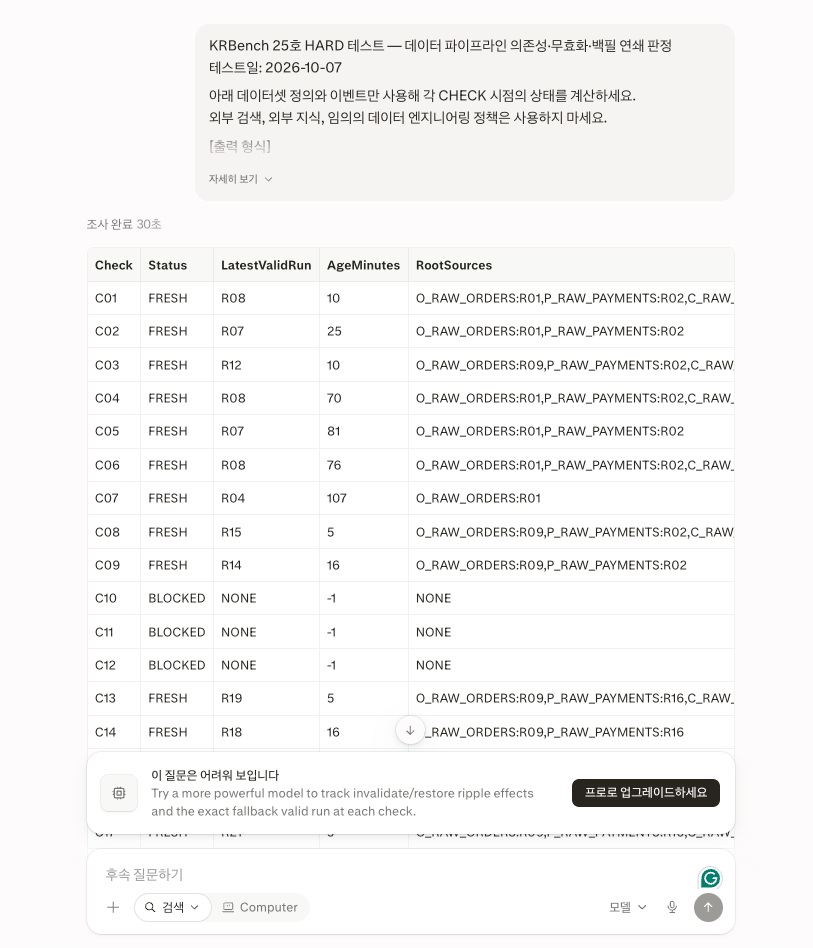
Perplexity 결과는 다른 오답과 구분해서 볼 필요가 있습니다. Status, LatestValidRun, AgeMinutes는 각각 25/25로 전부 사전 정답과 일치했습니다.
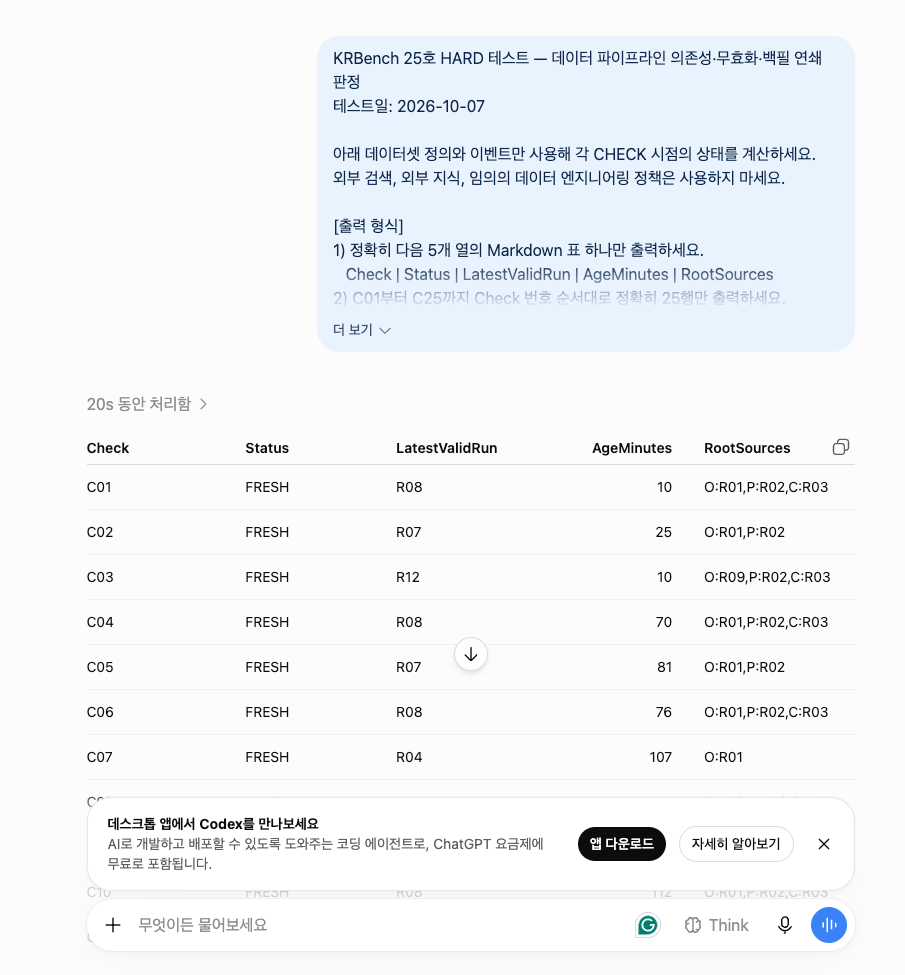
차이는 RootSources입니다. 사전 출력 규칙은 O:R01,P:R02,C:R03처럼 O/P/C 약어를 사용하도록 명시했지만, Perplexity는 O_RAW_ORDERS:R01,P_RAW_PAYMENTS:R02,C_RAW_CRM:R03처럼 전체 Dataset명을 사용했습니다.
RootSources는 사전에 문자열 형식까지 정확 비교하기로 고정했기 때문에 BLOCKED의 NONE 6건만 일치하고 나머지 19건은 오답 처리했습니다. 그래서 총점은 81점입니다.
다만 이 19점 손실을 Lineage 추론 실패로 해석하면 안 됩니다. Perplexity는 어떤 Source Run을 사용했는지에 대한 의미, 최신 VALID Run, BLOCKED/STALE/FRESH 판정, AgeMinutes는 모두 맞았습니다. 이번 감점은 엄격한 출력 계약 준수 항목에서 발생했습니다.
응답시간: 16초부터 53초
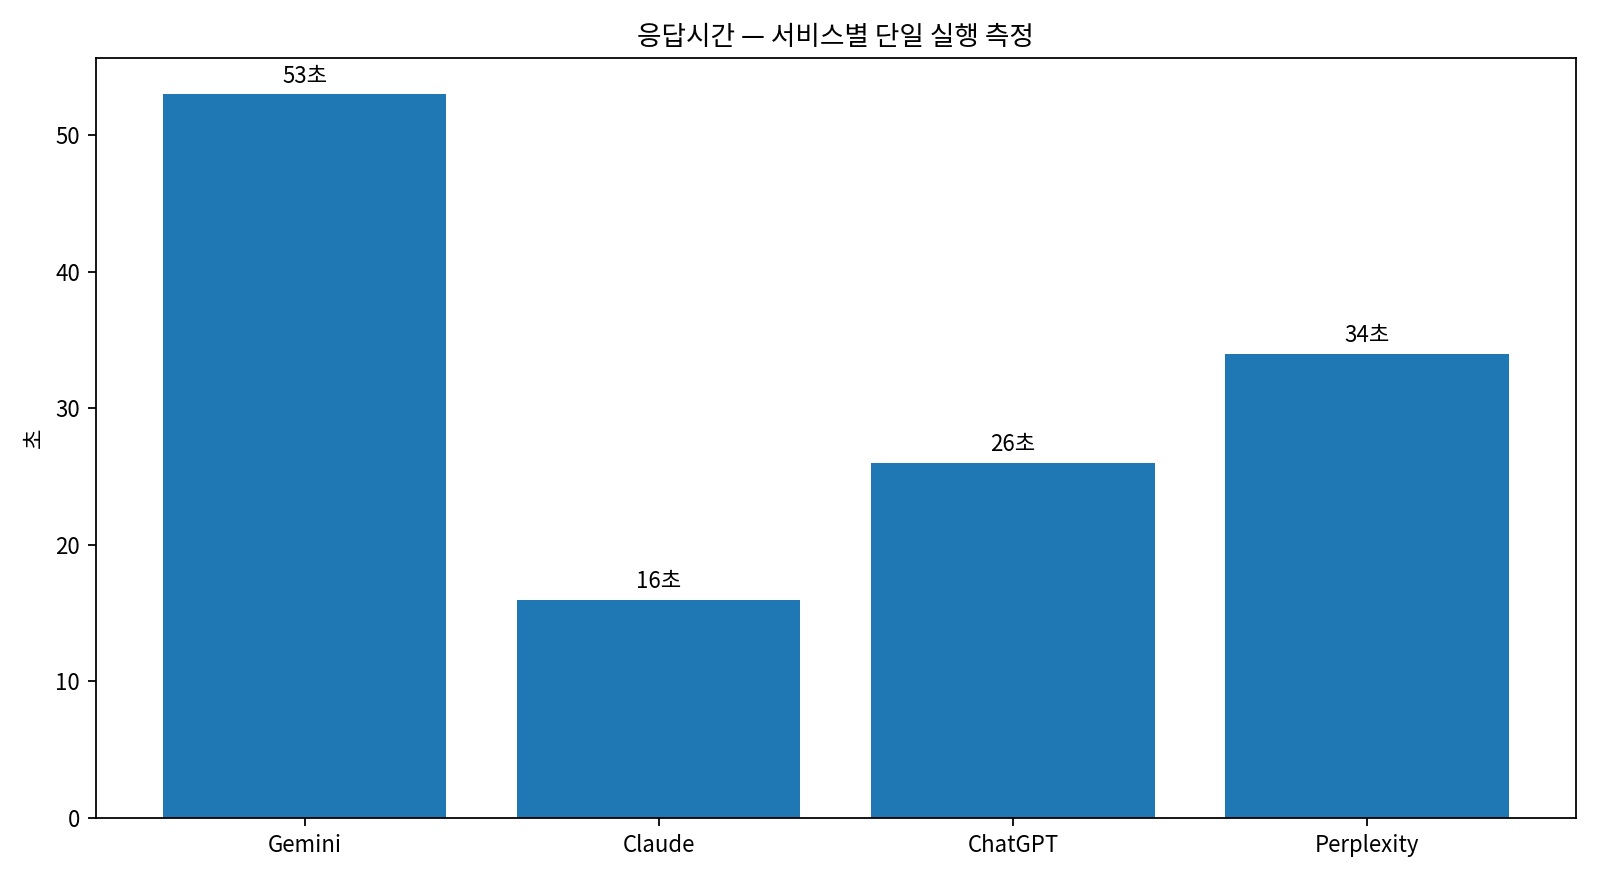
실측 응답시간은 Claude 16초, ChatGPT 26초, Perplexity 34초, Gemini 53초였습니다. 서비스마다 한 번 측정한 값이므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
NotebookLM은 공식 비교에서 제외
이번 테스트는 여러 파일에서 정보를 검색하는 작업이 아니라 하나의 긴 데이터 파이프라인 이벤트 스트림에서 Version Lineage와 VALID/INVALID 상태를 순차 처리하는 일반 채팅형 문제입니다. NotebookLM은 다른 서비스와 동일한 입력 경로를 맞추기 어려워 공식 비교에서 제외했습니다.
25호에서 확인된 점
이번 조건에서는 단순히 가장 최근에 생성된 Run을 찾는 것만으로는 부족했습니다. 그 Run이 현재 VALID인지, 어떤 무효화 사건의 Lineage에 포함됐는지, fallback 가능한 더 오래된 Version이 실제로 남아 있는지를 함께 유지해야 했습니다.
또 하나의 결과는 정확도 점수와 오류 유형을 같이 봐야 한다는 점입니다. ChatGPT의 16점 손실은 상태 추적 로직에서 발생했지만, Perplexity의 19점 손실은 사전에 고정한 출력 문자열 계약 때문에 발생했습니다. 총점만 보면 Perplexity가 낮지만 오류 성격은 서로 다릅니다.
이번 테스트의 한계
- 실제 Airflow, dbt, Dagster, Spark 등 특정 제품의 동작을 재현한 테스트가 아니라 KRBench가 정의한 합성 Lineage 정책입니다.
- DAG는 8개 Dataset으로 제한했고 순환 의존성은 포함하지 않았습니다.
- RUN 실패 재시도, 동시 실행, 파티션 단위 Lineage, 데이터 품질 조건은 포함하지 않았습니다.
- RootSources 문자열 규격은 실제 제품 표준이 아니라 이번 벤치마크를 위해 명시적으로 고정한 출력 계약입니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
관련 KRBench 테스트
Shift 편집·무효, PTO, 야간·휴일·초과근무가 겹치면 AI가 급여를 정확히 계산할까?
25개 CHECK로 WorkHours, OvertimeHours, NightHours, GrossPayKRW를 비교했습니다.
→ AI 근태·급여 연쇄 재계산 HARD 테스트 보기11호~20호 업무 벤치마크 10편 중간결산
문서 근거, 규정 판단, 상태 추적, 일정·예산·계약 계산에서 반복된 오류와 HARD 전환 전후를 정리했습니다.
→ 업무 벤치마크 중간결산 보기18~25호 HARD 테스트 8편을 한 번에 보면 어떤 패턴이 반복됐을까?
프로젝트 일정부터 데이터 Lineage까지 8개 실무형 HARD 테스트의 공식 점수, 평균, 점수차와 반복 오류 유형을 총정리했습니다.
→ AI 업무 정확도 HARD 테스트 8편 총정리 보기KRBench는 결과 차이가 크거나 작더라도 사전 정답과 채점 기준을 바꾸지 않고, 같은 조건에서 확인된 첫 응답을 그대로 기록합니다.