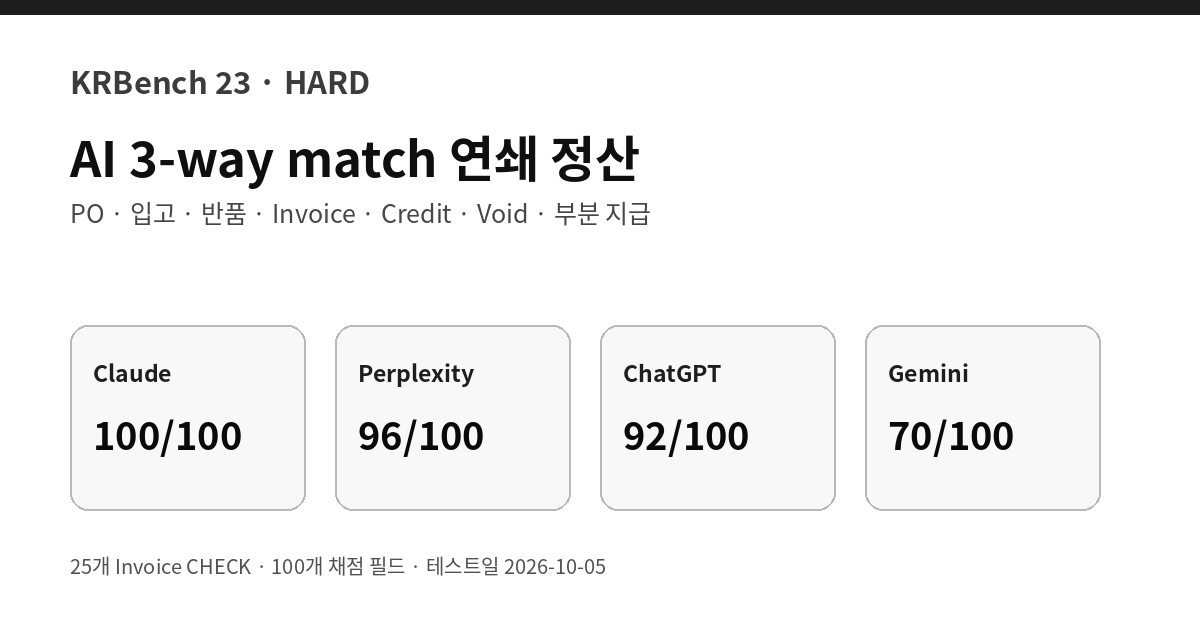
발주서(PO), 실제 입고 수량, 인보이스를 맞추는 3-way match는 각 문서 한 장만 확인해서 끝나는 작업이 아닙니다. 앞선 인보이스가 승인되면 잔여 발주 수량이 줄고, 반품·Credit·Void가 발생하면 뒤 인보이스에서 다시 사용할 수 있는 수량이 바뀝니다.
KRBench 23호에서는 8개 PO와 순차 이벤트를 사용해 25개 INVOICE CHECK를 처리하도록 했습니다. 공식 채점은 각 CHECK의 Decision, PayableKRW, OpenPOQty, PrimaryReason 네 필드, 총 100점입니다.
결과 요약
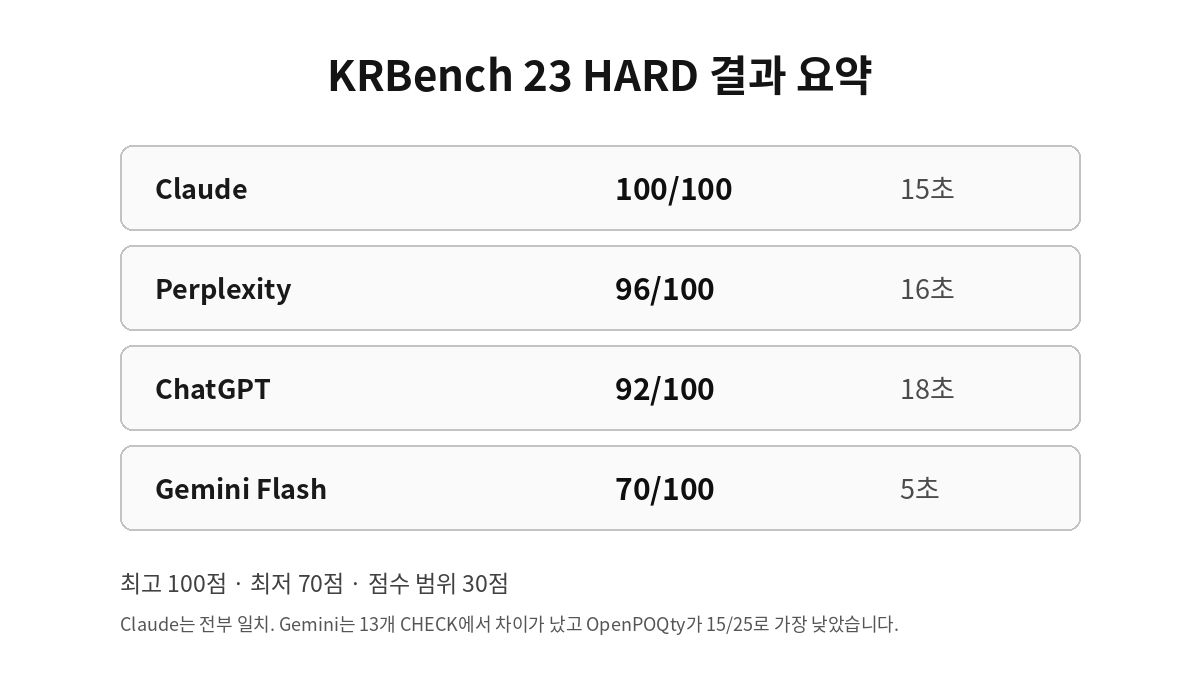
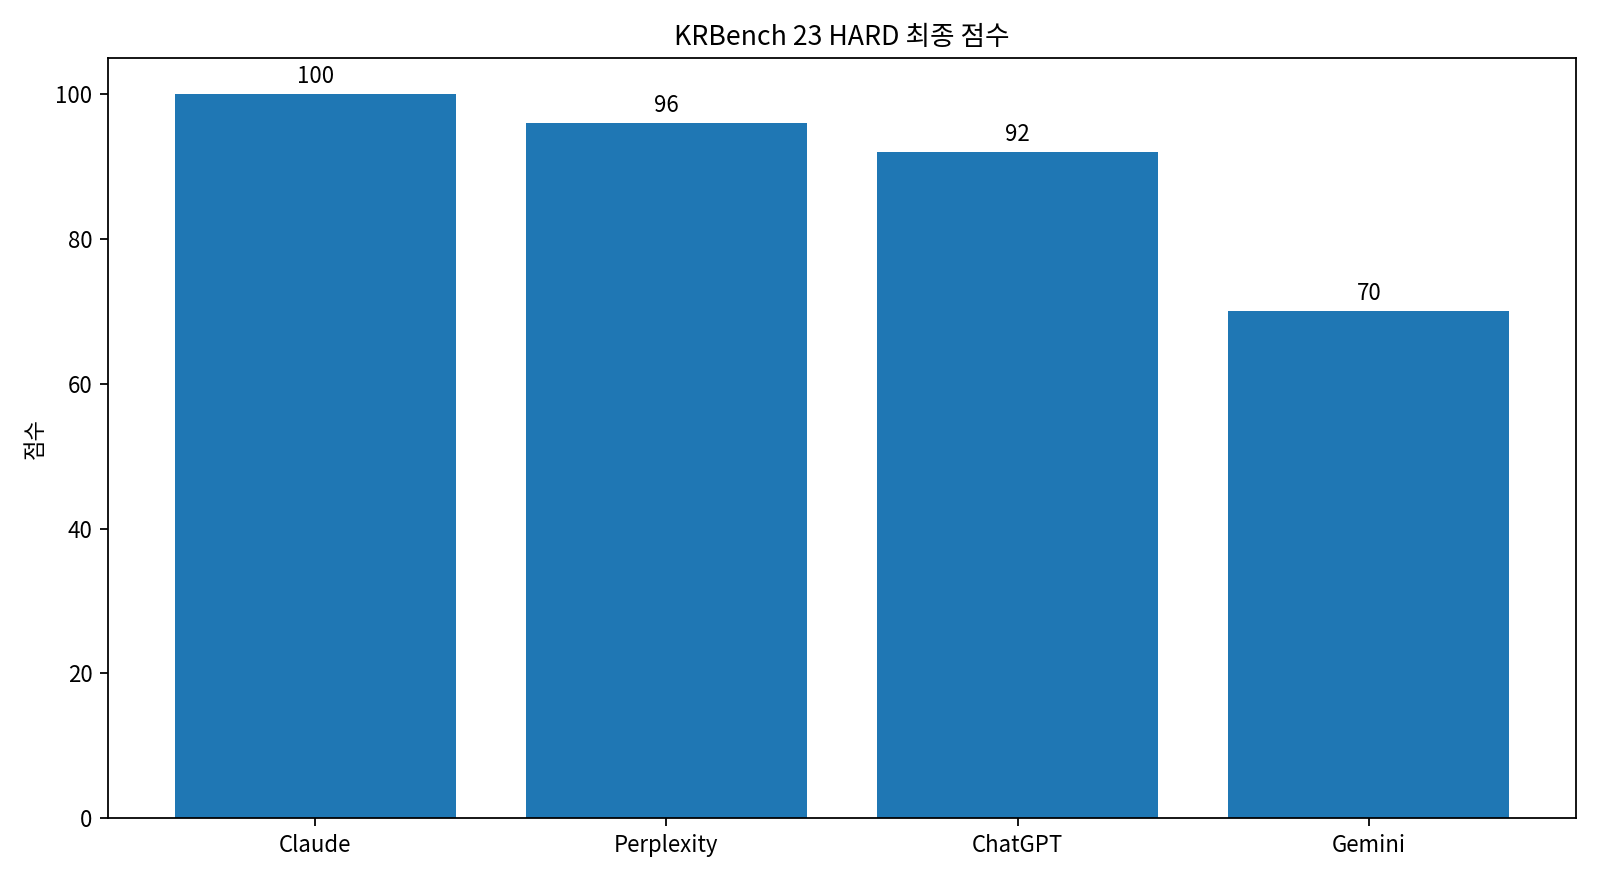
- Claude Sonnet 5.5 · 중간: 100/100 · 15초
- Perplexity: 96/100 · 16초
- ChatGPT: 92/100 · 18초
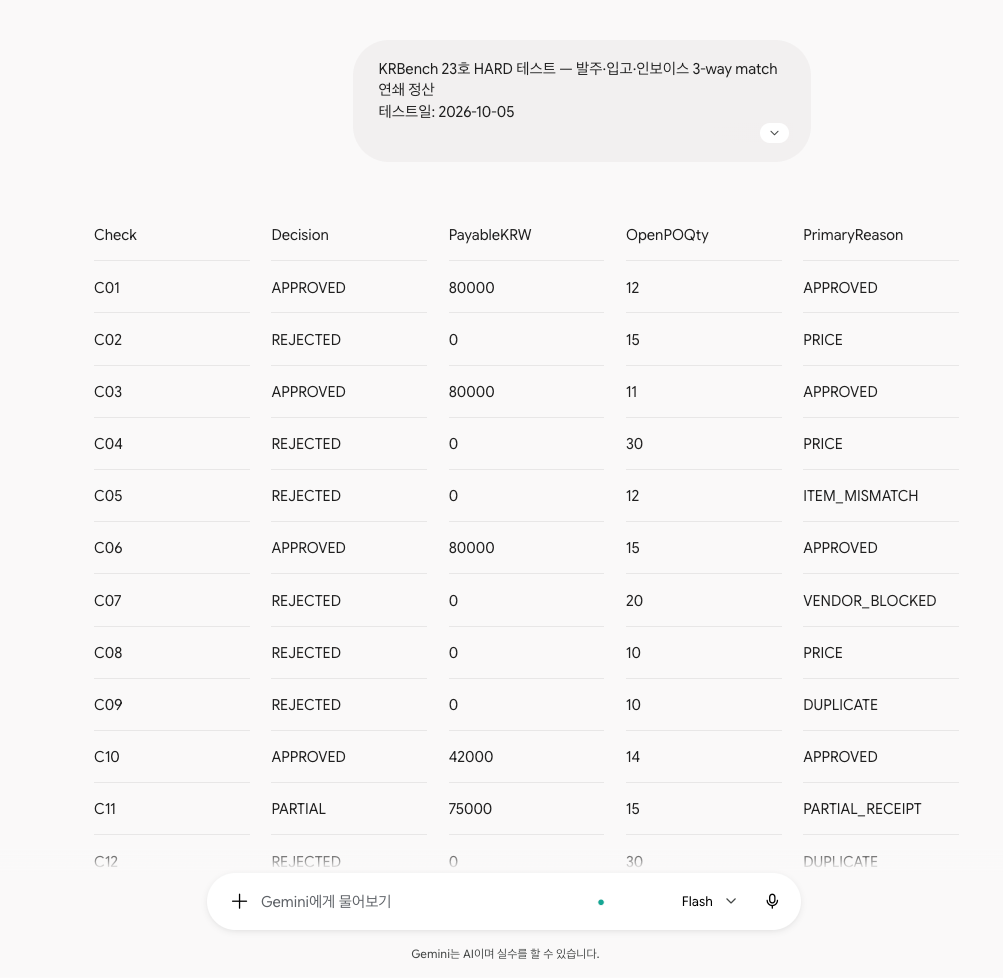
- Gemini Flash: 70/100 · 5초
- 최고점과 최저점의 차이는 30점이었습니다.
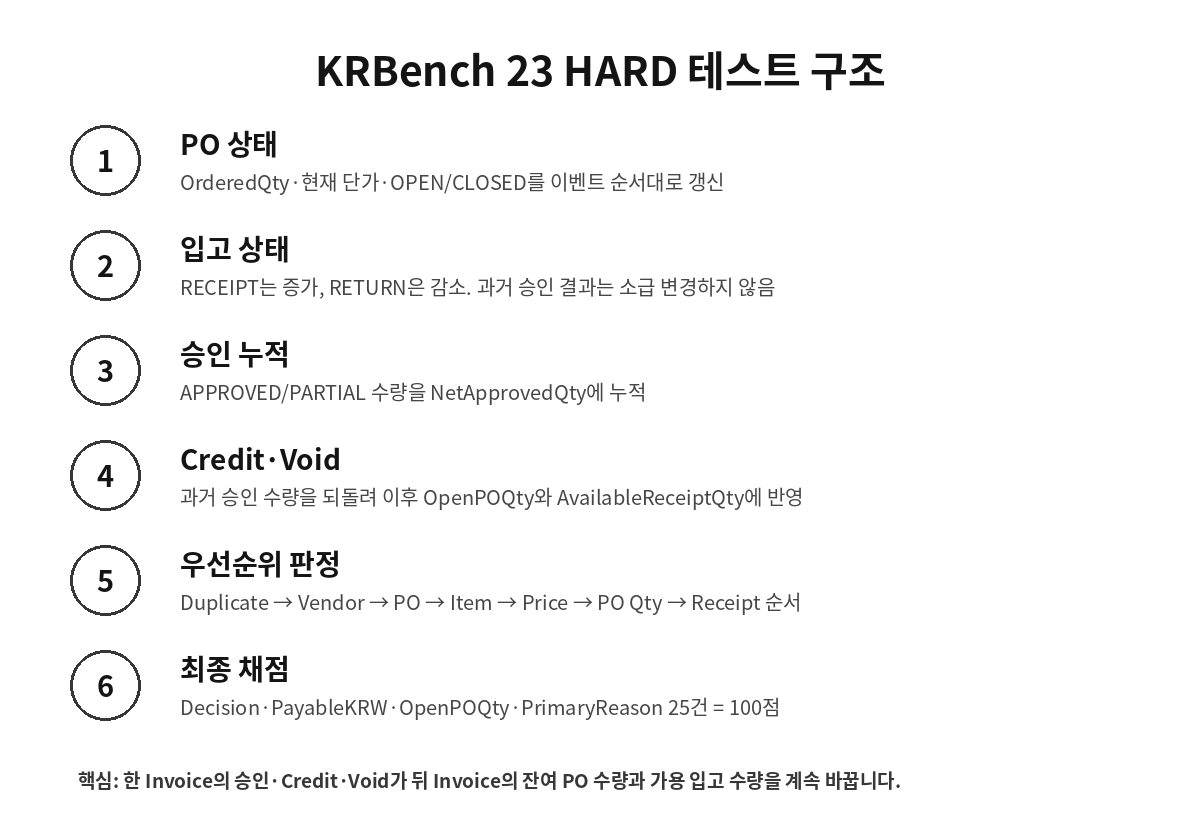
테스트 방법: PO·입고·인보이스 상태를 순서대로 누적
각 PO에는 현재 OrderedQty, UnitPriceKRW, OPEN/CLOSED 상태가 있고, 이벤트를 처리하면서 NetReceivedQty와 NetApprovedQty를 계속 갱신합니다.
OpenPOQty는 현재 OrderedQty에서 누적 승인 수량을 뺀 값이고, AvailableReceiptQty는 누적 입고 수량에서 누적 승인 수량을 뺀 값입니다. RETURN은 입고 수량을 줄이고, CREDIT_INVOICE와 VOID_INVOICE는 과거 승인 수량을 되돌립니다.
먼저 걸리는 하나의 거절 사유만 사용
각 인보이스는 정해진 순서로 판정했습니다. DUPLICATE → VENDOR_BLOCKED → PO_CLOSED → VENDOR_MISMATCH → ITEM_MISMATCH → PRICE → PO_QTY → NO_RECEIPT → PARTIAL_RECEIPT → APPROVED 순입니다.
예를 들어 잔여 PO 수량보다 Invoice Qty가 크면 입고 수량을 따지기 전에 PO_QTY로 전량 거절합니다. 반대로 PO 수량에는 문제가 없지만 가용 입고 수량만 부족하면 실제 입고된 범위만 PARTIAL 지급합니다.
가격은 현재 PO 단가보다 정확히 2% 높은 값까지 허용하고, 2%를 초과할 때만 PRICE로 거절했습니다.
Credit과 Void는 뒤 인보이스의 수량을 다시 바꾼다
CREDIT_INVOICE는 기존 승인 수량 중 지정된 수량을 되돌리고, VOID_INVOICE는 아직 Credit되지 않은 승인 수량을 모두 되돌립니다. 과거 CHECK 점수는 바뀌지 않지만, 이후 OpenPOQty와 AvailableReceiptQty는 다시 증가할 수 있습니다.
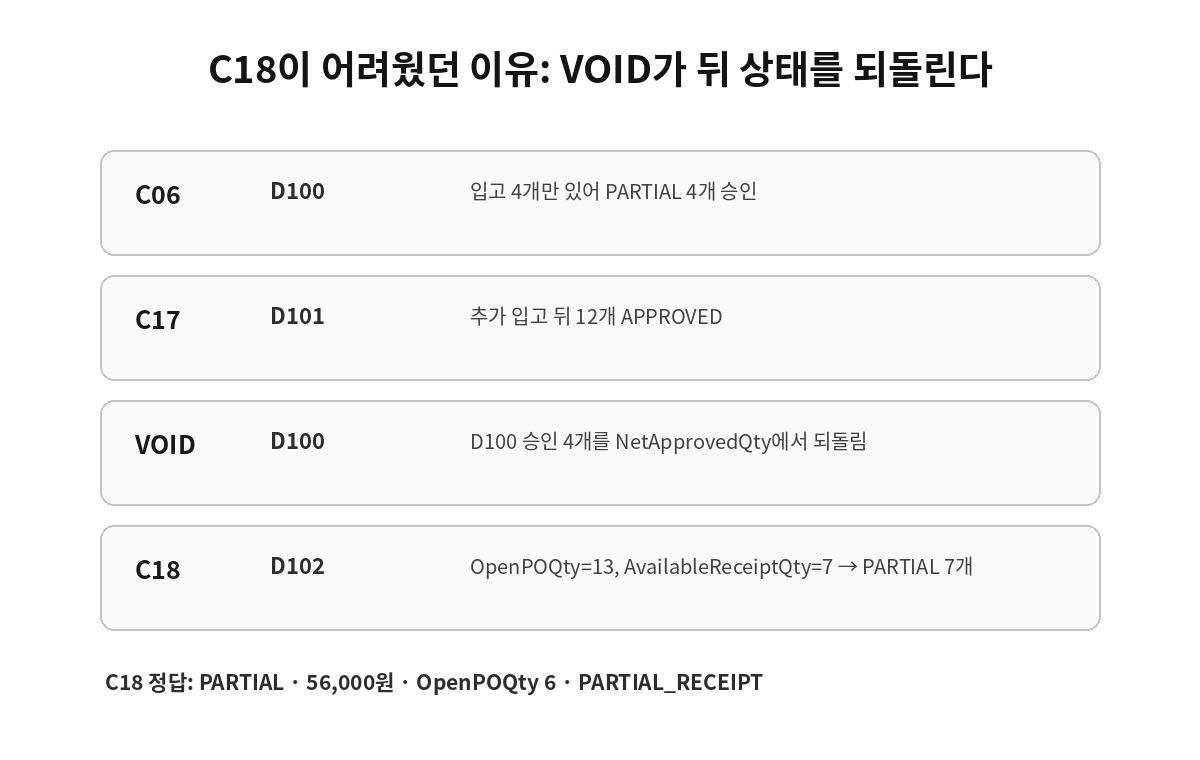
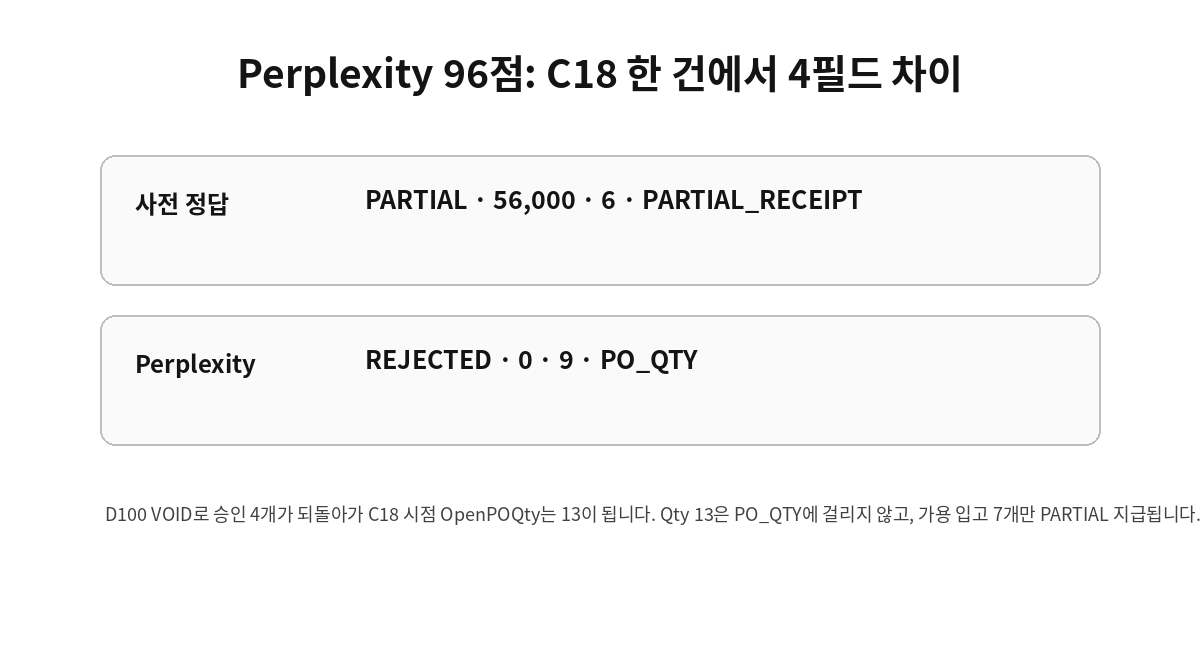
C18이 대표적인 예입니다. P05에서 C06의 D100이 입고 부족으로 4개만 승인됐고, C17에서 D101 12개가 승인됐습니다. 그 뒤 D100을 VOID하면서 승인 수량 4개가 되돌아갑니다.
따라서 C18 시점의 OpenPOQty는 13이고, Invoice Qty 13은 PO_QTY에 걸리지 않습니다. 다만 실제 가용 입고 수량은 7개뿐이므로 정답은 PARTIAL · 56,000원 · OpenPOQty 6 · PARTIAL_RECEIPT입니다.
채점 기준: 25개 CHECK × 4개 필드 = 100점
| 항목 | CHECK당 | 총 배점 |
|---|---|---|
| Decision | 1점 | 25점 |
| PayableKRW | 1점 | 25점 |
| OpenPOQty | 1점 | 25점 |
| PrimaryReason | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
숨은 정답과 채점 기준은 서비스 결과를 보기 전에 결정론적 상태 엔진으로 생성해 고정했습니다. 이벤트별 PO 상태, Vendor 상태, NetReceivedQty와 NetApprovedQty도 Oracle trace로 보존했습니다.
전체 결과: Claude 100점, Gemini 70점
| 서비스 | Decision | PayableKRW | OpenPOQty | PrimaryReason | 총점 | 응답시간 |
|---|---|---|---|---|---|---|
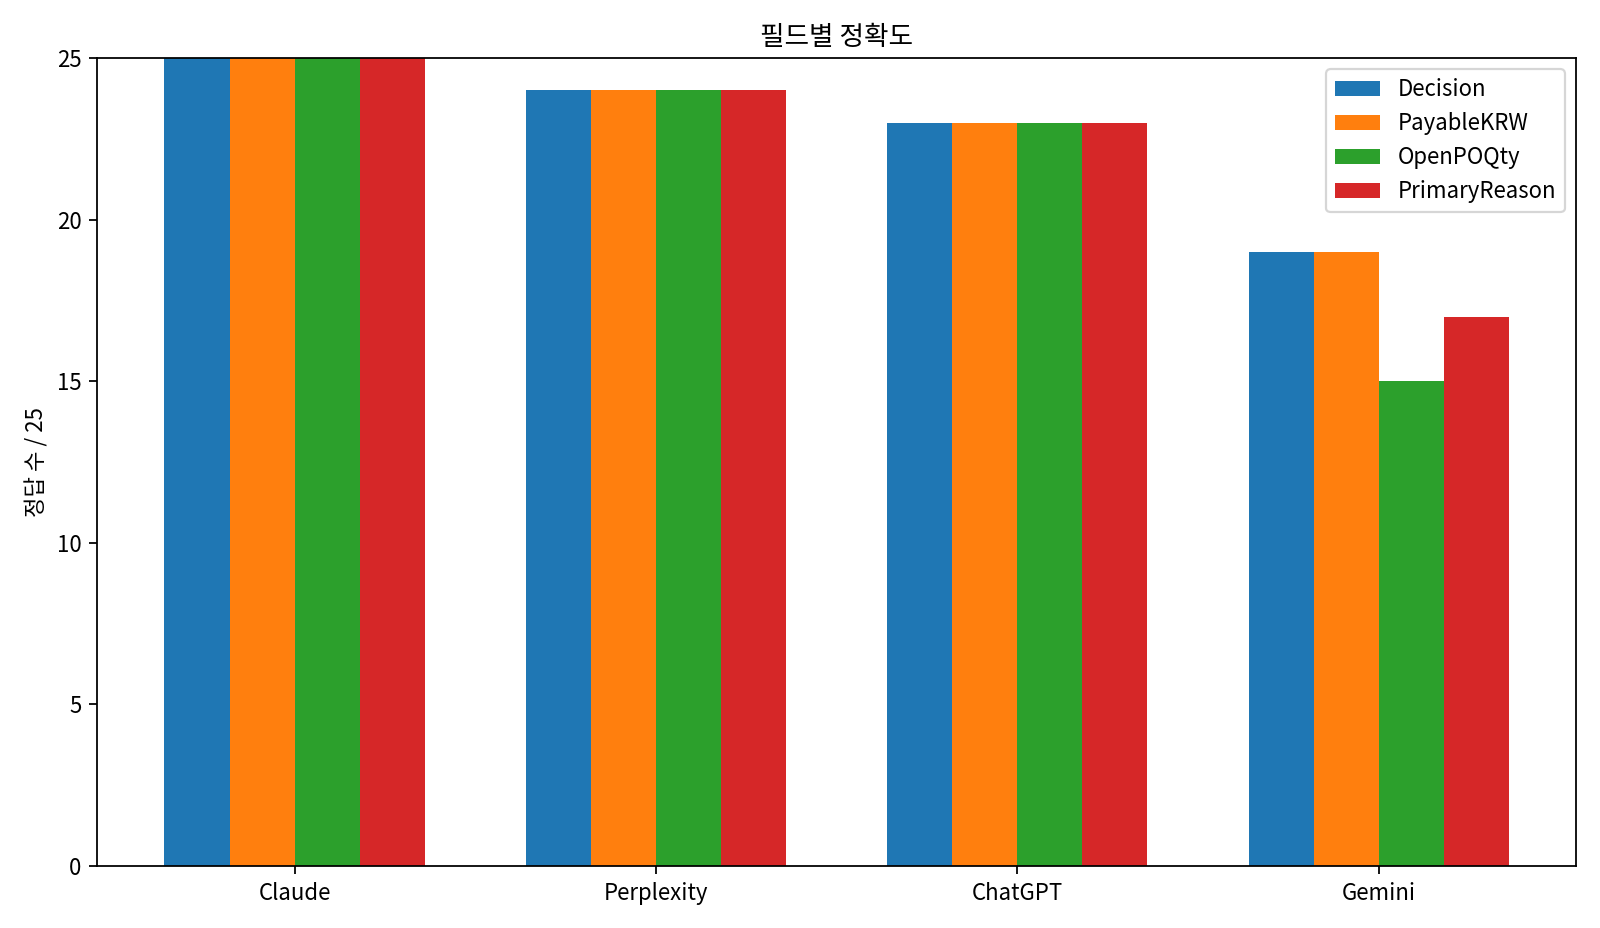
| Claude Sonnet 5.5 · 중간 | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 15초 |
| Perplexity | 24/25 | 24/25 | 24/25 | 24/25 | 96/100 | 16초 |
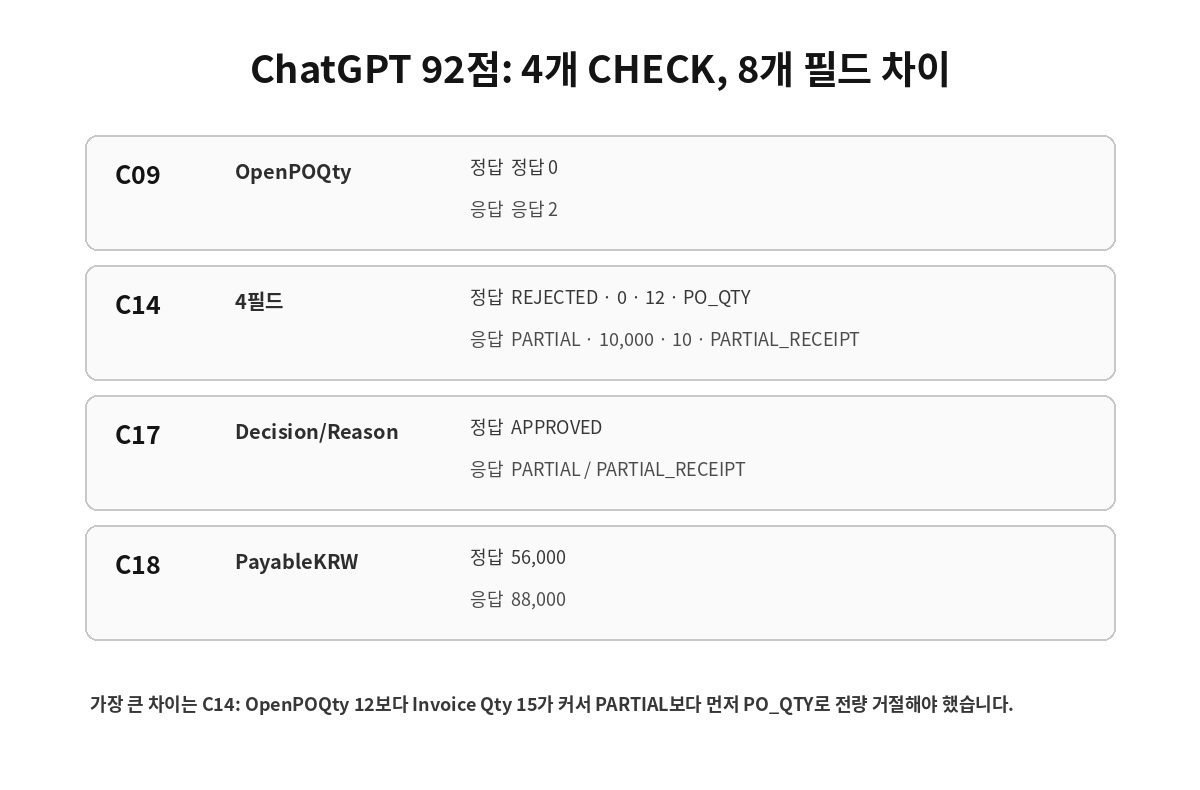
| ChatGPT | 23/25 | 23/25 | 23/25 | 23/25 | 92/100 | 18초 |
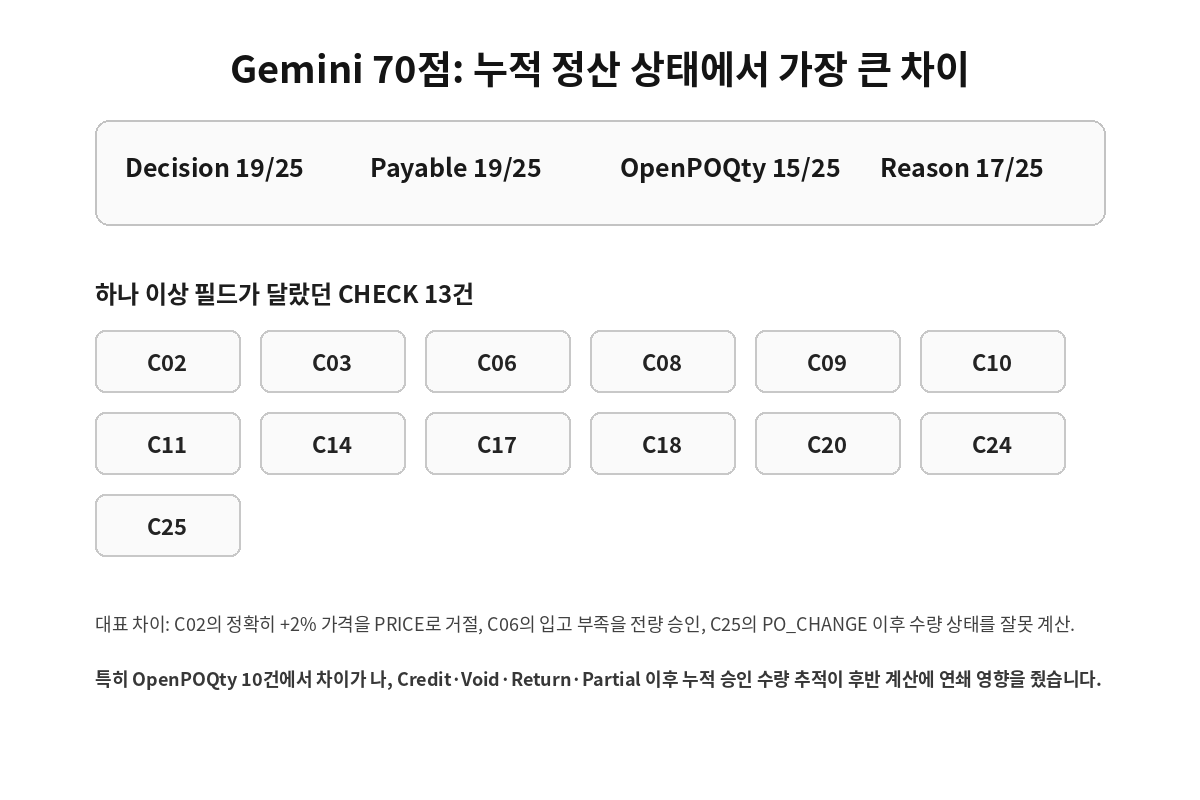
| Gemini Flash | 19/25 | 19/25 | 15/25 | 17/25 | 70/100 | 5초 |
Claude: 100개 채점 필드 모두 일치
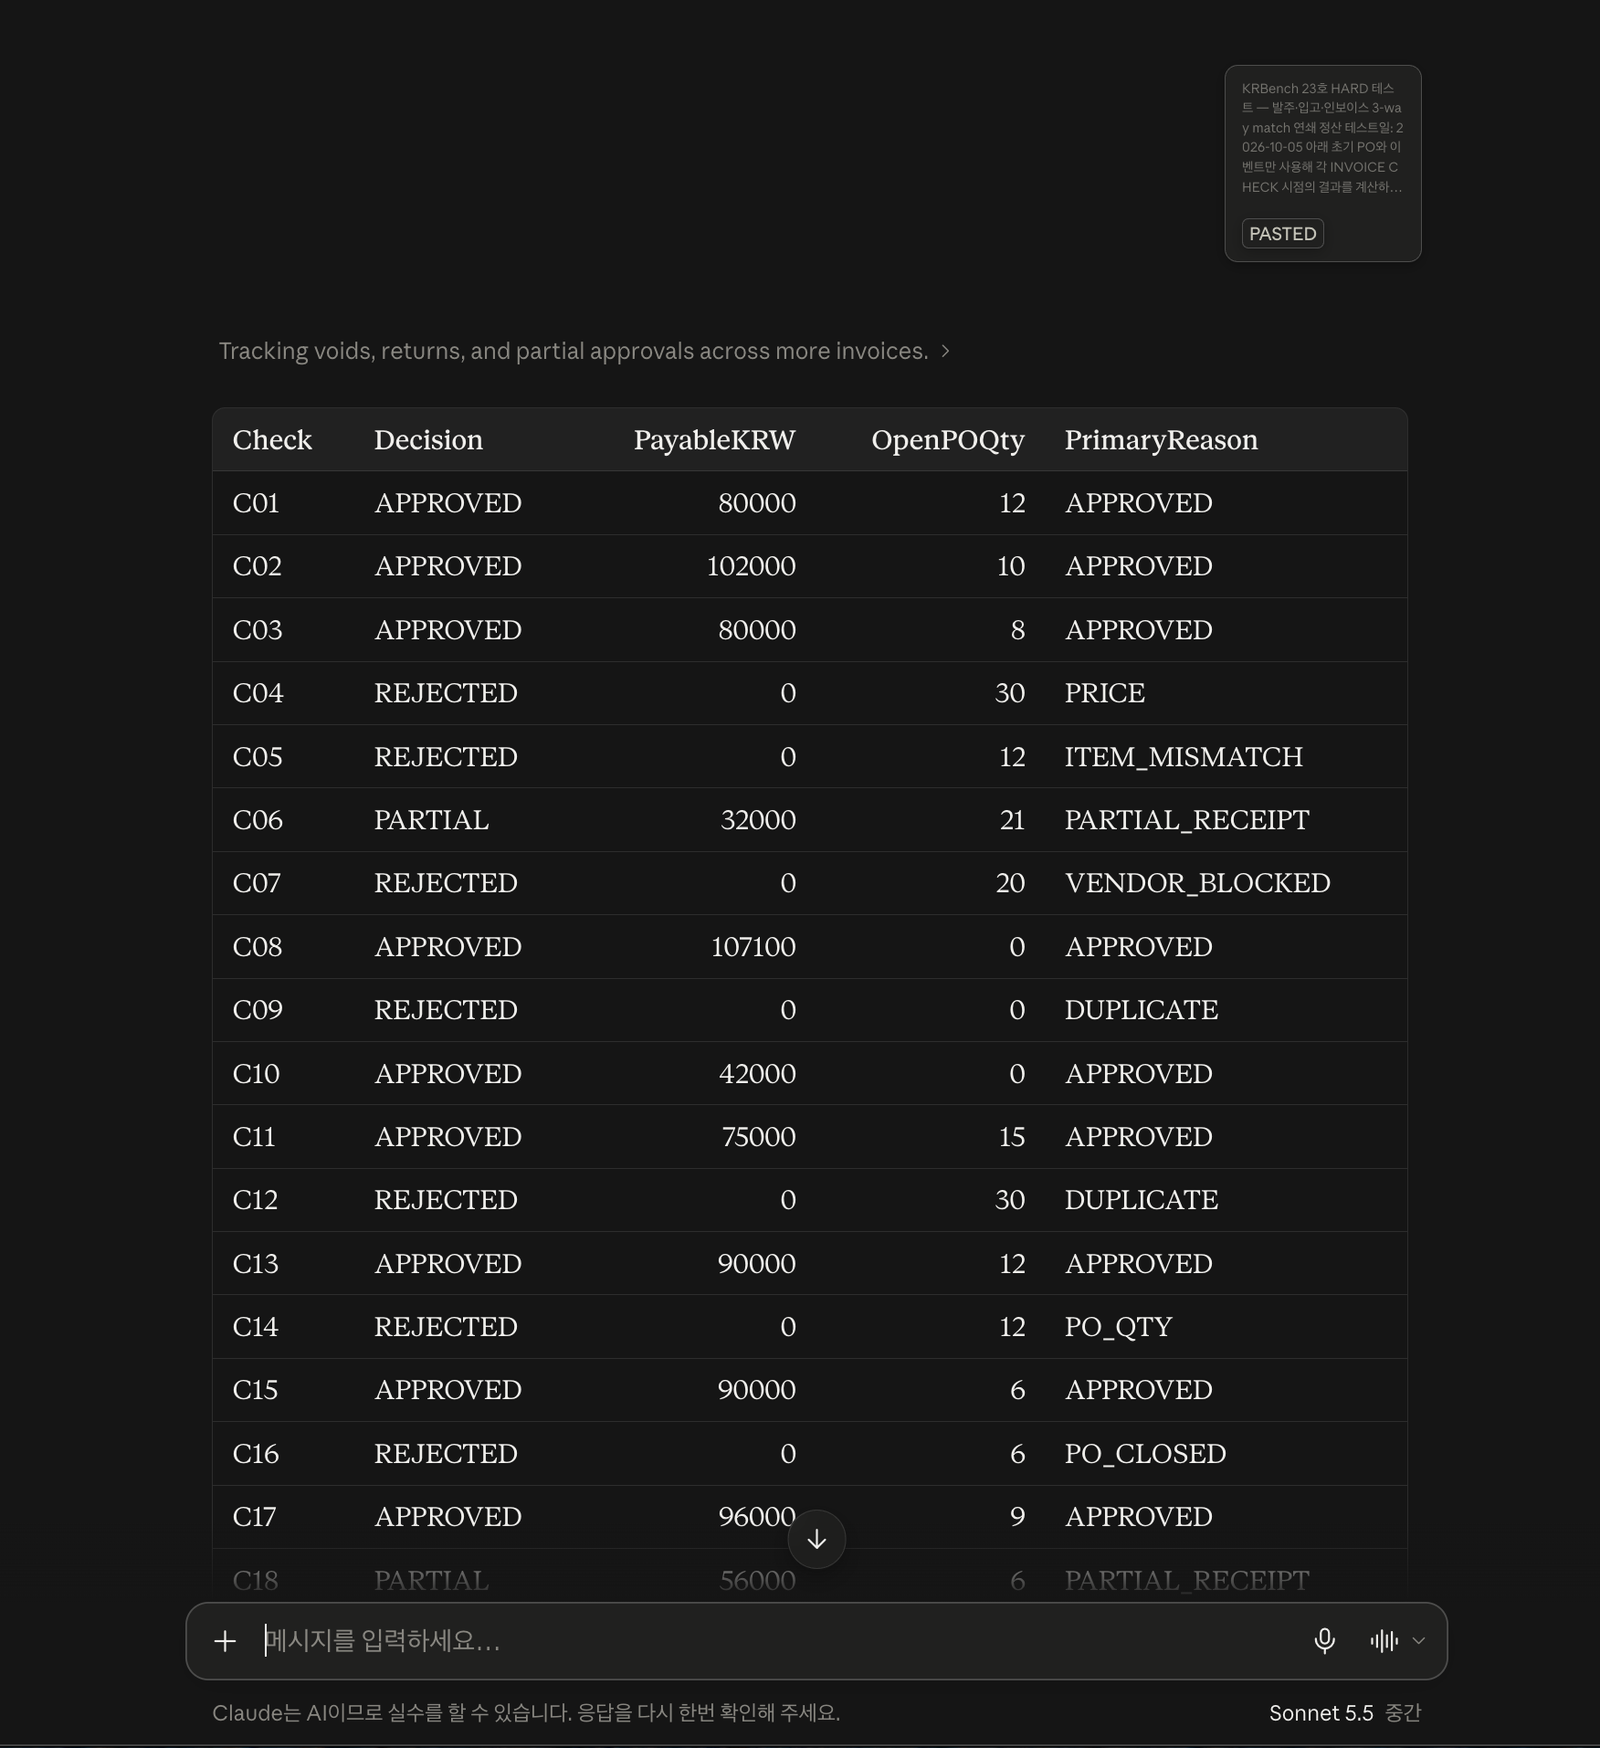
Claude Sonnet 5.5 · 중간은 C01~C25의 네 필드를 모두 맞혀 100점을 기록했습니다. 2% 가격 허용선, PARTIAL, PO_QTY 우선순위, Credit과 Void 이후의 누적 승인 수량까지 사전 Oracle과 모두 일치했습니다.
Perplexity 96점: C18 한 건에서만 차이
Perplexity는 24개 CHECK를 네 필드 모두 정확히 맞혔습니다. 차이는 C18 한 건으로, 네 필드가 모두 사전 정답과 달랐습니다.
Perplexity는 C18을 PO_QTY로 전량 거절했지만, D100을 VOID한 뒤 OpenPOQty가 13으로 회복되므로 Invoice Qty 13은 PO 수량을 초과하지 않습니다. 이후 AvailableReceiptQty 7개만 부분 지급하는 것이 사전 정답입니다.
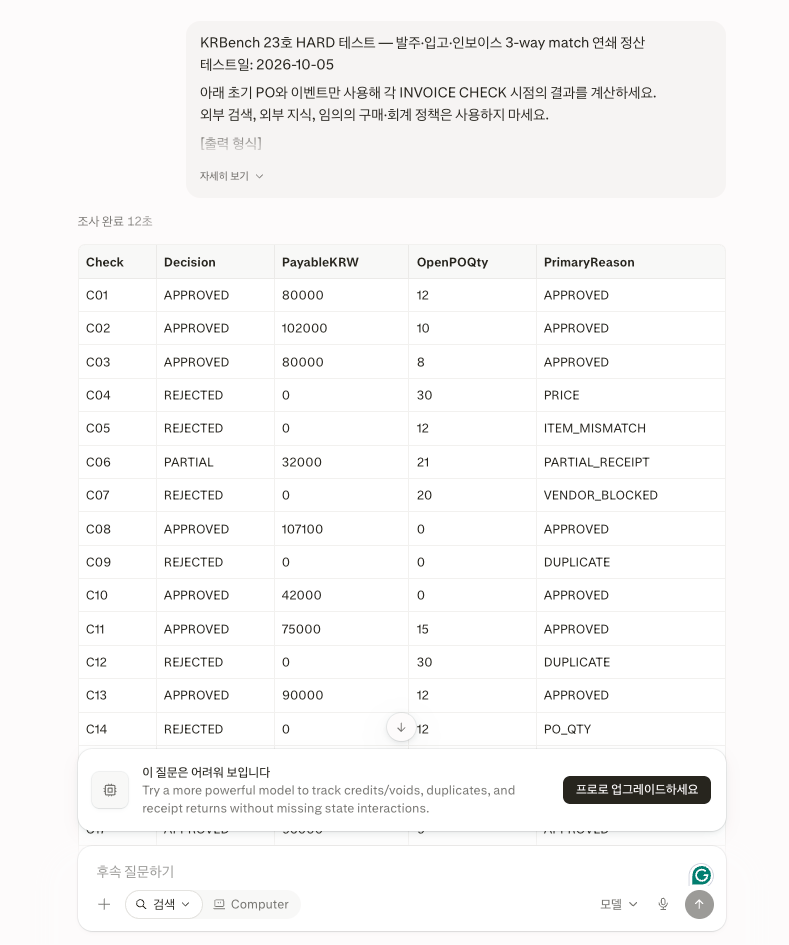
ChatGPT 92점: 네 CHECK에서 8개 필드 차이
ChatGPT는 Decision, PayableKRW, OpenPOQty, PrimaryReason에서 각각 23/25를 기록했습니다. 차이가 난 CHECK는 C09, C14, C17, C18입니다.
가장 큰 차이는 C14였습니다. C13까지 P03의 OpenPOQty가 12인데 C14의 Invoice Qty가 15이므로, 입고 부족 여부를 보기 전에 우선순위상 PO_QTY로 전량 REJECTED되어야 합니다. ChatGPT는 PARTIAL_RECEIPT로 판단했습니다.
C17은 지급액과 OpenPOQty는 맞았지만 Decision과 PrimaryReason을 PARTIAL로 표시했고, C18은 PARTIAL과 잔여 수량은 맞았지만 지급액을 56,000원이 아닌 88,000원으로 계산했습니다.
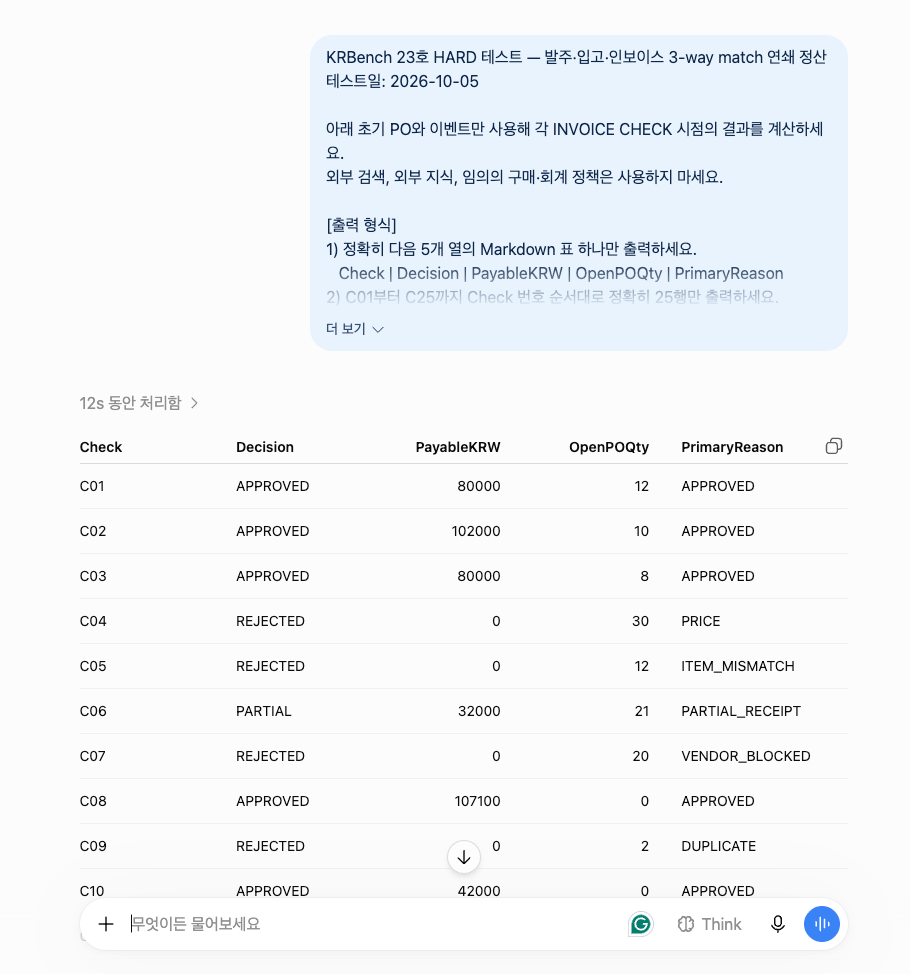
Gemini 70점: OpenPOQty 누적 추적에서 가장 큰 차이
Gemini Flash는 Decision 19/25, PayableKRW 19/25, OpenPOQty 15/25, PrimaryReason 17/25로 총 70점을 기록했습니다. 25개 CHECK 중 13개에서 하나 이상의 필드가 사전 정답과 달랐습니다.
C02에서는 PO 단가 20,000원의 정확히 2% 높은 20,400원을 PRICE로 거절했습니다. 테스트 규칙에서는 정확히 +2%까지 허용하므로 APPROVED가 정답입니다. 같은 가격 경계는 C08과 C25 같은 후속 상태에도 영향을 줍니다.
C06에서는 실제 입고가 4개뿐인데 Invoice Qty 10개를 전량 승인했고, Credit·Void·Return·PARTIAL 이후의 누적 승인 수량이 뒤 OpenPOQty에 연쇄적으로 반영되지 않은 결과도 여러 건 나타났습니다.
응답시간: 5초부터 18초
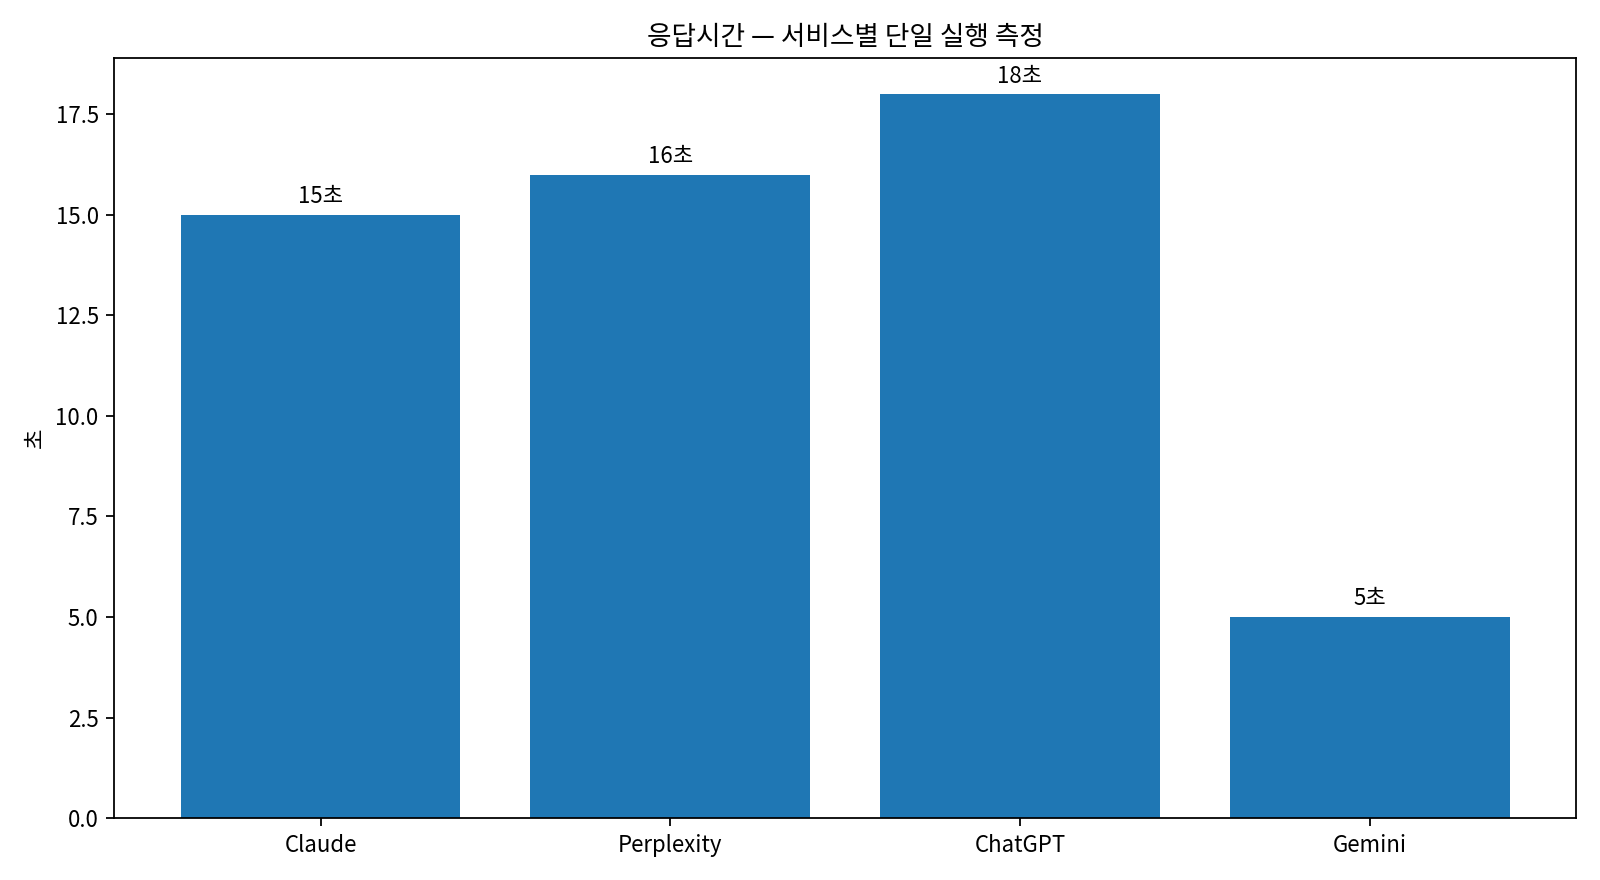
실측 응답시간은 Gemini 5초, Claude 15초, Perplexity 16초, ChatGPT 18초였습니다. 각 서비스에서 한 번만 측정한 값이므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
ChatGPT 화면에는 내부 처리시간으로 12초가 표시됐지만, 공식 기록은 다른 서비스와 같은 기준을 맞추기 위해 사용자가 전송 후 최종 답변이 화면에 모두 출력될 때까지 직접 측정한 18초를 사용했습니다.
NotebookLM은 공식 비교에서 제외
이번 테스트는 여러 문서에서 정보를 검색하는 작업이 아니라 하나의 긴 구매·정산 상태 프롬프트에서 이벤트를 순서대로 처리하는 문제입니다. NotebookLM은 다른 일반 채팅 서비스와 동일한 입력 경로를 맞추기 어려워 공식 비교에서 제외했습니다.
23호에서 확인된 점
이번 조건에서는 하나의 인보이스를 독립적으로 판단하는 것보다 앞선 승인·부분 승인·Credit·Void·Return이 현재 PO와 입고 잔량을 어떻게 바꿨는지를 유지하는 것이 더 중요했습니다.
특히 정확히 2%까지 허용하는 가격 경계처럼 단일 규칙을 먼저 잘못 적용하면 승인 수량이 달라지고, 그 차이가 뒤 OpenPOQty와 AvailableReceiptQty까지 전파될 수 있습니다. 23호의 최고·최저 점수 차이는 30점이었습니다.
이번 테스트의 한계
- 실제 ERP나 구매 시스템 데이터가 아니라 KRBench가 만든 합성 PO·입고·Invoice 데이터입니다.
- 세금, 배송비, 통화 환산, 분할 PO 라인, 승인 권한, 회계기간 잠금은 포함하지 않았습니다.
- 가격 허용 범위와 PrimaryReason 우선순위는 테스트를 위해 명시적으로 고정한 가상 정책입니다.
- Credit과 Void는 수량 기준으로 단순화했습니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
관련 KRBench 테스트
그룹 상속·Rule 우선순위·리소스 이동이 겹치면 AI가 접근 권한을 정확히 판정할까?
45개 순차 이벤트와 25개 CHECK로 접근 결정뿐 아니라 WinningRule, Principal, Scope 근거까지 비교했습니다.
→ AI 접근 권한 판정 HARD 테스트 보기11호~20호 업무 벤치마크 10편을 한 번에 보면?
문서 근거, 규정 판단, 상태 추적, 일정·예산·계약 계산에서 반복된 오류 유형과 HARD 전환 전후를 중간결산으로 정리했습니다.
→ KRBench 업무 벤치마크 10편 중간결산 보기Shift 편집·무효, PTO, 야간·휴일·초과근무가 겹치면 AI가 주간 급여를 정확히 다시 계산할까?
직원 5명의 순차 근태 이벤트와 25개 CHECK로 근무시간, 초과근무, 야간시간, 최종 급여를 100점으로 비교했습니다.
→ AI 근태·급여 연쇄 재계산 HARD 테스트 보기KRBench는 결과 차이가 크거나 작더라도 사전 정답과 채점 기준을 바꾸지 않고, 같은 조건에서 확인된 첫 응답을 그대로 기록합니다.