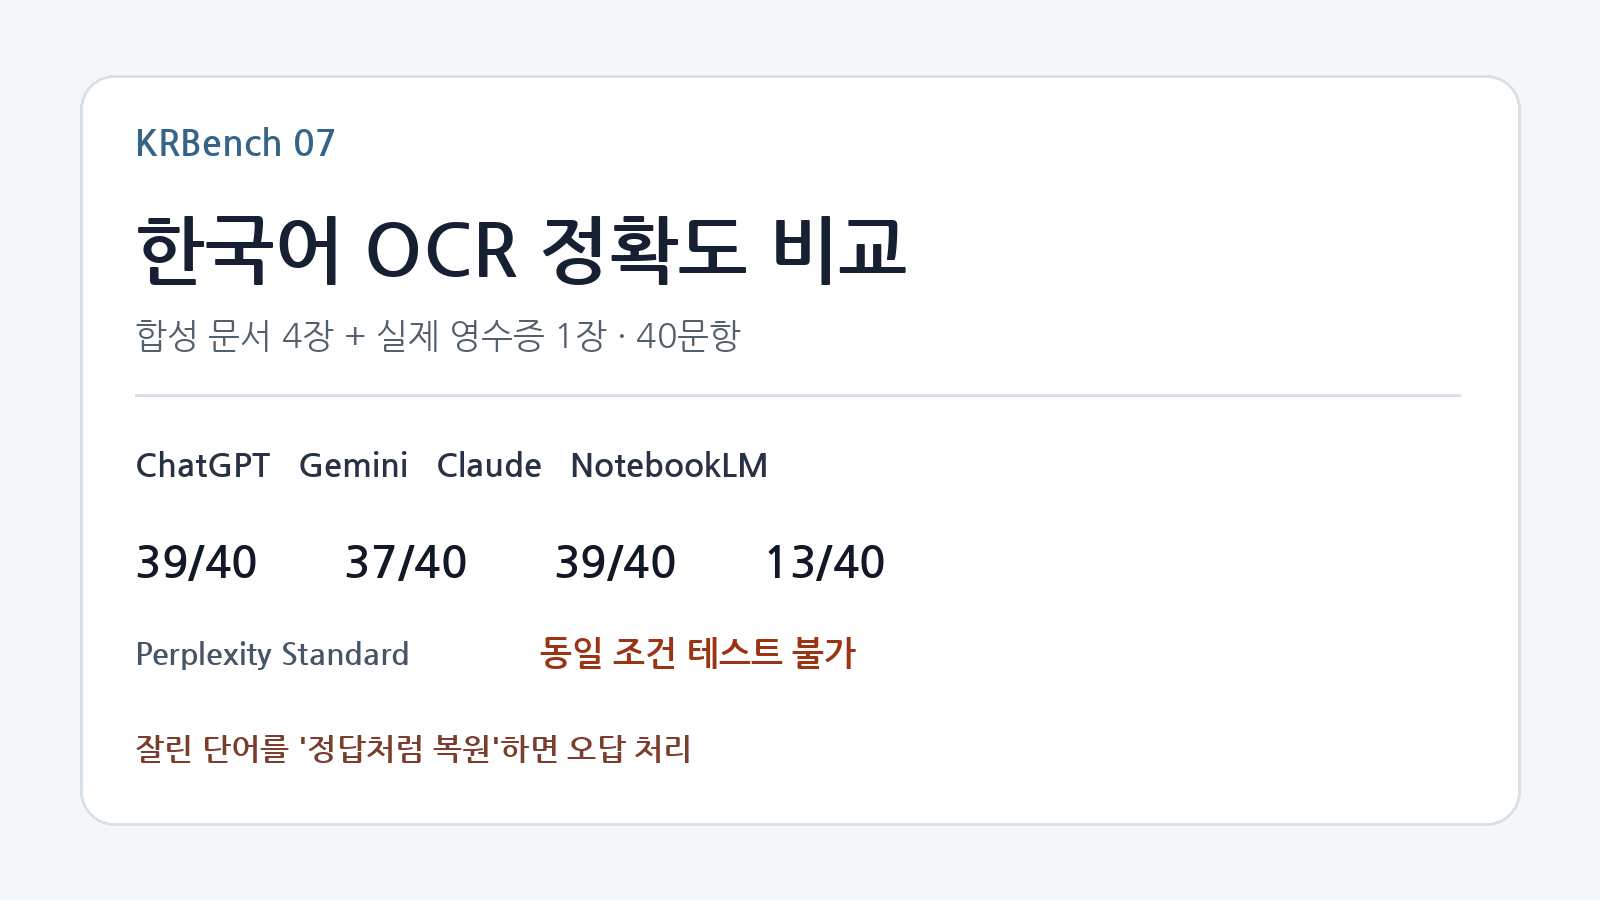
AI에게 영수증이나 스캔 문서 사진을 보여주면 글자를 얼마나 정확하게 읽을까?
KRBench는 ChatGPT, Gemini, Claude, NotebookLM에 같은 문서 이미지 5장과 40개 항목을 한 번에 입력했습니다. 깨끗한 합성 문서만 쓰지 않고, 저대비 열전사 영수증과 O/0·I/1·l/1 혼합문자, 그리고 실제 영수증까지 포함했습니다.
결과 요약
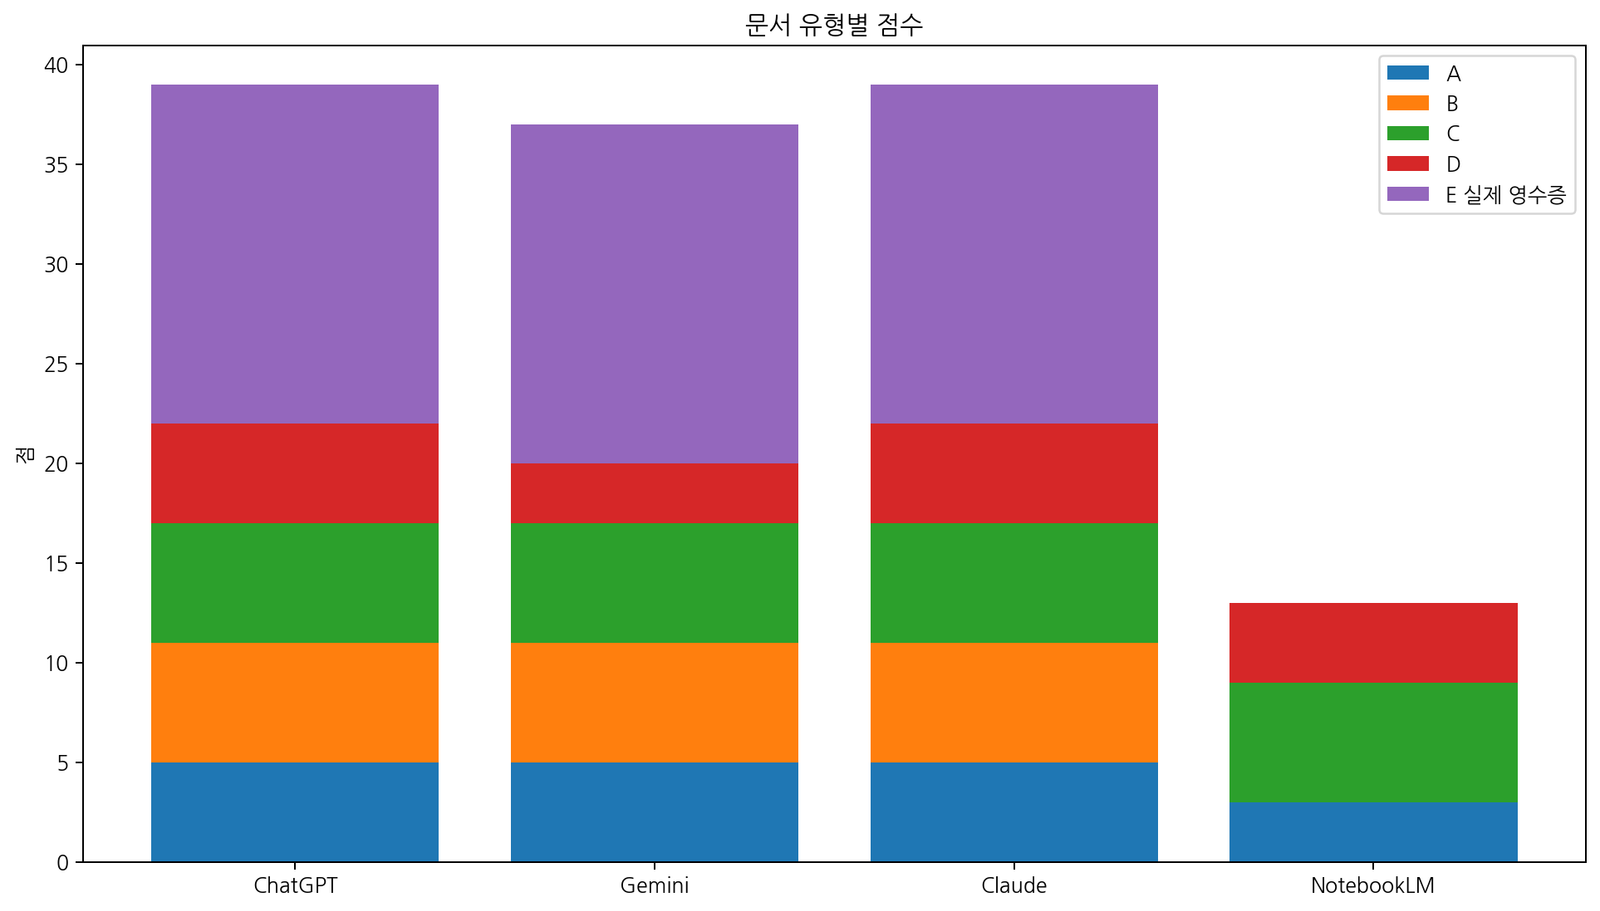
- ChatGPT: 39/40 (97.5%)
- Gemini: 37/40 (92.5%)
- Claude: 39/40 (97.5%)
- NotebookLM: 13/40 (32.5%)
- Perplexity Standard(무료): 동일 조건 테스트 불가
왜 이번 테스트는 잘린 단어를 그대로 읽게 했나
OCR에서는 그럴듯하게 고쳐주는 것보다 이미지에 실제로 보이는 문자를 그대로 전사하는 것이 중요할 때가 있습니다.
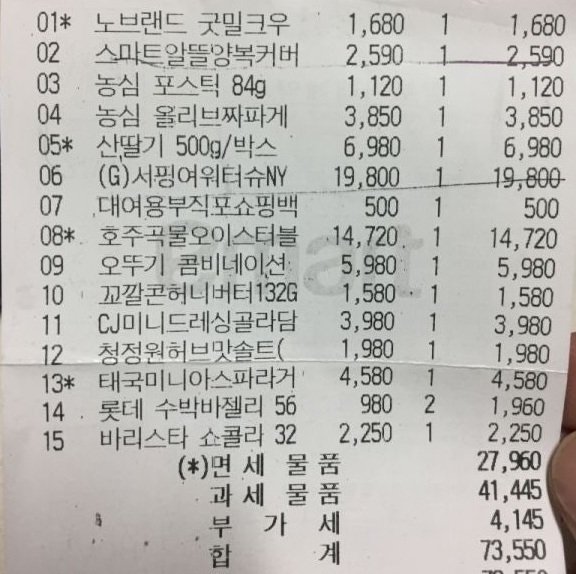
실제 영수증에는 인쇄 폭 때문에 상품명이 중간에서 잘린 항목이 있었습니다. 예를 들어 정답은 ‘노브랜드 굿밀크 우’인데, 이를 상식적으로 ‘노브랜드 굿밀크 우유’로 완성하면 이번 테스트에서는 오답입니다.
같은 방식으로 ‘농심 올리브 짜파게’, ‘호주 곡물 오이스터블’, ‘태국 미니 아스파라거’처럼 실제 인쇄된 부분까지만 Ground Truth로 사용했습니다.
테스트 문서와 40문항
| 문서 | 특징 | 배점 |
|---|---|---|
| A | 촬영형 거래명세서, 잘린 문자열 | 5 |
| B | 저대비·기울기·블러가 있는 열전사 영수증 | 6 |
| C | 비슷한 숫자가 반복되는 행·열 표 | 6 |
| D | O/0, I/1, l/1, 대소문자·기호 혼합 | 5 |
| E | 실제 영수증 원본 | 18 |
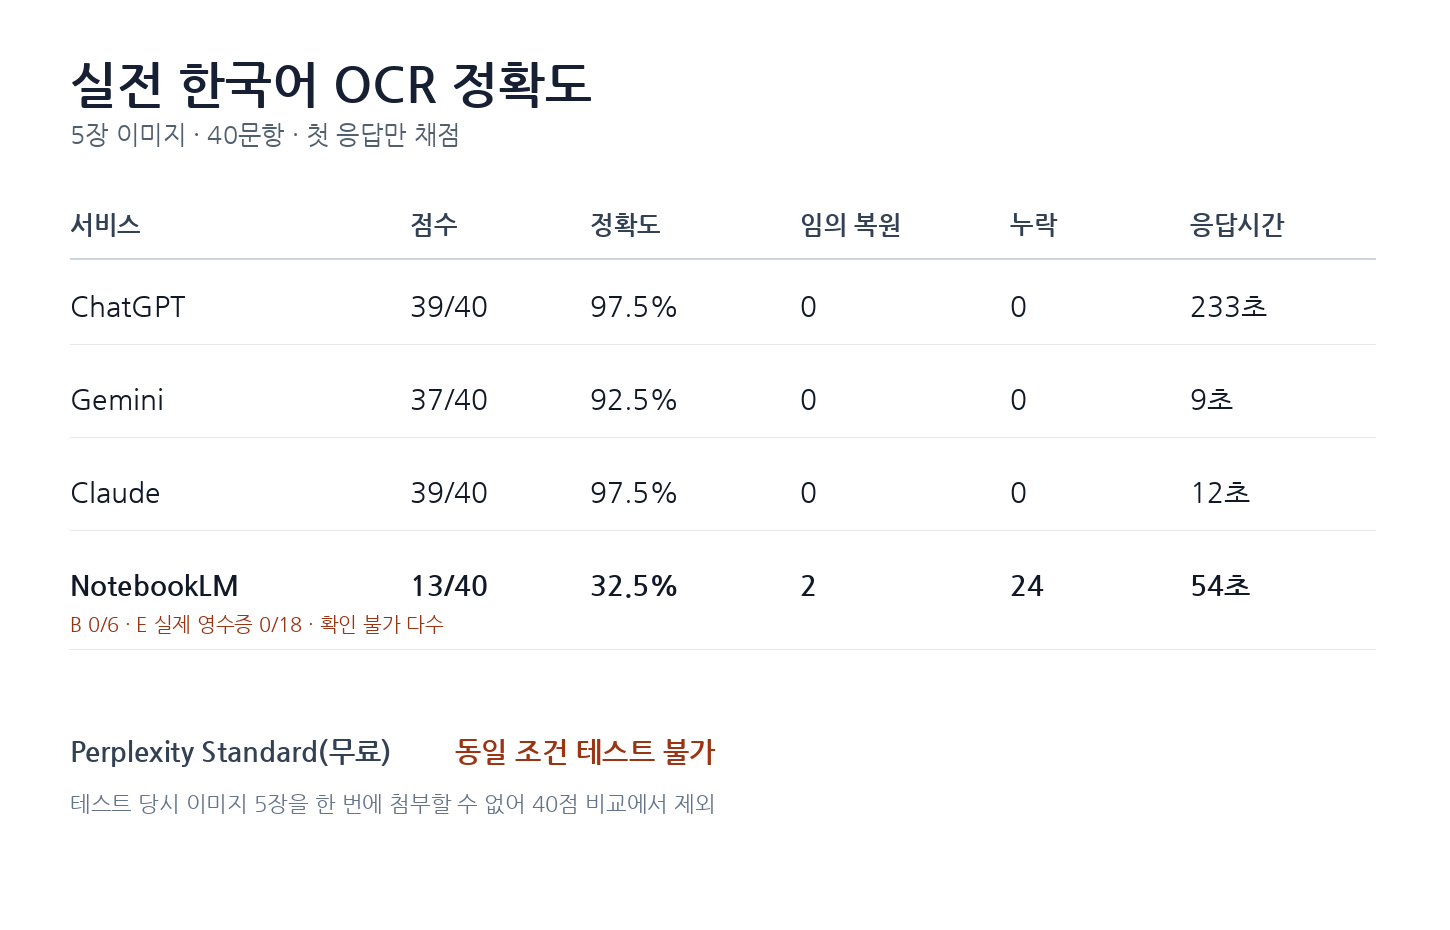
최종 정확도 결과
| 서비스 | 점수 | 정확도 | 임의 복원 | 누락 | 응답시간 |
|---|---|---|---|---|---|
| ChatGPT | 39/40 | 97.5% | 0 | 0 | 233초 |
| Gemini | 37/40 | 92.5% | 0 | 0 | 9초 |
| Claude | 39/40 | 97.5% | 0 | 0 | 12초 |
| NotebookLM | 13/40 | 32.5% | 2 | 24 | 54초 |
| Perplexity Standard | 동일 조건 테스트 불가 — 테스트 당시 무료 버전에서 이미지 5장을 한 번에 첨부할 수 없었음 | ||||
ChatGPT와 Claude는 39/40, 오답도 같았다
ChatGPT와 Claude는 모두 A~D 문서를 전부 맞혔고, 실제 영수증 E에서 17/18을 기록했습니다.
두 서비스의 유일한 감점은 E18이었습니다. 정답은 ‘롯데 수박바 젤리 56g’인데 두 서비스 모두 마지막 g를 누락했습니다.
잘린 상품명을 ‘우유’, ‘짜파게티’, ‘아스파라거스’처럼 완성하는 임의 복원 오류는 두 서비스 모두 0건이었습니다.
Gemini는 O와 0에서 두 번 틀렸다
Gemini는 37/40을 기록했습니다. 실제 영수증 E에서는 ChatGPT·Claude와 똑같이 E18의 g를 누락했고, 혼합문자 D에서 두 문항을 추가로 놓쳤습니다.
- D1:
OQ-10I8-B7l2→0Q-10I8-B7l2 - D5:
8B0D-I1O7-4l2Q→8B0D-I107-4l2Q
즉 이번 샘플에서는 대문자 O와 숫자 0을 구분하는 문제에서 차이가 났습니다.
NotebookLM은 표는 맞혔지만 영수증 이미지에서 확인 불가가 많았다
NotebookLM은 C 고밀도 표를 6/6으로 정확하게 읽었습니다. D 혼합문자도 4/5로 대부분 맞았습니다.
하지만 B 열전사 영수증은 6문항 모두, E 실제 영수증은 18문항 모두 ‘확인 불가’로 답했습니다. 또한 A의 잘린 문자열 두 곳을 ‘데이터솔루션’, ‘패키지’로 완성해 임의 복원 오류 2건이 발생했습니다.
‘확인 불가’는 없는 값을 만든 것이 아니므로 환각으로 세지 않았습니다. 이번 테스트에서 NotebookLM의 환각 건수는 0건입니다.
응답시간은 정확도와 별개로 큰 차이가 났다
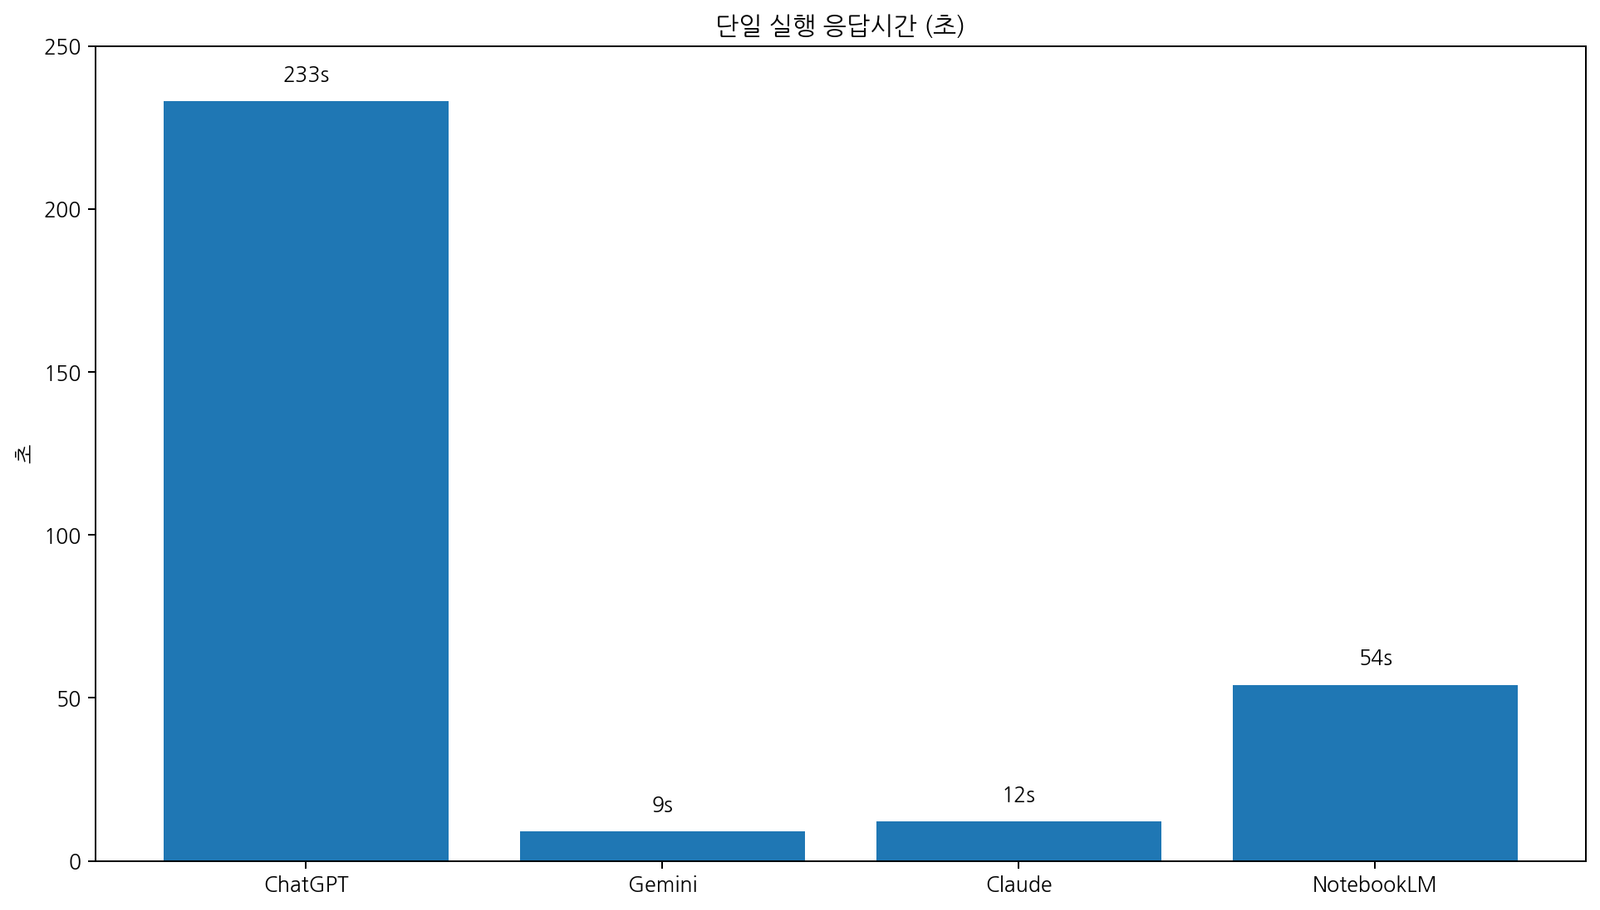
- Gemini: 9초
- Claude: 12초
- NotebookLM: 54초
- ChatGPT: 233초
응답시간은 각각 한 번만 측정한 값입니다. 네트워크·서버 부하·모델 처리 방식에 따라 달라질 수 있으므로 일반적인 서비스 속도 순위로 확대해 해석하지 않았습니다.
Perplexity 무료 버전은 왜 점수가 없나
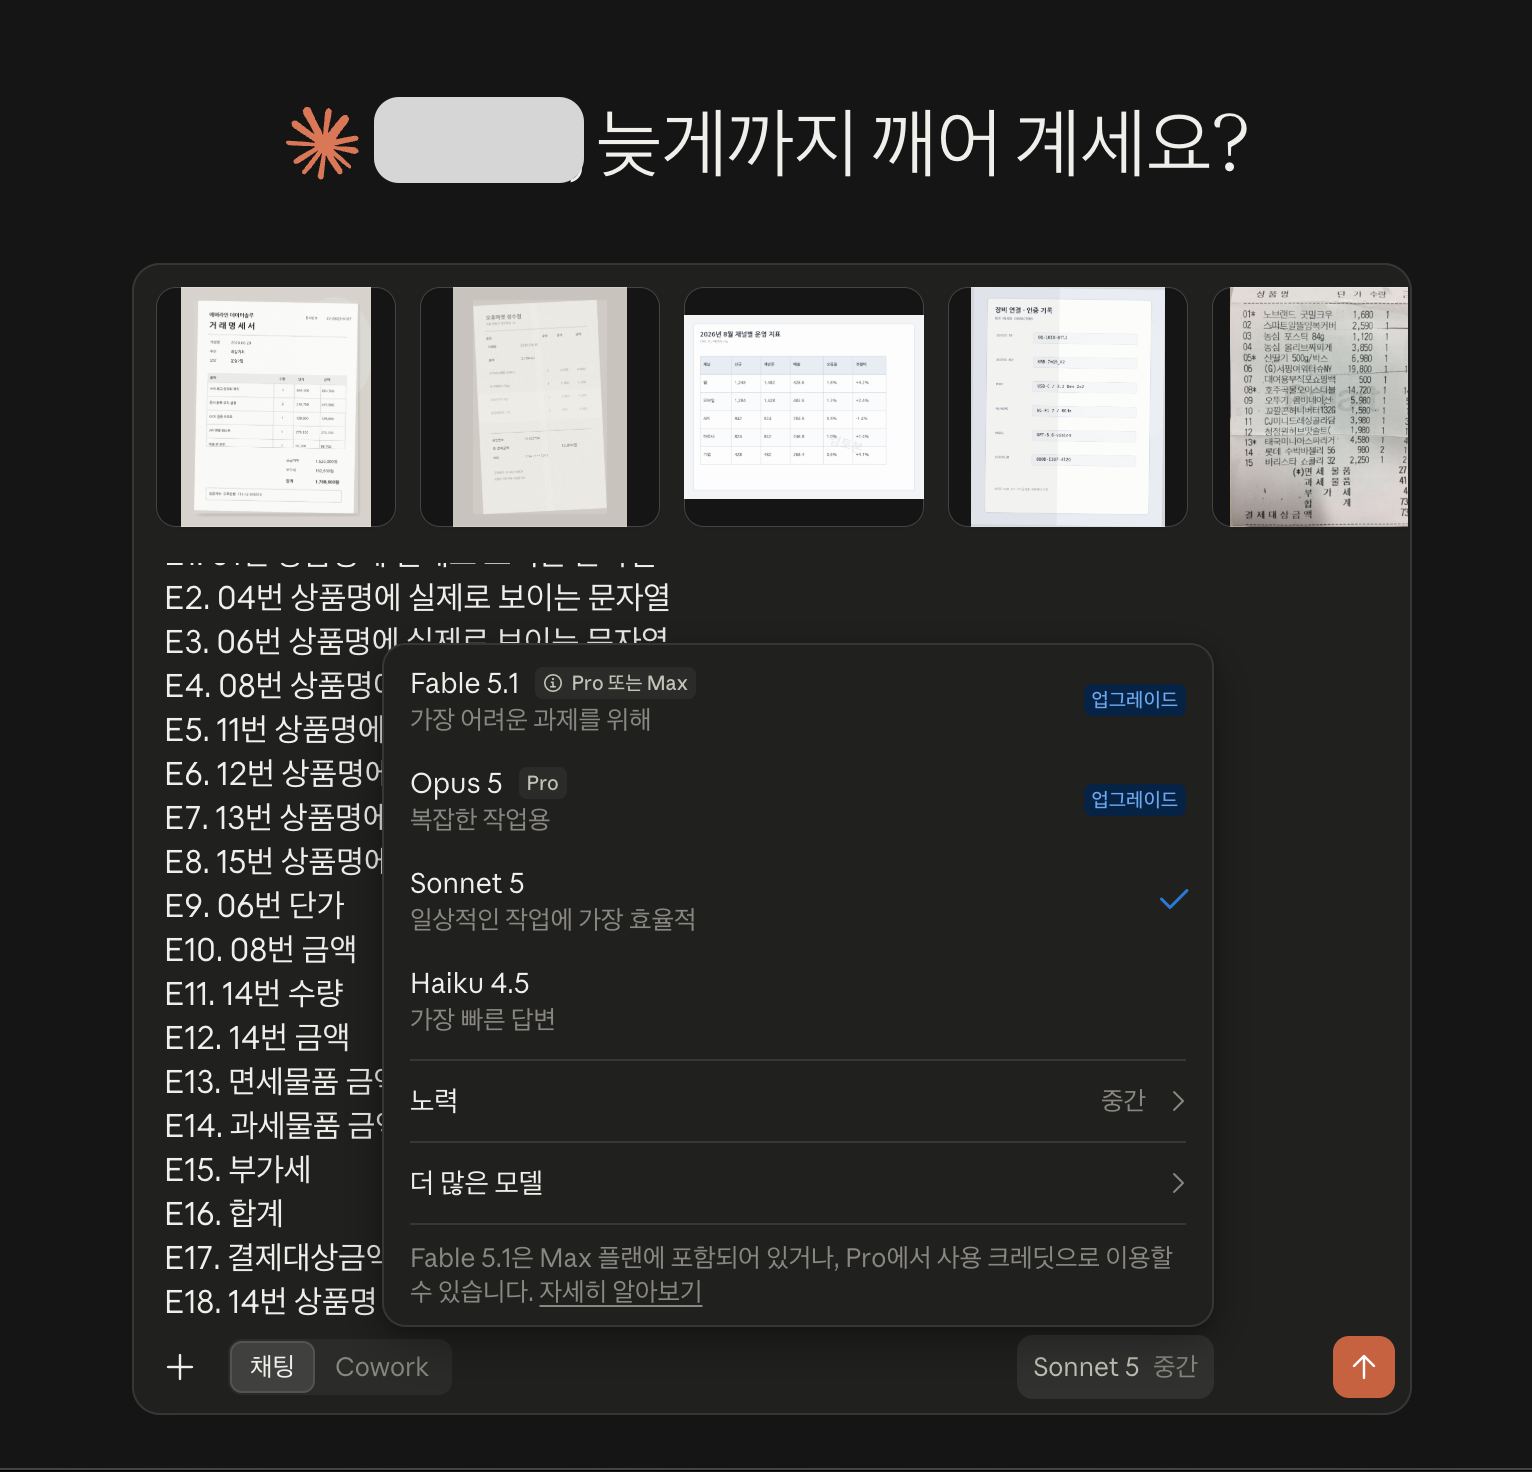
Perplexity Standard(무료)에서는 이번 테스트 당시 이미지 5장을 한 번에 첨부할 수 없었습니다. A~C와 D~E로 나눠 두 번 질문하거나 5장을 한 장으로 합치면 다른 서비스와 입력 조건이 달라집니다.
그래서 억지로 점수를 만들지 않고 동일 조건 테스트 불가로 기록했습니다. Perplexity 공식 도움말에서도 Standard 무료 플랜의 파일 업로드는 제한적이며, Pro에서는 파일·첨부 업로드와 분석 한도가 증가한다고 안내합니다.
이번 테스트의 한계
- 문서 이미지 5장과 40문항으로 진행한 단일 샘플 테스트입니다.
- 한국어 손글씨는 포함하지 않았습니다.
- 사진 촬영 환경과 해상도가 달라지면 결과도 달라질 수 있습니다.
- 한글 띄어쓰기 차이는 감점하지 않았습니다.
- 숫자 값이 동일한 경우 쉼표나 ‘원’ 같은 통상 단위 차이는 허용했습니다.
- 응답시간은 각 서비스 1회 측정값입니다.
관련 KRBench 테스트
텍스트 PDF를 읽고 계산할 때는 결과가 어떻게 달랐을까?
같은 7페이지 한국어 PDF와 10개 질문으로 문서 이해 정확도를 비교했습니다.
→ 한국어 PDF AI 정확도 비교 보기AI 이미지 속 한글 생성 정확도도 직접 비교했습니다.
ChatGPT, Gemini, Ideogram, Firefly, Canva에 같은 한글 문구를 넣어 정확도를 확인했습니다.
→ AI 이미지 한글 텍스트 정확도 비교 보기KRBench는 같은 조건에서 직접 시험하고, 실제 측정값과 실패 조건을 함께 기록합니다. 동일 조건으로 비교할 수 없었던 서비스에는 억지로 점수를 부여하지 않습니다.
문서 사진이 아니라 CSV 데이터를 계산하게 하면 얼마나 정확할까?
ChatGPT, Gemini, Claude, NotebookLM, Perplexity에 같은 한국어 이커머스 CSV 180행과 25개 질문을 넣어 조회, 필터, 집계, 비율, 순매출, 데이터 오류 탐지 정확도를 직접 비교했습니다.
→ AI CSV 데이터 분석 정확도 비교 보기