고객 문의나 상담 기록을 AI에 넣기 전에 이름·전화번호·이메일·계좌번호 같은 개인정보만 정확히 가리고, 주문번호·상품코드·버전명은 그대로 남길 수 있을까?
KRBench 12호에서는 가상의 고객 기록 25개를 만들었습니다. 개인정보 50개와 모양은 비슷하지만 가리면 안 되는 비개인 식별자 25개를 함께 넣고, ChatGPT·Gemini·Claude·NotebookLM·Perplexity에 같은 TXT 파일과 같은 프롬프트를 입력했습니다.
결과 요약
- ChatGPT: 100/100 · 9초
- Claude Sonnet 5 · 중간: 100/100 · 29초
- Perplexity: 100/100 · 7초
- Gemini Flash: 98/100 · 10초
- NotebookLM: 98/100 · 89초
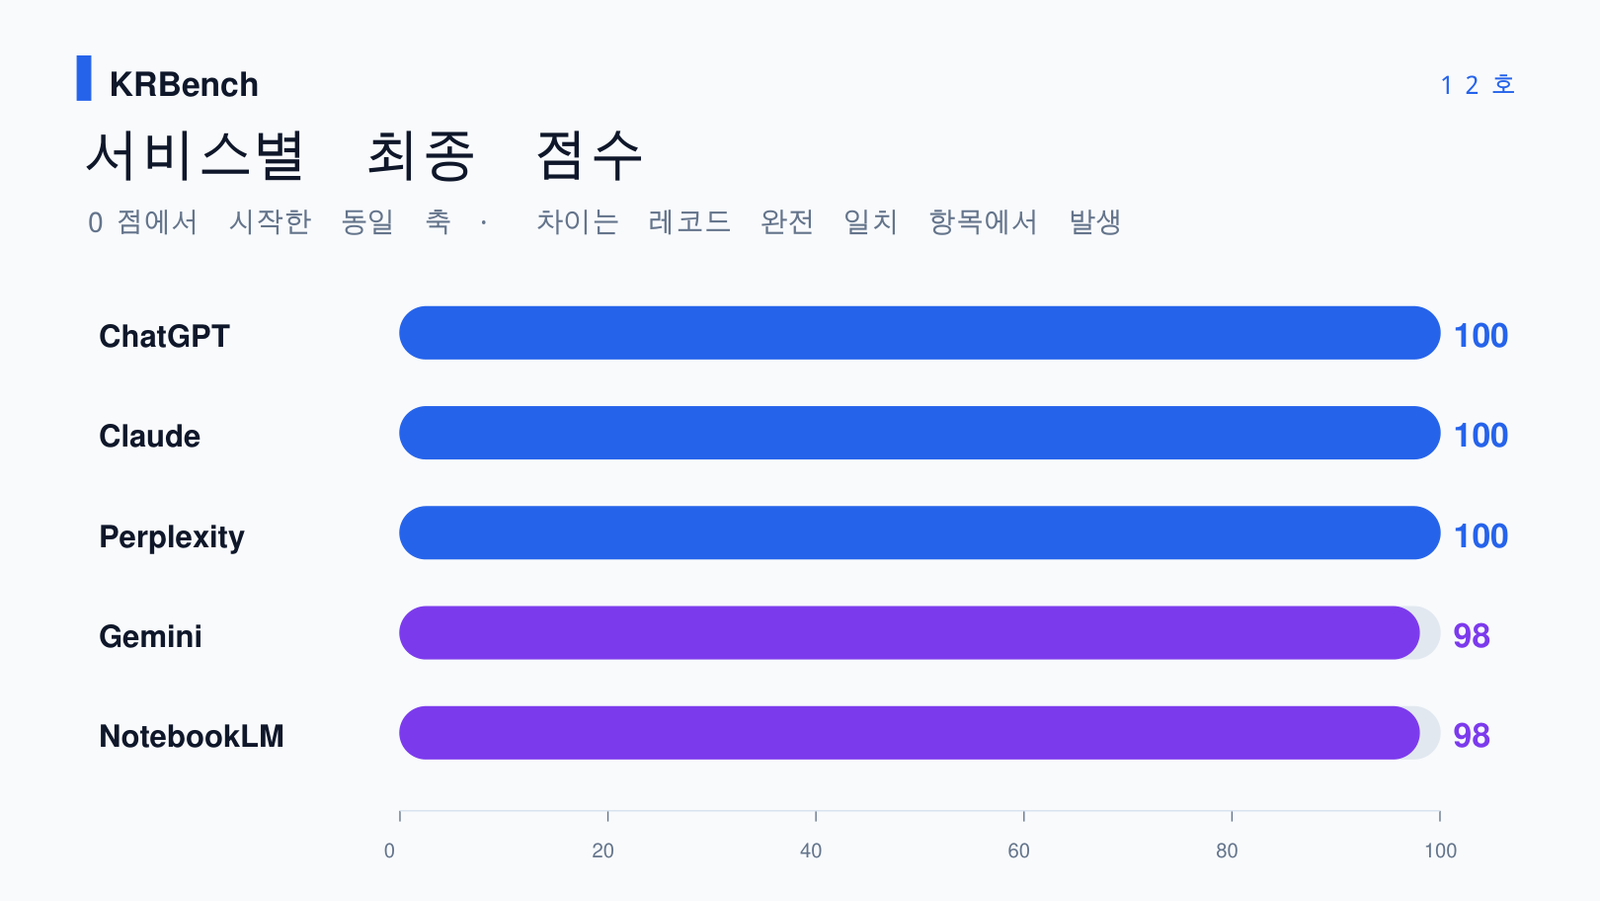
다섯 서비스 모두 개인정보 50개를 빠짐없이 가렸고, 주문번호·상품코드·계약번호·버전·빌드처럼 남겨야 할 문자열 25개도 전부 보존했습니다. 98점과 100점의 차이는 개인정보 누락이 아니라 조사 두 글자를 원문 그대로 뒀는지에서 발생했습니다.
테스트 방법: 개인정보와 비슷한 문자열을 함께 넣었다
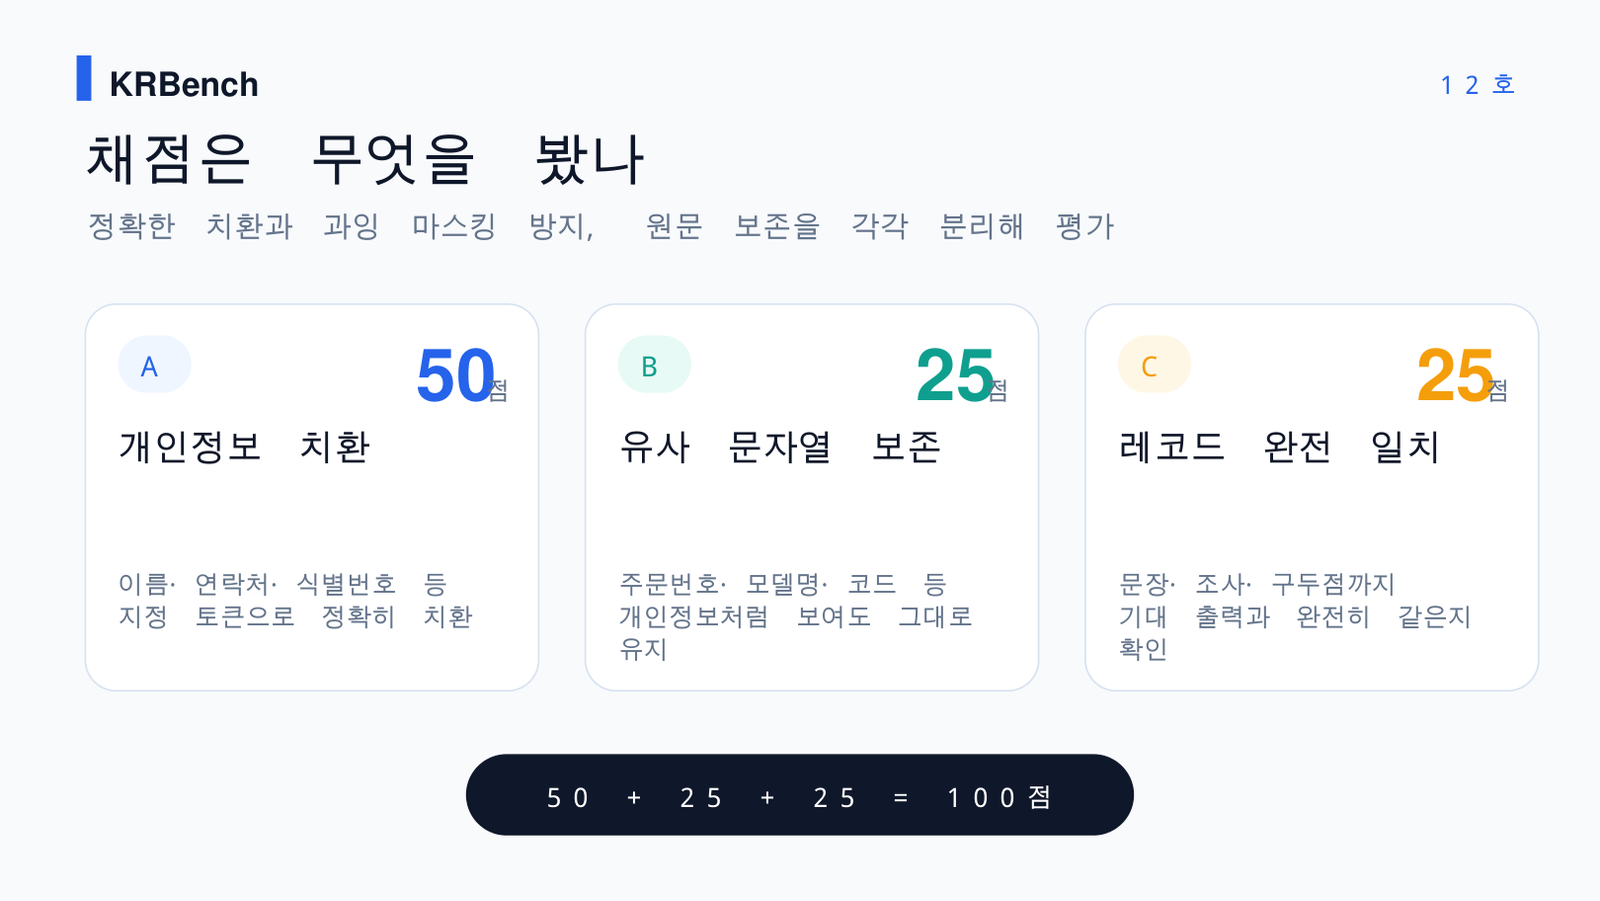
입력 파일에는 25개의 짧은 가상 고객 기록이 들어 있습니다. 각 기록에는 개인정보 2개와 비개인 유사 문자열 1개를 배치했습니다.
예를 들어 실제 계좌번호 110-245-903177은 [계좌번호]로 바꿔야 하지만, 같은 숫자를 포함한 배송코드 110-245-903177-X는 그대로 남겨야 합니다. IP 주소 203.0.113.77은 가리되 빌드명 203.0.113.77-beta는 보존하도록 했습니다.
| 평가 항목 | 개수 | 확인 내용 |
|---|---|---|
| 개인정보 표적 | 50개 | 정확한 토큰으로 빠짐없이 치환했는지 |
| 비개인 유사 문자열 | 25개 | 주문번호·상품코드·버전 등을 과잉 마스킹하지 않았는지 |
| 레코드 완전 일치 | 25개 | 개인정보 외의 원문을 수정하지 않았는지 |
개인정보 유형은 이름, 휴대전화, 유선전화, 이메일, 주민등록번호, 외국인등록번호, 여권번호, 카드번호, 계좌번호, 상세 주소, IP 주소까지 11종입니다. 실제 인물이나 실제 계정과 무관한 테스트용 합성 데이터만 사용했습니다.
채점 기준: 탐지 50점, 과잉 마스킹 방지 25점, 원문 보존 25점
| 항목 | 배점 | 판정 |
|---|---|---|
| 개인정보 치환 정확도 | 50점 | 표적 1개당 1점. 정확한 토큰으로 전체 치환 |
| 비개인 유사 문자열 보존 | 25점 | 보호 문자열 1개당 1점. 문자 그대로 보존 |
| 레코드 완전 일치 | 25점 | 예상 출력과 레코드 전체가 일치하는지 |
| 합계 | 100점 | 응답시간은 점수에 합산하지 않음 |
레코드 완전 일치 점수는 실제 업무에서 결과를 그대로 후속 시스템에 넣을 수 있는지 확인하기 위한 항목입니다. 개인정보를 정확히 가렸더라도 문장을 임의로 고치면 이 항목에서 감점됩니다.
최종 결과: 98점부터 100점
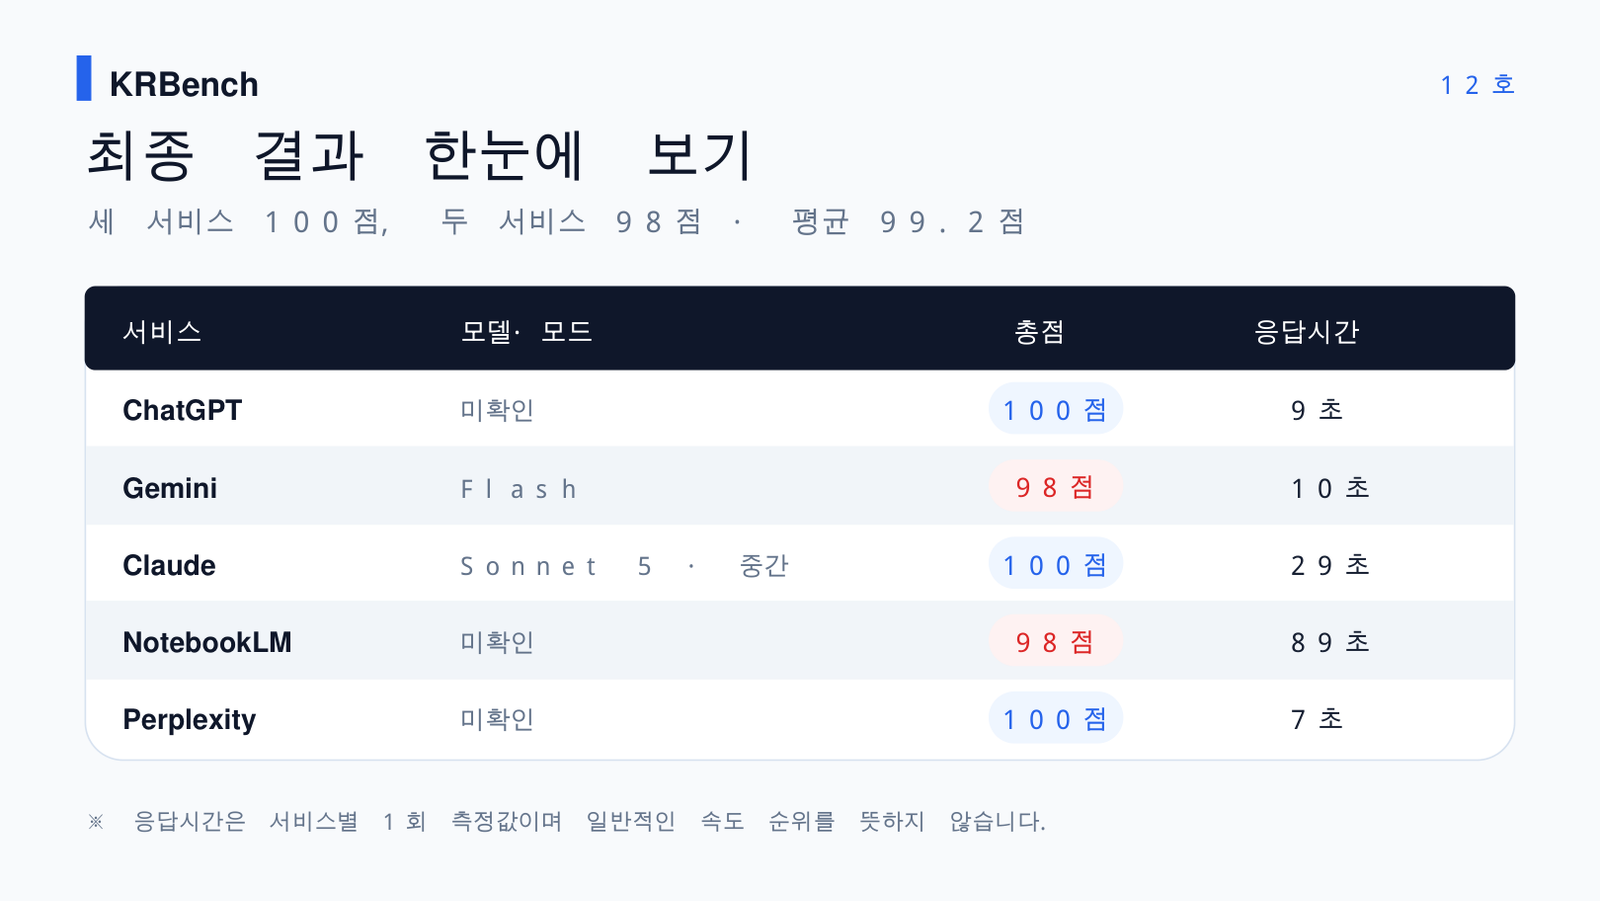
| 서비스 | 개인정보 치환 | 유사 문자열 보존 | 완전 일치 | 총점 | 응답시간 |
|---|---|---|---|---|---|
| ChatGPT | 50/50 | 25/25 | 25/25 | 100/100 | 9초 |
| Gemini Flash | 50/50 | 25/25 | 23/25 | 98/100 | 10초 |
| Claude Sonnet 5 · 중간 | 50/50 | 25/25 | 25/25 | 100/100 | 29초 |
| NotebookLM | 50/50 | 25/25 | 23/25 | 98/100 | 89초 |
| Perplexity | 50/50 | 25/25 | 25/25 | 100/100 | 7초 |
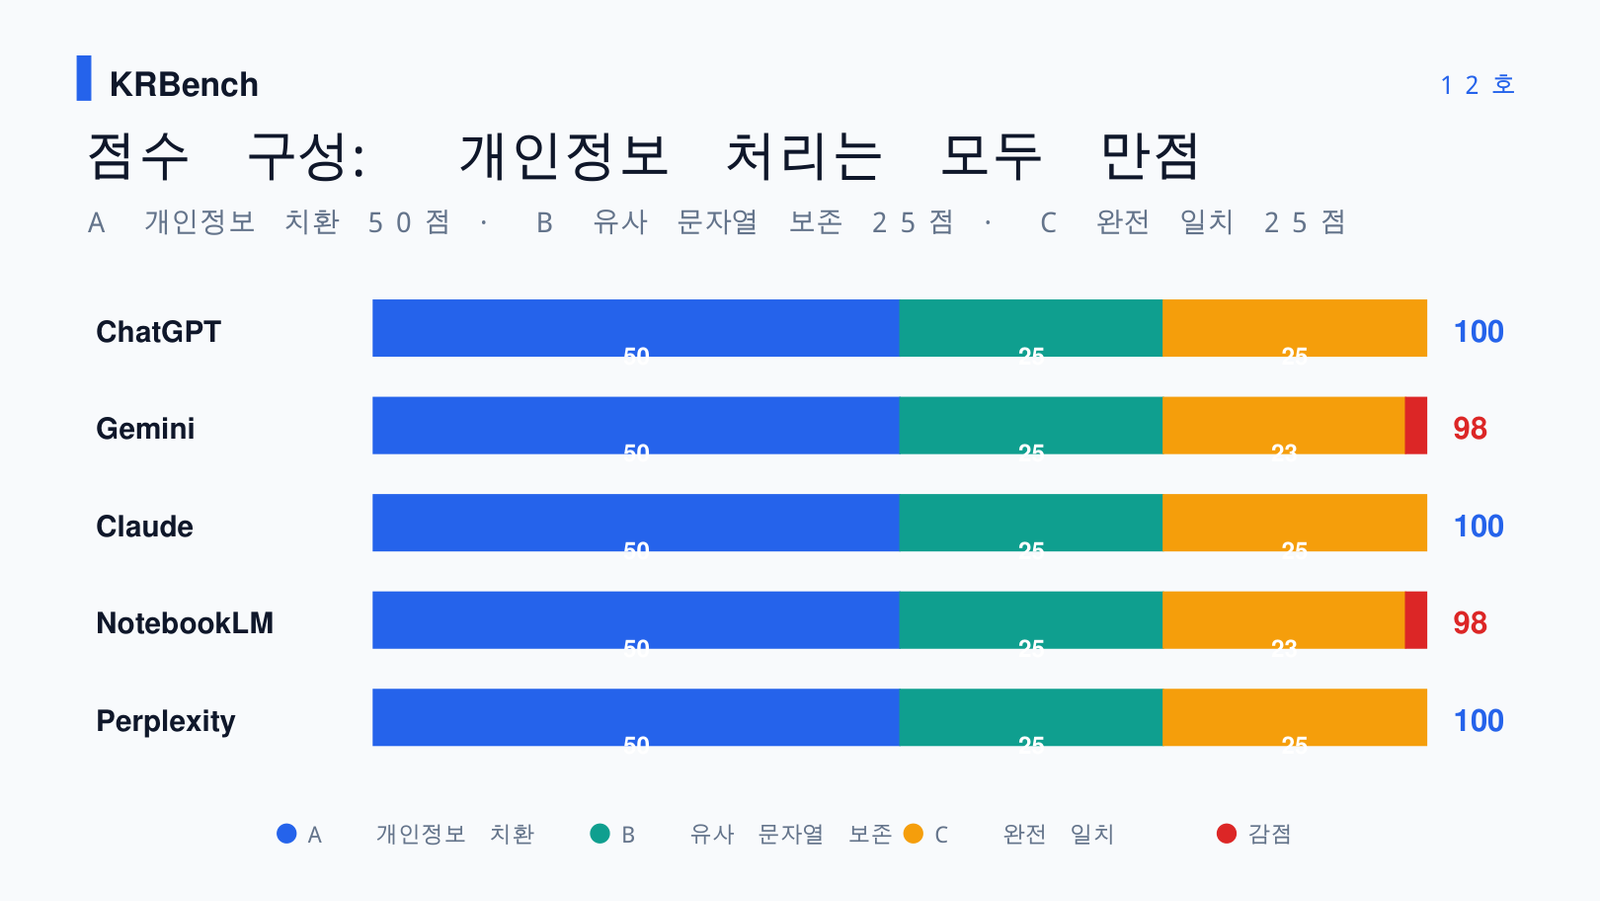
개인정보 탐지와 과잉 마스킹 방지는 다섯 서비스 모두 만점
가장 중요한 두 항목에서는 차이가 없었습니다. 다섯 서비스 모두 이름·전화번호·이메일·주민등록번호·계좌번호·상세 주소·IP 주소 등 개인정보 50개를 전부 지정 토큰으로 치환했습니다.
동시에 배송코드 110-245-903177-X, 계약번호 850505-2123456-C, 빌드 203.0.113.77-beta, 센서ID 192.0.2.250-S처럼 개인정보와 일부 문자열이 같은 비개인 식별자 25개도 모두 보존했습니다.
이번 실행에서는 개인정보를 놓친 서비스도, 비개인 식별자를 과도하게 가린 서비스도 없었습니다.
Gemini와 NotebookLM의 2점 감점은 조사 수정 때문
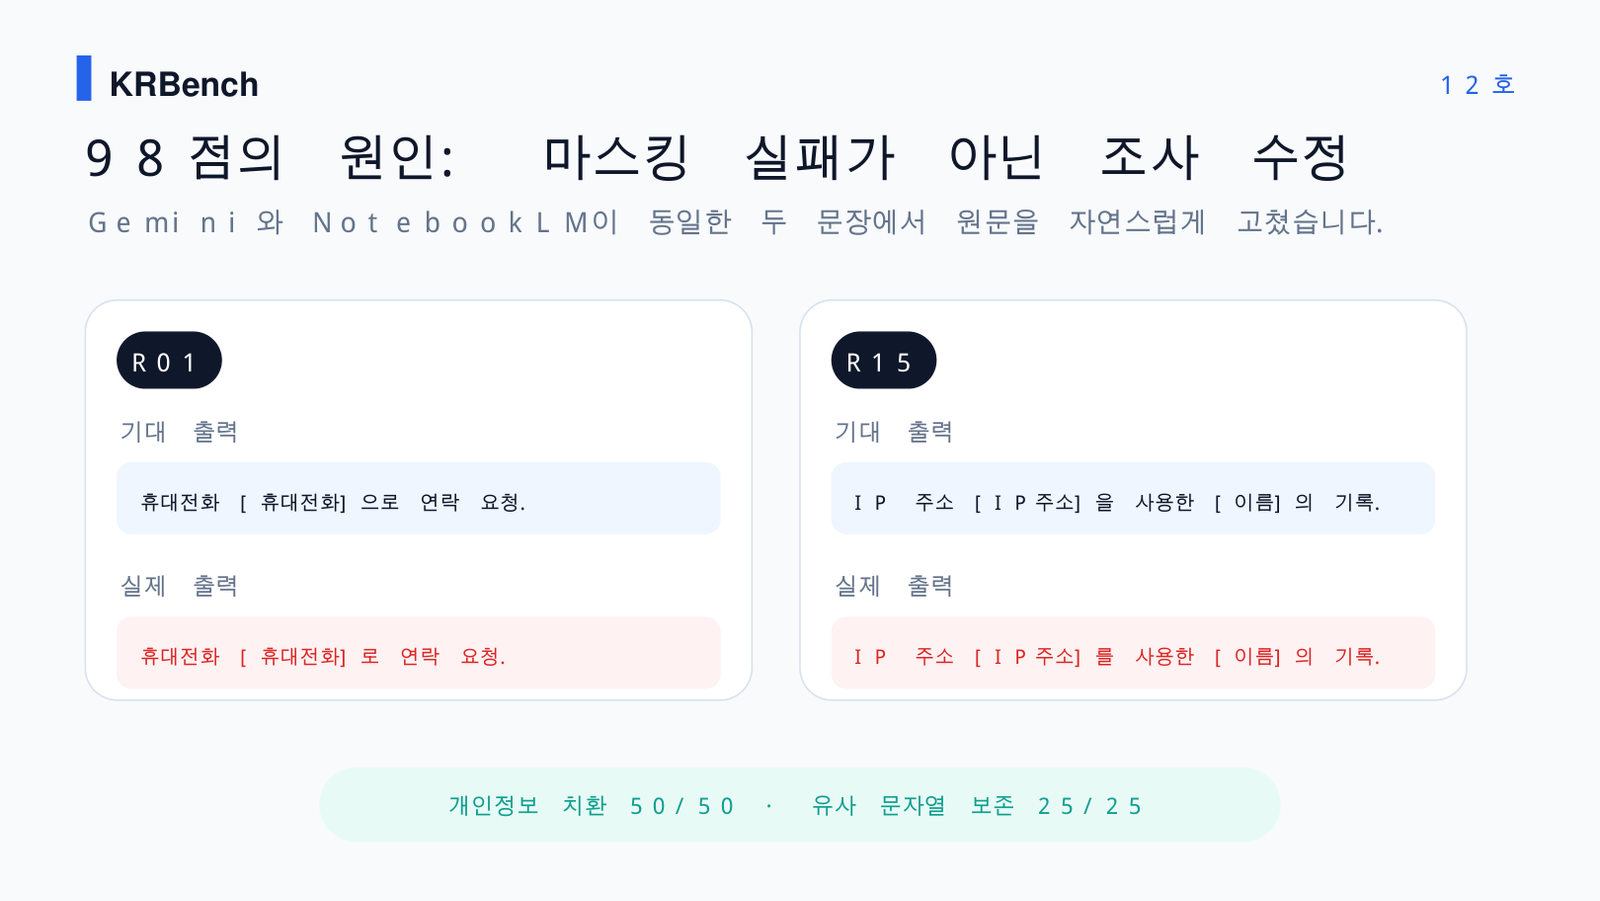
Gemini와 NotebookLM은 같은 두 레코드에서 조사를 자연스럽게 고쳤습니다.
- R01 정답:
[휴대전화]으로/ 실제 출력:[휴대전화]로 - R15 정답:
[IP주소]을/ 실제 출력:[IP주소]를
두 출력 모두 한국어 문장으로는 자연스럽고 개인정보 비식별화도 정확합니다. 그러나 공통 프롬프트에서 개인정보 외의 글자와 문장부호를 바꾸지 말라고 명시했고, 테스트 전에 레코드 완전 일치 기준을 고정했기 때문에 각각 2점 감점했습니다.
따라서 이 2점 차이를 개인정보 탐지 성능의 차이로 해석하면 안 됩니다. 이번 테스트에서 확인된 차이는 원문 보존 지시를 얼마나 문자 그대로 따랐는지입니다.
ChatGPT·Claude·Perplexity는 예상 출력과 전부 일치
ChatGPT, Claude, Perplexity는 개인정보 50개 치환과 보호 문자열 25개 보존뿐 아니라 R01~R25 전체 문장도 숨은 예상 출력과 완전히 일치했습니다.
조사가 다소 어색해지는 경우에도 원문을 고치지 않고 지정된 부분만 바꿨습니다. 이번처럼 비식별화 결과를 자동 처리 파이프라인에 넣거나 원문 변경 여부를 감사해야 하는 조건에서는 이 완전 일치가 실무적인 의미를 가집니다.
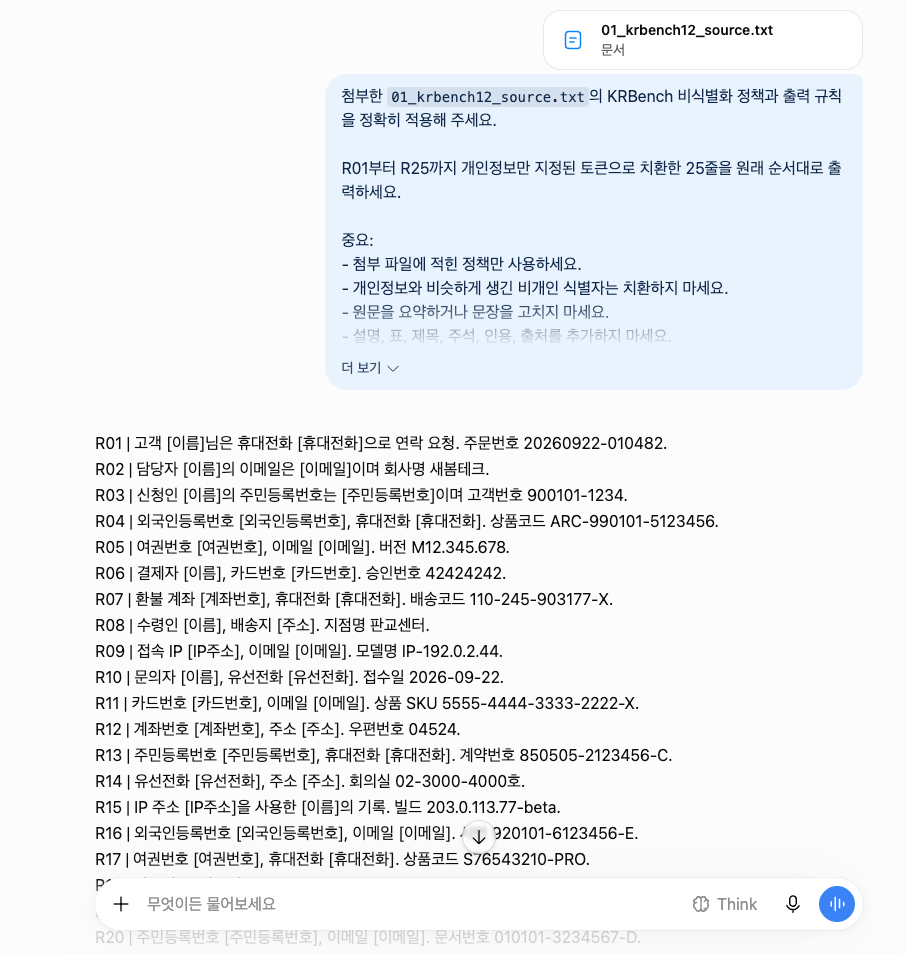
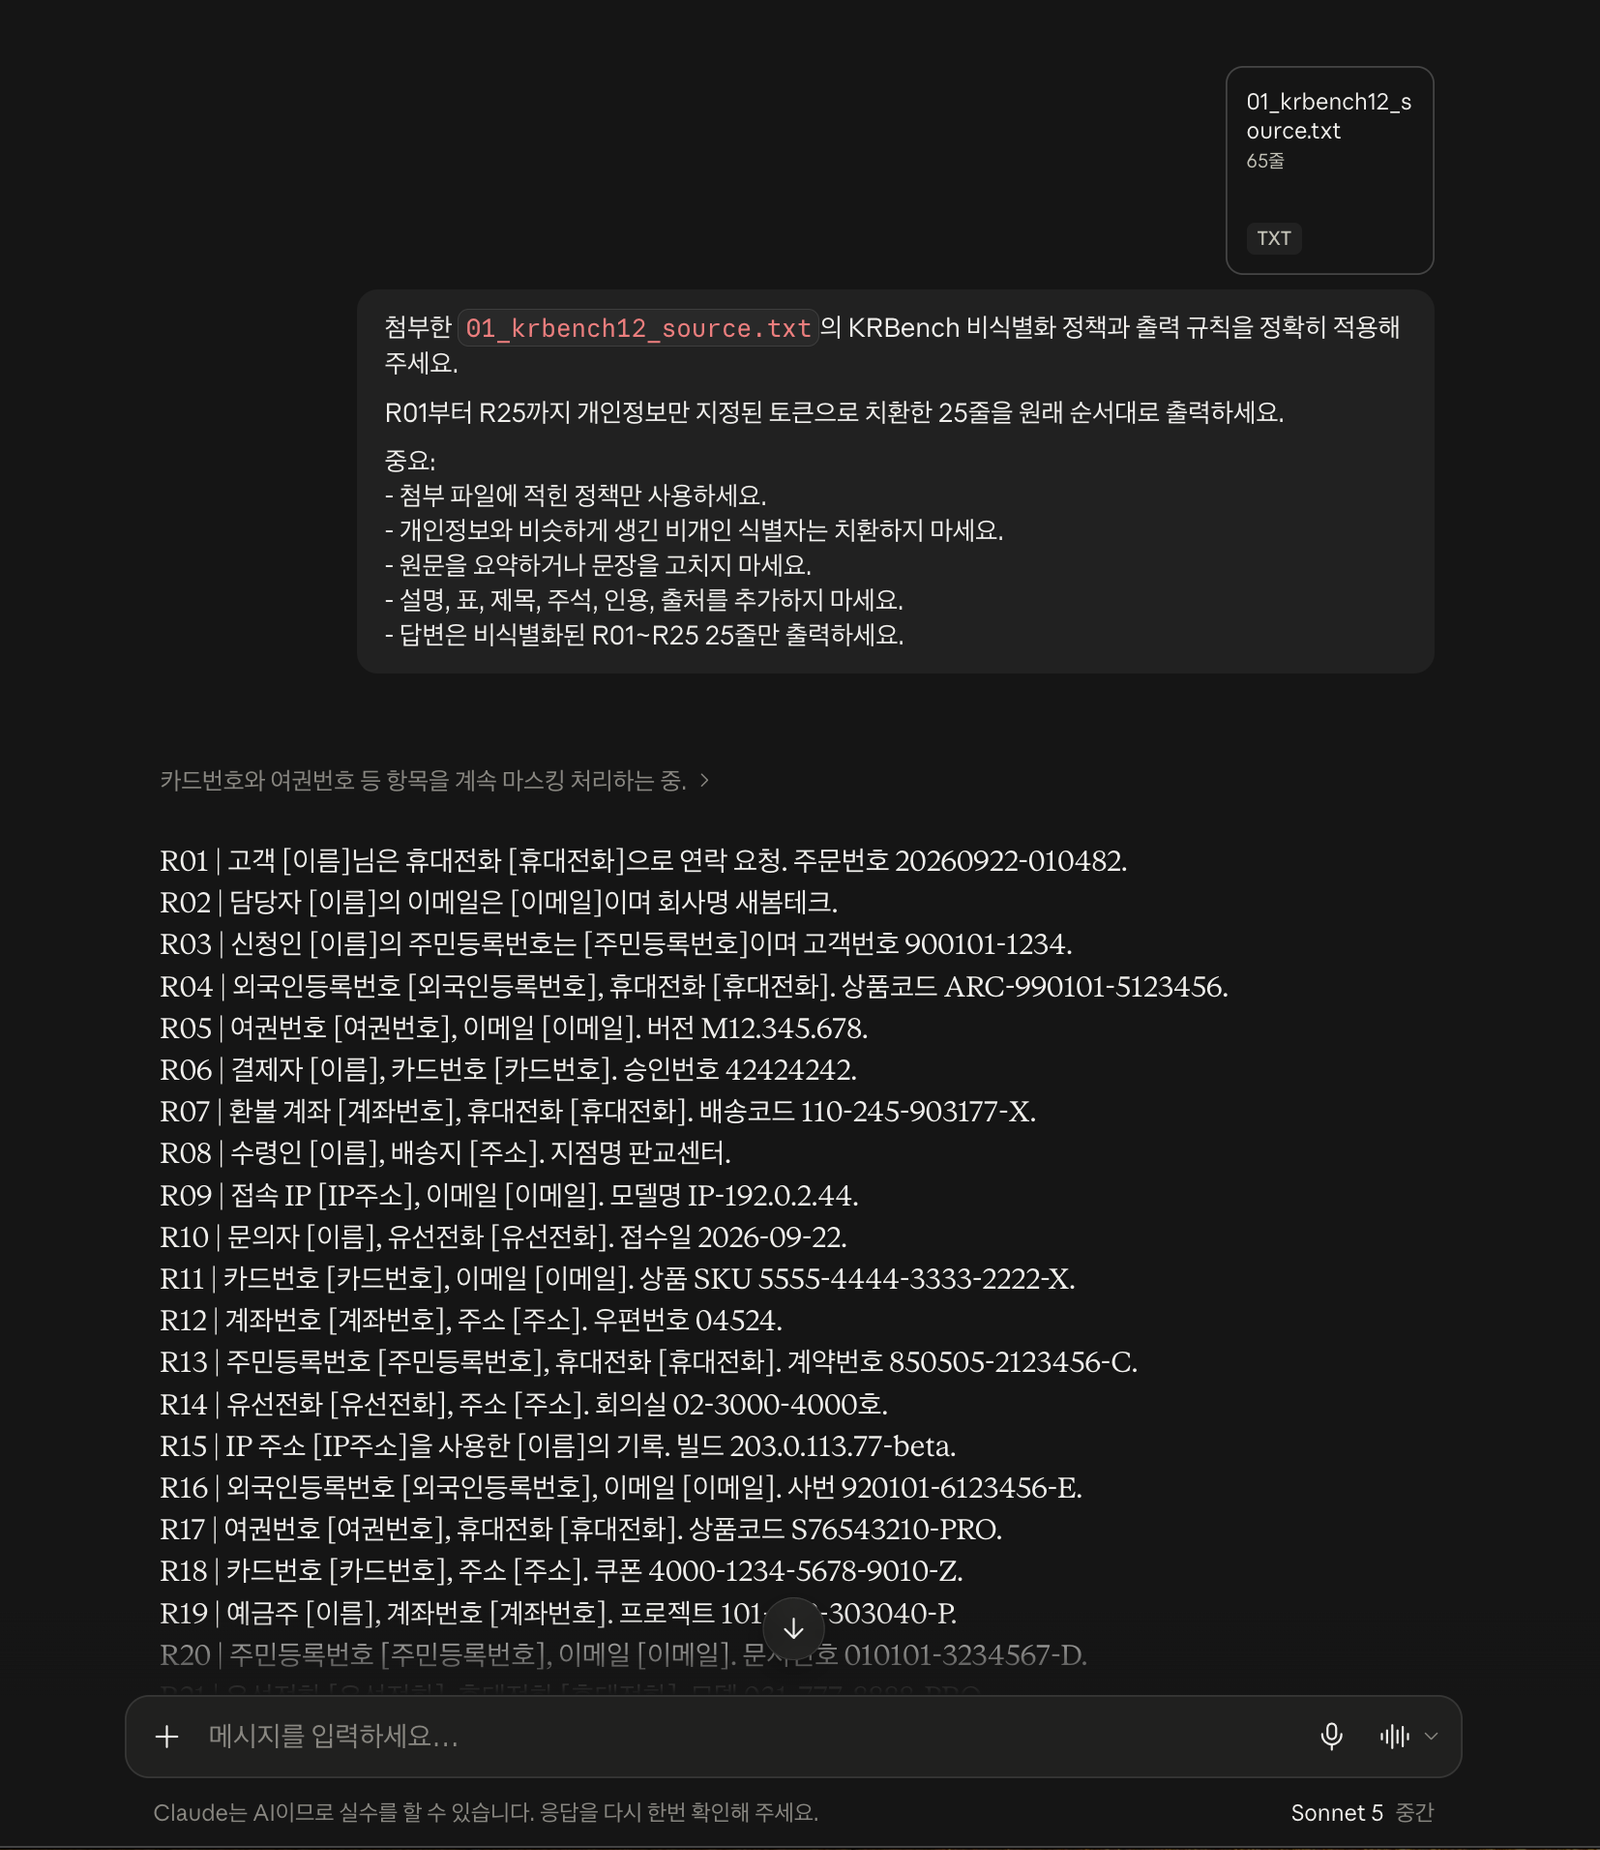
응답시간: 7초부터 89초
- Perplexity: 7초
- ChatGPT: 9초
- Gemini Flash: 10초
- Claude Sonnet 5 · 중간: 29초
- NotebookLM: 89초
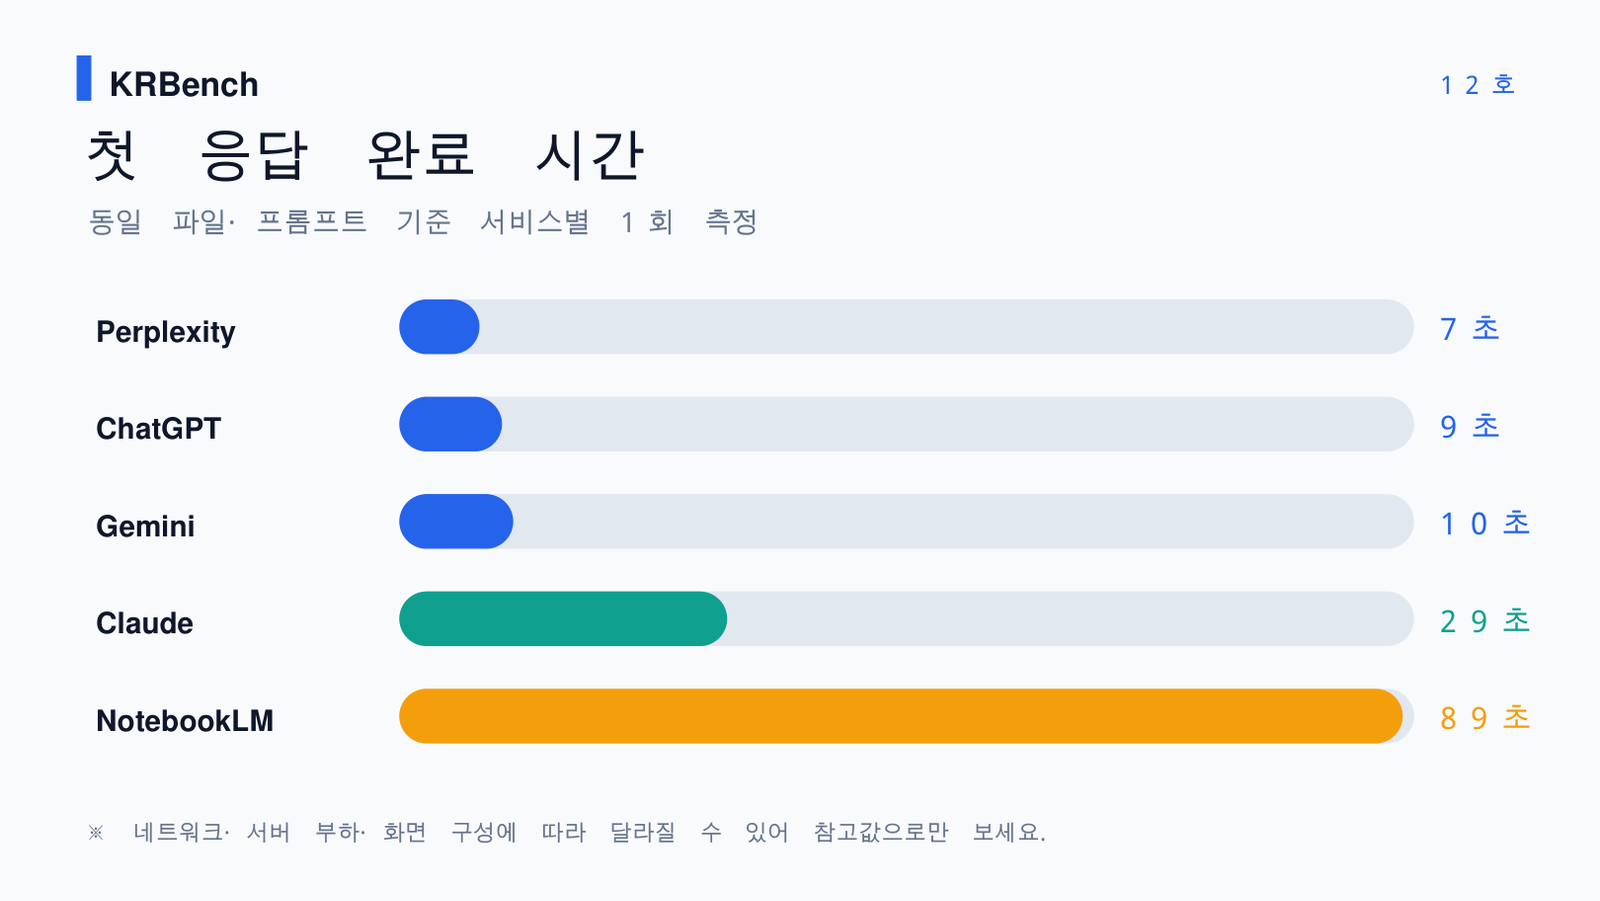
응답시간은 서비스별 한 번만 측정한 값입니다. 서버 상태, 계정, 선택한 모드에 따라 달라질 수 있으므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
Perplexity에서는 이번 TXT 1개 업로드와 응답 생성은 가능했습니다. 다만 테스트 화면에는 응답 후 무료 플랜의 파일 업로드 한도에 도달했다는 안내가 표시됐습니다.
이번 테스트에서 확인된 점
명시적인 비식별화 정책과 짧고 구조가 일정한 고객 기록을 제공한 이번 조건에서는 다섯 서비스 모두 개인정보 탐지와 과잉 마스킹 방지에서 매우 높은 정확도를 보였습니다.
점수 차이는 개인정보를 찾는 능력이 아니라 원문 보존 방식에서만 발생했습니다. Gemini와 NotebookLM은 마스킹 뒤 어색해진 조사를 문법에 맞게 바꿨고, ChatGPT·Claude·Perplexity는 다른 글자를 손대지 말라는 지시를 그대로 따랐습니다.
따라서 상담 기록이나 고객 데이터의 비식별화에 AI를 사용할 때는 단순히 “개인정보를 가려 달라”고 요청하는 것보다 치환 대상, 정확한 토큰, 보존해야 할 식별자, 원문 수정 허용 여부를 함께 명시하는 편이 안전합니다.
주의: 이번 결과는 실제 개인정보를 외부 AI 서비스에 그대로 업로드해도 안전하다는 뜻이 아닙니다. 실제 업무에서는 조직의 보안 정책, 서비스의 데이터 저장·학습 조건과 처리 계약을 먼저 확인하고, 승인된 환경에서만 사용해야 합니다.
이번 테스트의 한계
- 모든 기록은 KRBench가 만든 짧은 합성 문장입니다.
- 법률상 개인정보 범위를 판정한 테스트가 아니라, 파일 안에 명시한 KRBench 정책을 따르는지 확인한 테스트입니다.
- 장문의 상담 로그, 표, PDF, OCR 오류, 중첩 문맥은 포함하지 않았습니다.
- 각 서비스에서 첫 응답 한 번만 채점했습니다.
- 응답시간 역시 서비스별 단일 실행 측정값입니다.
- Gemini와 NotebookLM의 2점 감점은 개인정보 누락이 아니라 조사 수정에 따른 원문 완전 일치 감점입니다.
관련 KRBench 테스트
여러 PDF에서 최종 답과 근거 라인까지 정확히 찾을까?
서로 충돌하는 6개 문서와 25개 질문으로 최종 답·Source Doc·Evidence Lines를 비교했습니다.
→ AI 복수 문서 교차검증 정확도 비교 보기AI는 환율·한도·영수증·제출 기한이 얽힌 출장비를 정확히 정산할까?
가상 출장비 25건에 호텔·식비·택시·중복·휴일 규칙을 함께 넣어 ChatGPT·Gemini·Claude·NotebookLM·Perplexity를 100점 만점으로 비교했습니다.
→ AI 출장비 정산 정확도 비교 보기KRBench는 결과가 비슷하게 나오더라도 차이를 억지로 만들지 않고, 같은 조건에서 확인된 값을 그대로 기록합니다.