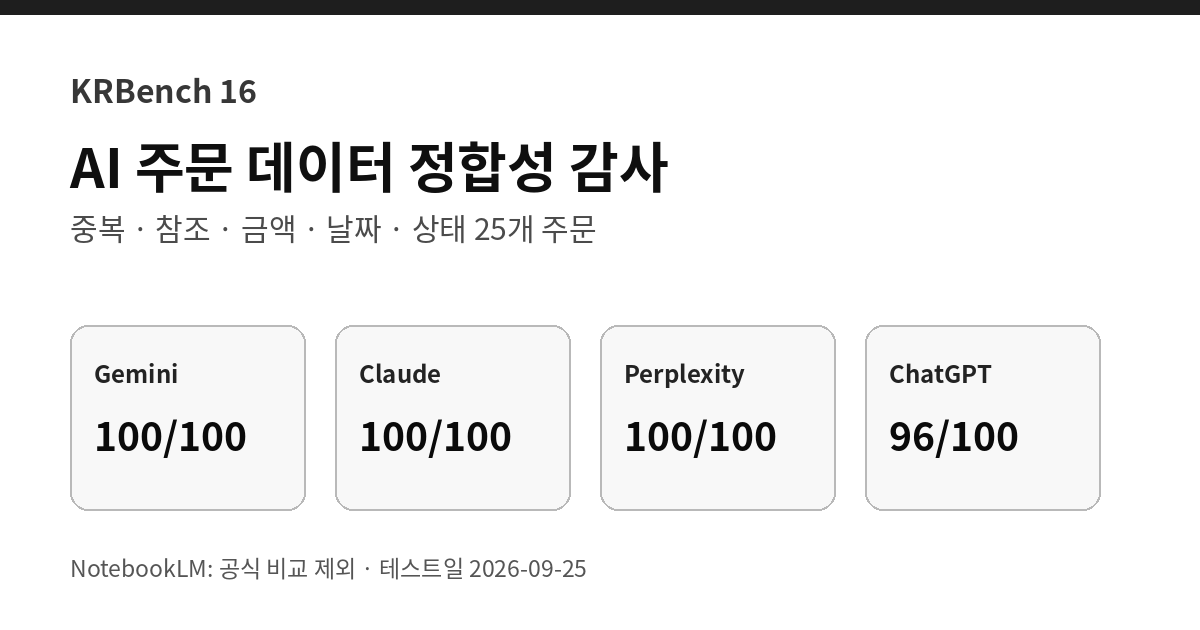
주문 데이터 한 행의 오류를 찾는 것보다 어려운 일은 여러 행을 서로 대조하고, 고객·상품 기준표를 참조하고, 금액을 다시 계산한 뒤 한 행에 오류가 여러 개 있을 때 우선순위까지 정확히 적용하는 것입니다.
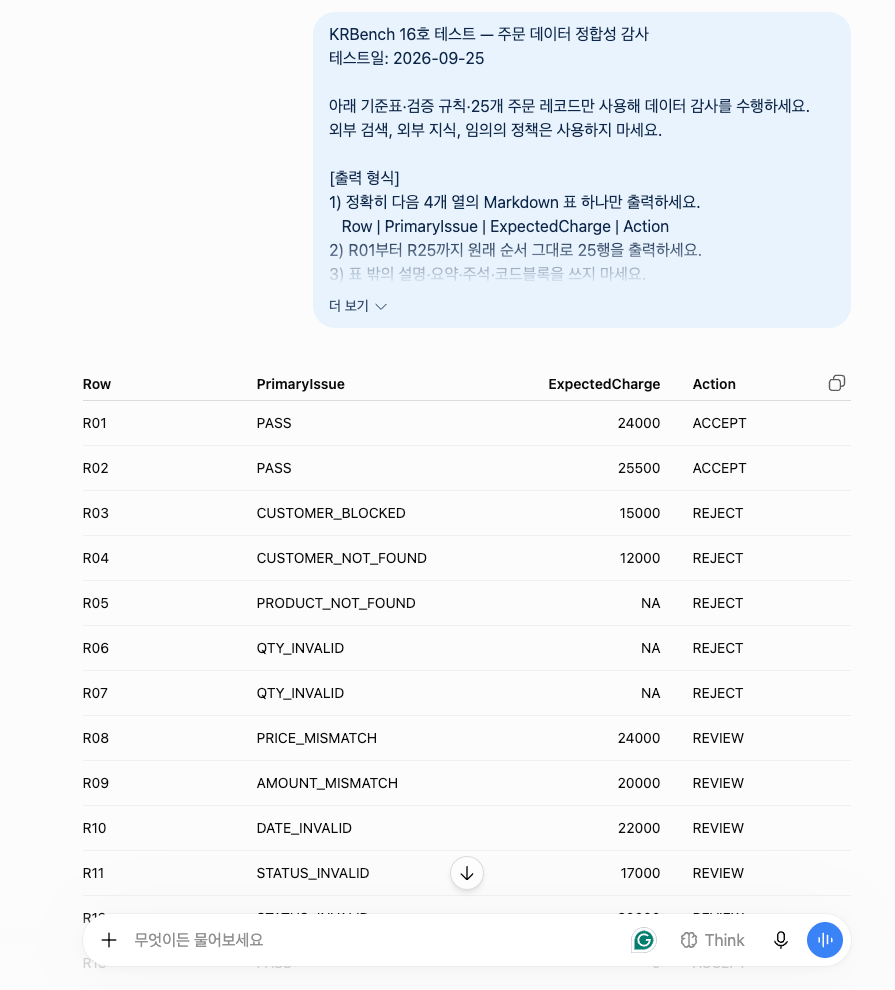
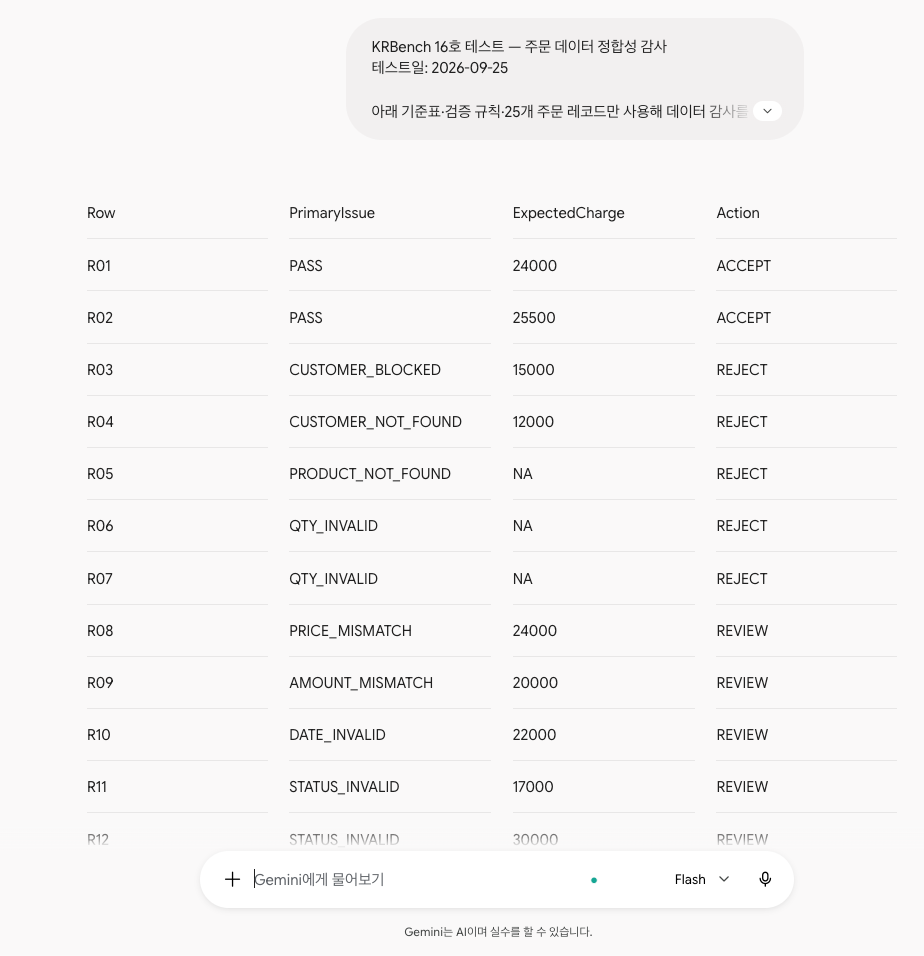
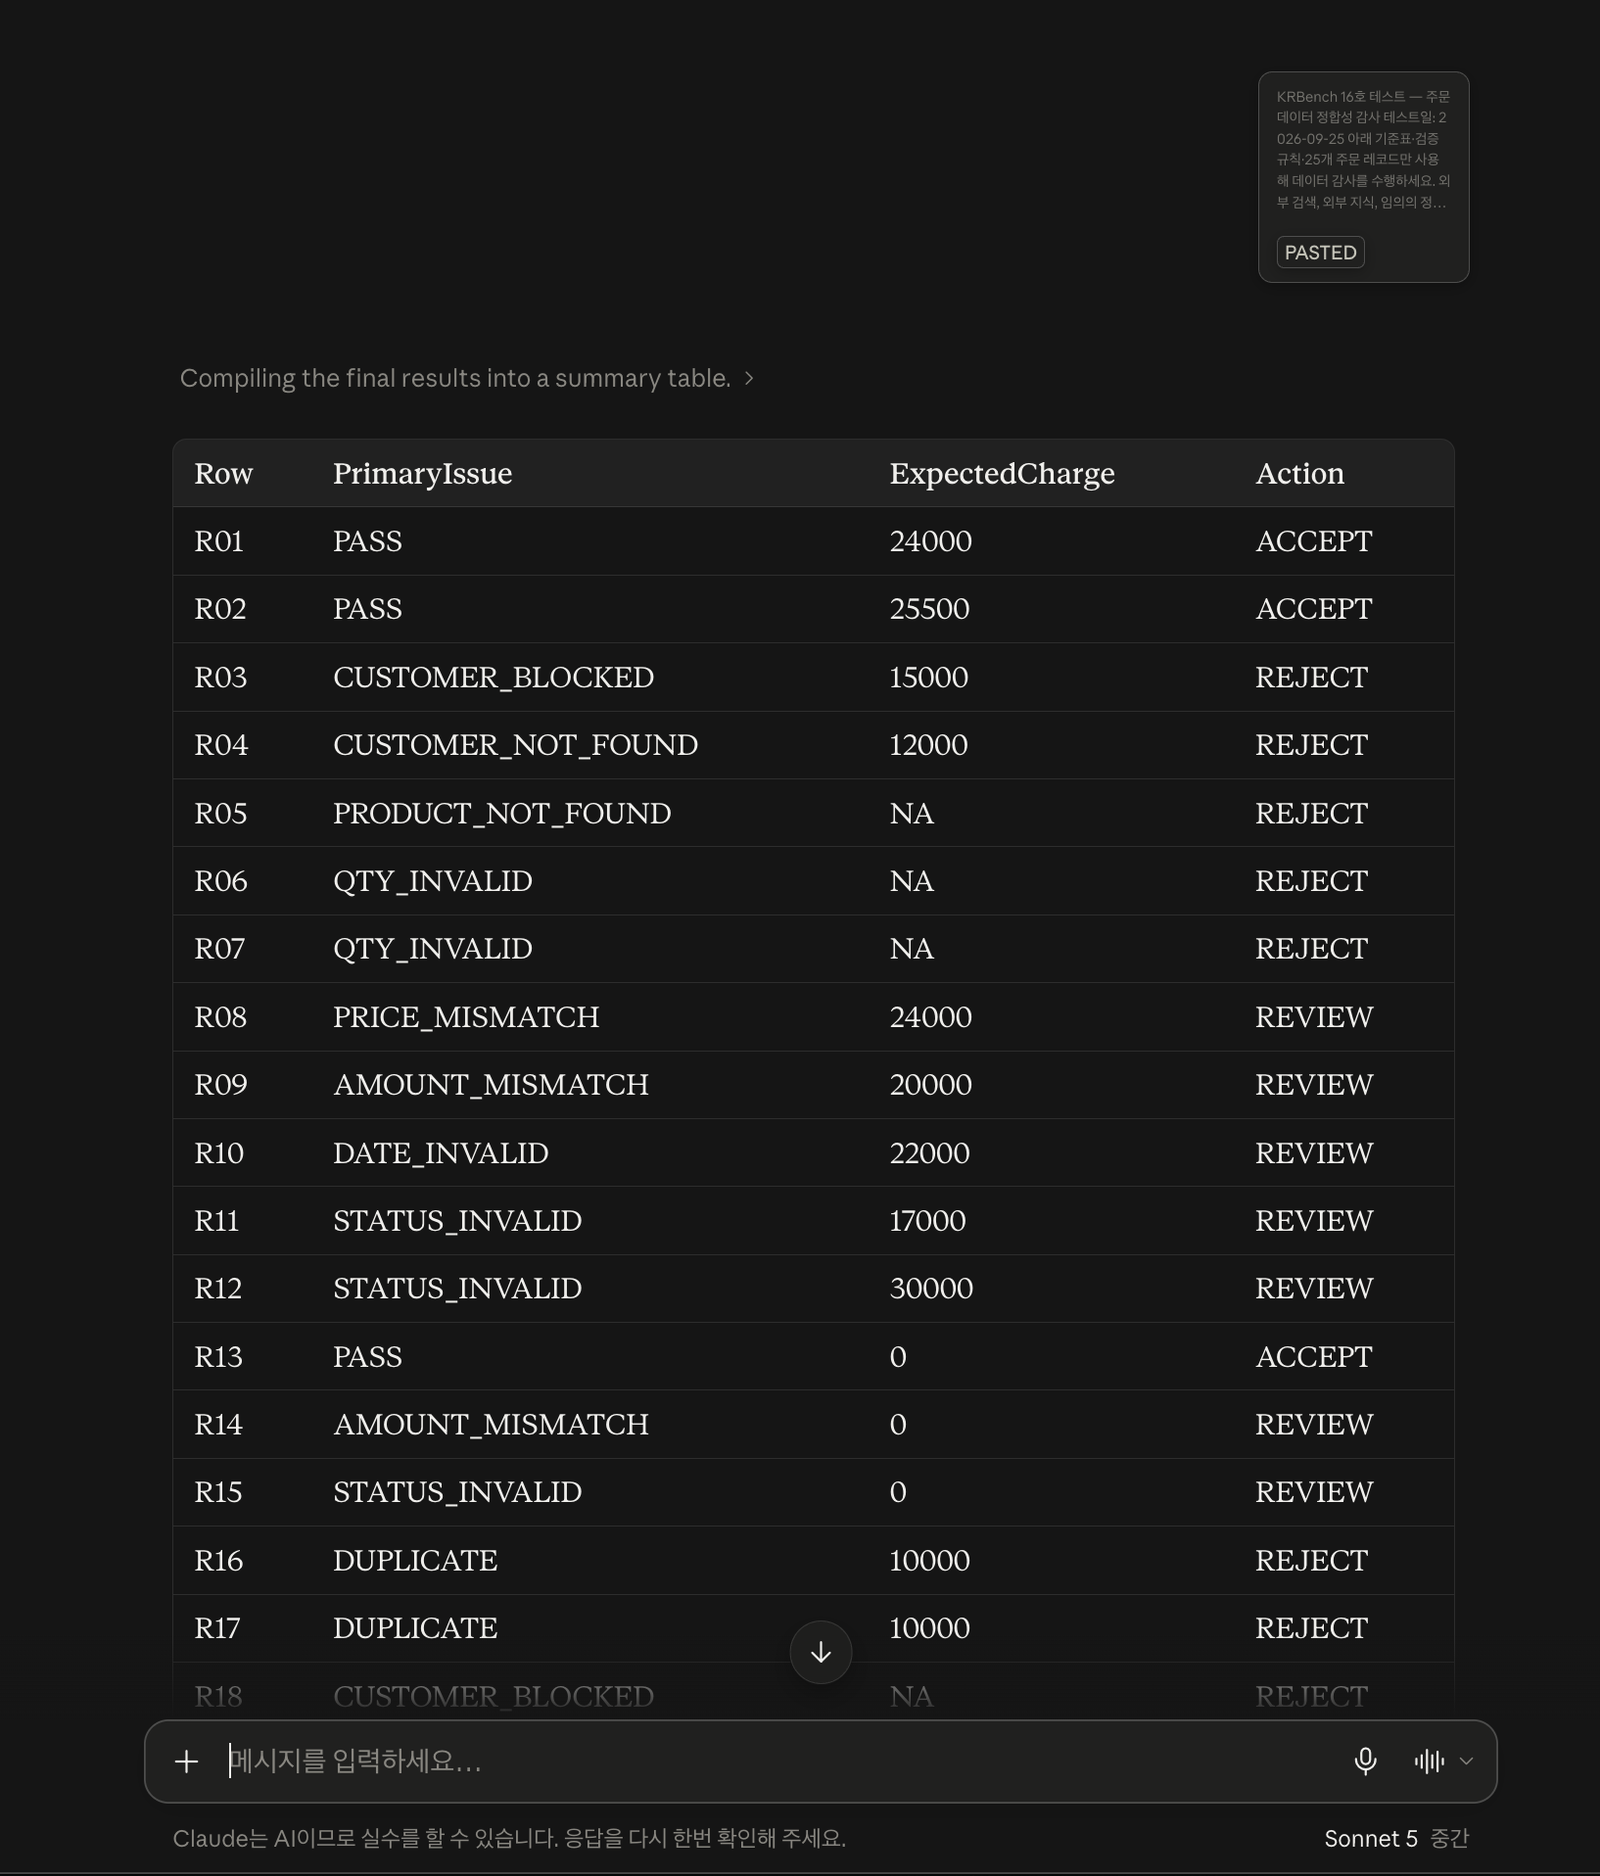
KRBench 16호에서는 첨부파일 없이 하나의 프롬프트 안에 고객 기준표, 상품 기준표, 검증 규칙, 25개 주문 레코드를 넣었습니다. ChatGPT, Gemini, Claude, Perplexity에 같은 텍스트를 새 대화에서 입력하고 첫 응답만 채점했습니다.
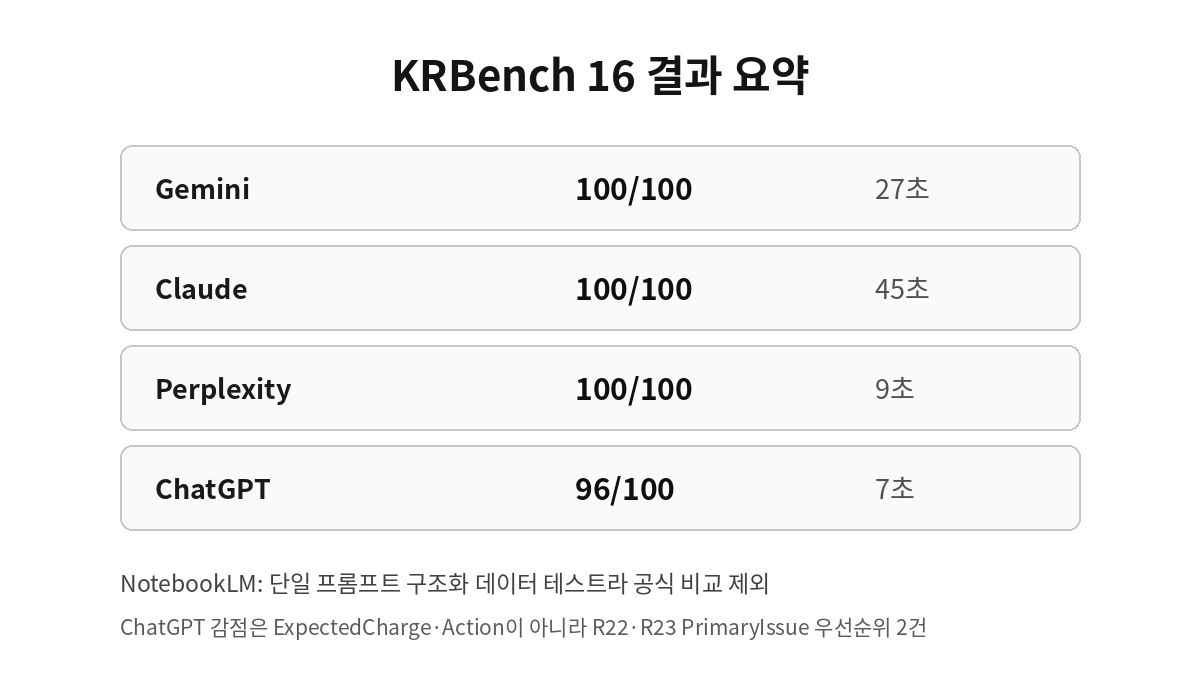
결과 요약
- Gemini Flash: 100/100 · 27초
- Claude Sonnet 5 · 중간: 100/100 · 45초
- Perplexity: 100/100 · 9초
- ChatGPT: 96/100 · 7초
- NotebookLM: 공식 비교 제외 — 단일 프롬프트 구조화 데이터 테스트
테스트 방법: 한 주문만 보는 것이 아니라 행과 기준표를 함께 대조
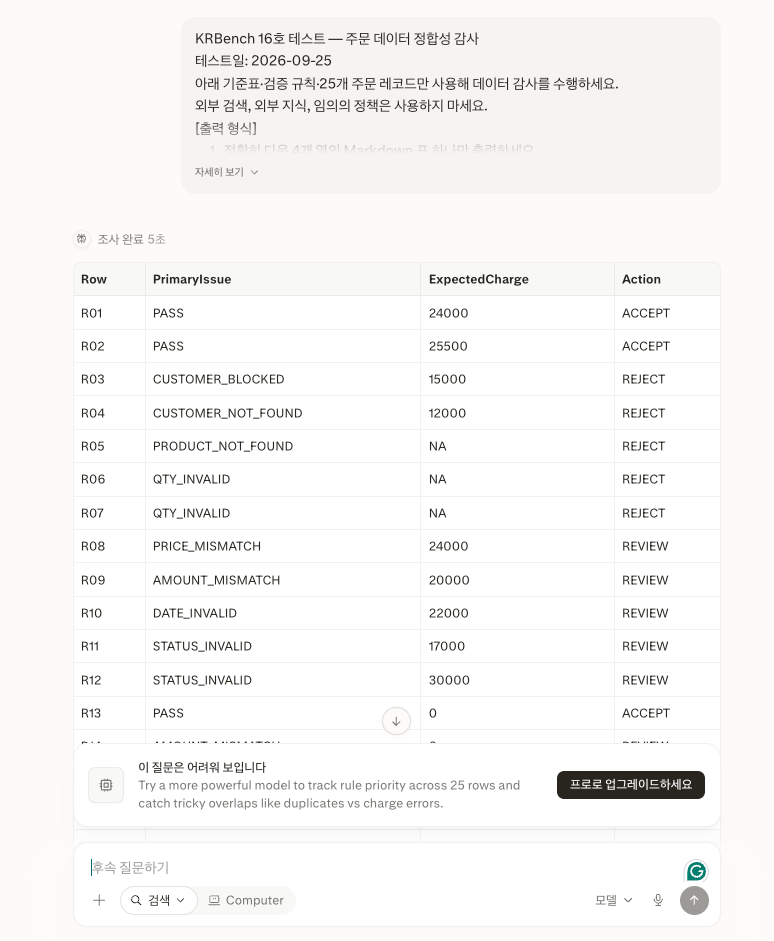
이번 테스트는 단순 분류가 아닙니다. 같은 OrderID가 여러 행에 있는지 전체 25개 행을 훑어야 하고, CustomerID와 ProductCode는 각각 별도의 기준표에서 존재 여부와 상태, 기준가격을 확인해야 합니다.
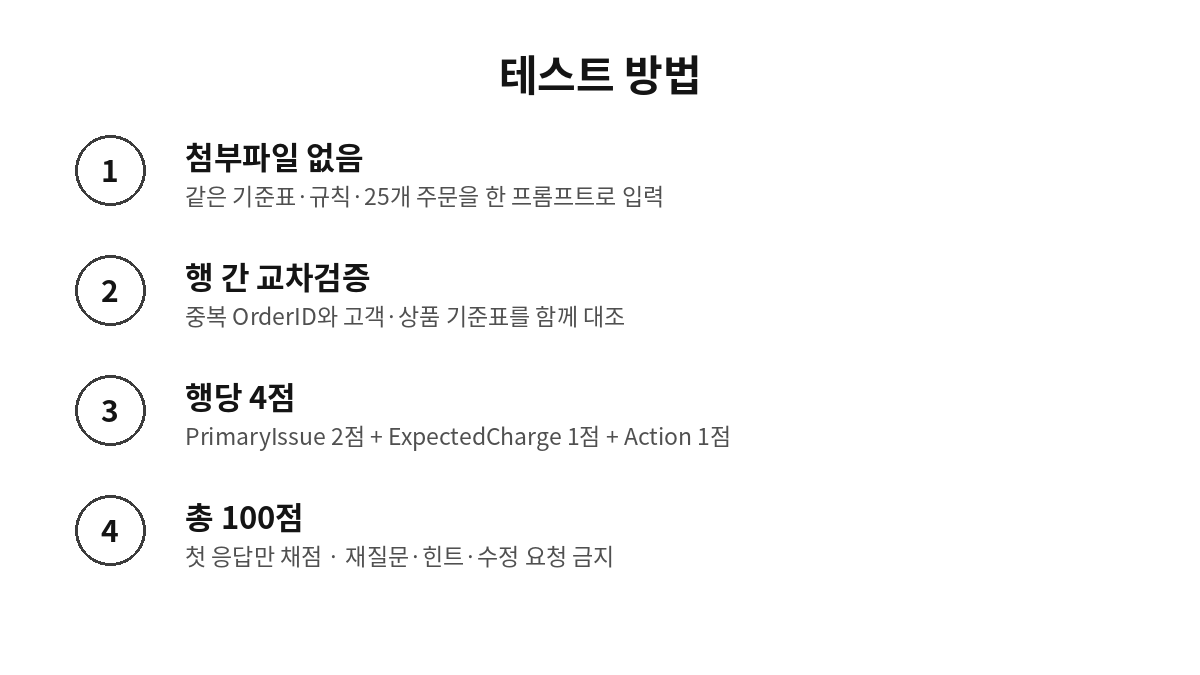
ExpectedCharge는 주문 행의 UnitPrice가 아니라 상품 기준표의 MasterPrice를 사용해 다시 계산했습니다. 취소 주문은 0원으로 계산하고, 상품이 없거나 수량이 유효하지 않으면 NA로 처리했습니다.
또 한 행에 오류가 여러 개 존재하도록 설계했습니다. 이 경우 모든 오류를 나열하는 것이 아니라 사전에 고정한 우선순위를 위에서부터 적용해 PrimaryIssue 하나만 출력하도록 했습니다.
채점 기준: PrimaryIssue 50점 + 금액 25점 + Action 25점
| 항목 | 행당 | 총 배점 |
|---|---|---|
| PrimaryIssue | 2점 | 50점 |
| ExpectedCharge | 1점 | 25점 |
| Action | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
정답과 오류 우선순위, 배점은 테스트 결과를 보기 전에 고정했습니다. 출력 행 순서가 달라도 Row가 명확하면 필드별 채점은 가능하도록 했지만, 누락된 행은 해당 행 전체를 0점 처리하도록 정했습니다.
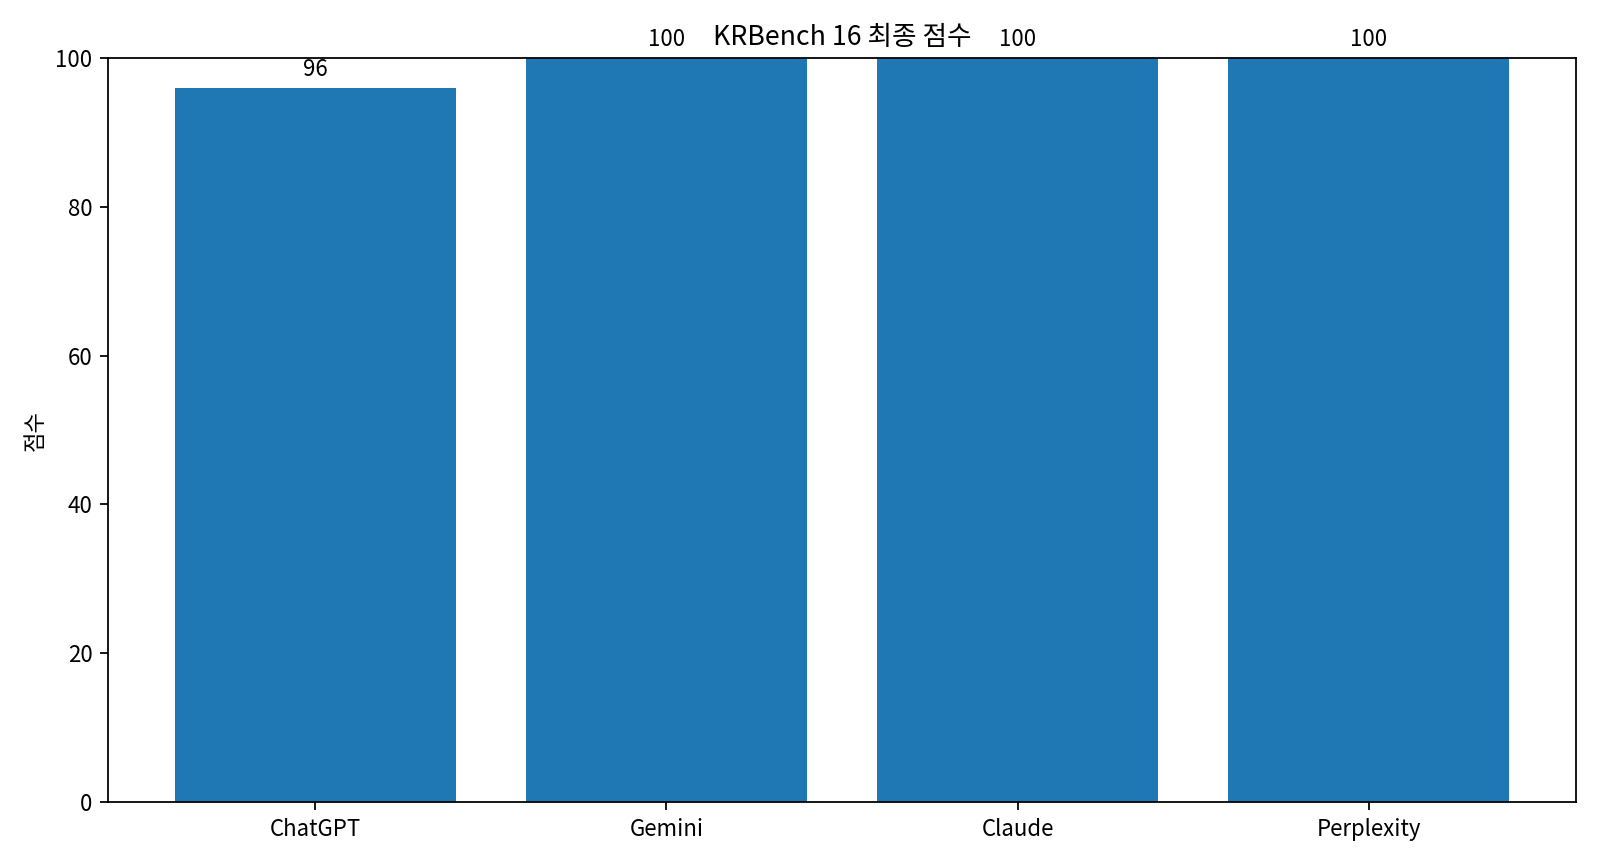
전체 결과: Gemini·Claude·Perplexity 100점, ChatGPT 96점
| 서비스 | PrimaryIssue | ExpectedCharge | Action | 총점 | 응답시간 |
|---|---|---|---|---|---|
| Gemini | 50/50 | 25/25 | 25/25 | 100/100 | 27초 |
| Claude | 50/50 | 25/25 | 25/25 | 100/100 | 45초 |
| Perplexity | 50/50 | 25/25 | 25/25 | 100/100 | 9초 |
| ChatGPT | 46/50 | 25/25 | 25/25 | 96/100 | 7초 |
ChatGPT의 감점은 계산이 아니라 오류 우선순위에서 발생
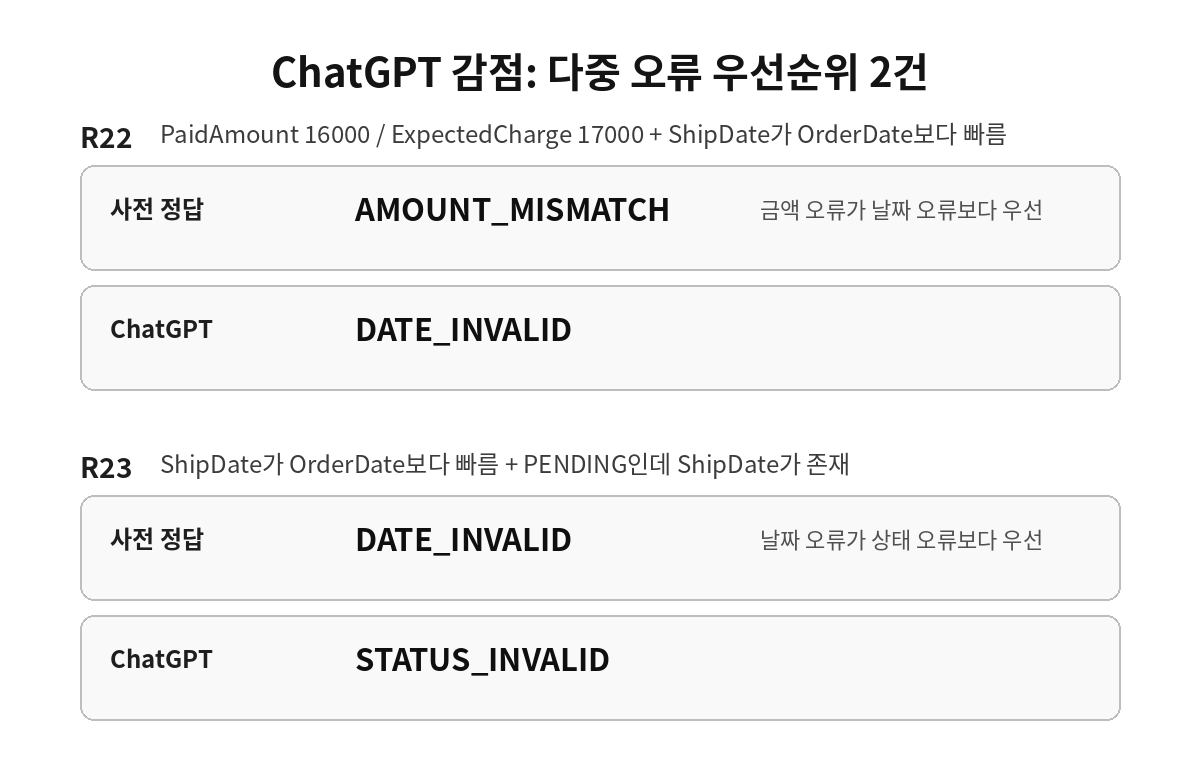
ChatGPT는 ExpectedCharge 25개와 Action 25개를 모두 맞혔습니다. 감점은 R22와 R23의 PrimaryIssue 두 곳이었습니다.
R22에는 두 오류가 동시에 있습니다. PaidAmount 16000원은 ExpectedCharge 17000원과 다르고, ShipDate도 OrderDate보다 하루 빠릅니다. 사전 우선순위에서는 AMOUNT_MISMATCH가 DATE_INVALID보다 먼저이므로 정답은 금액 오류입니다. ChatGPT는 뒤에 있는 DATE_INVALID를 선택했습니다.
R23 역시 ShipDate가 OrderDate보다 빠른 날짜 오류와, PENDING 상태인데 ShipDate가 존재하는 상태 오류가 동시에 있습니다. 이 경우 DATE_INVALID가 STATUS_INVALID보다 먼저지만 ChatGPT는 상태 오류를 선택했습니다.
Gemini·Claude·Perplexity는 다중 오류 우선순위까지 모두 일치
Gemini, Claude, Perplexity는 25개 주문의 PrimaryIssue, ExpectedCharge, Action을 모두 사전 정답과 일치시켰습니다. 특히 여러 오류가 동시에 있는 R18~R23에서 앞쪽 규칙을 정확히 적용했습니다.
- R18:
CUSTOMER_BLOCKED가PRODUCT_NOT_FOUND보다 우선 - R19:
CUSTOMER_NOT_FOUND가PRICE_MISMATCH보다 우선 - R20:
PRODUCT_NOT_FOUND가QTY_INVALID보다 우선 - R21:
PRICE_MISMATCH가AMOUNT_MISMATCH보다 우선 - R22:
AMOUNT_MISMATCH가DATE_INVALID보다 우선 - R23:
DATE_INVALID가STATUS_INVALID보다 우선
NotebookLM은 이번에도 공식 비교에서 제외
NotebookLM을 제외한 이유는 점수나 성능 제한 때문이 아닙니다. 이번 테스트는 별도의 소스 문서를 읽는 것이 아니라 하나의 프롬프트 안에 들어 있는 기준표와 구조화 데이터를 교차검증하는 방식입니다.
다른 네 서비스는 같은 텍스트를 채팅 입력창에 그대로 붙여넣을 수 있지만 NotebookLM은 별도 소스 입력 절차가 필요합니다. 동일 조건을 우선해 공식 비교에서는 제외했습니다.
응답시간: 7초부터 45초
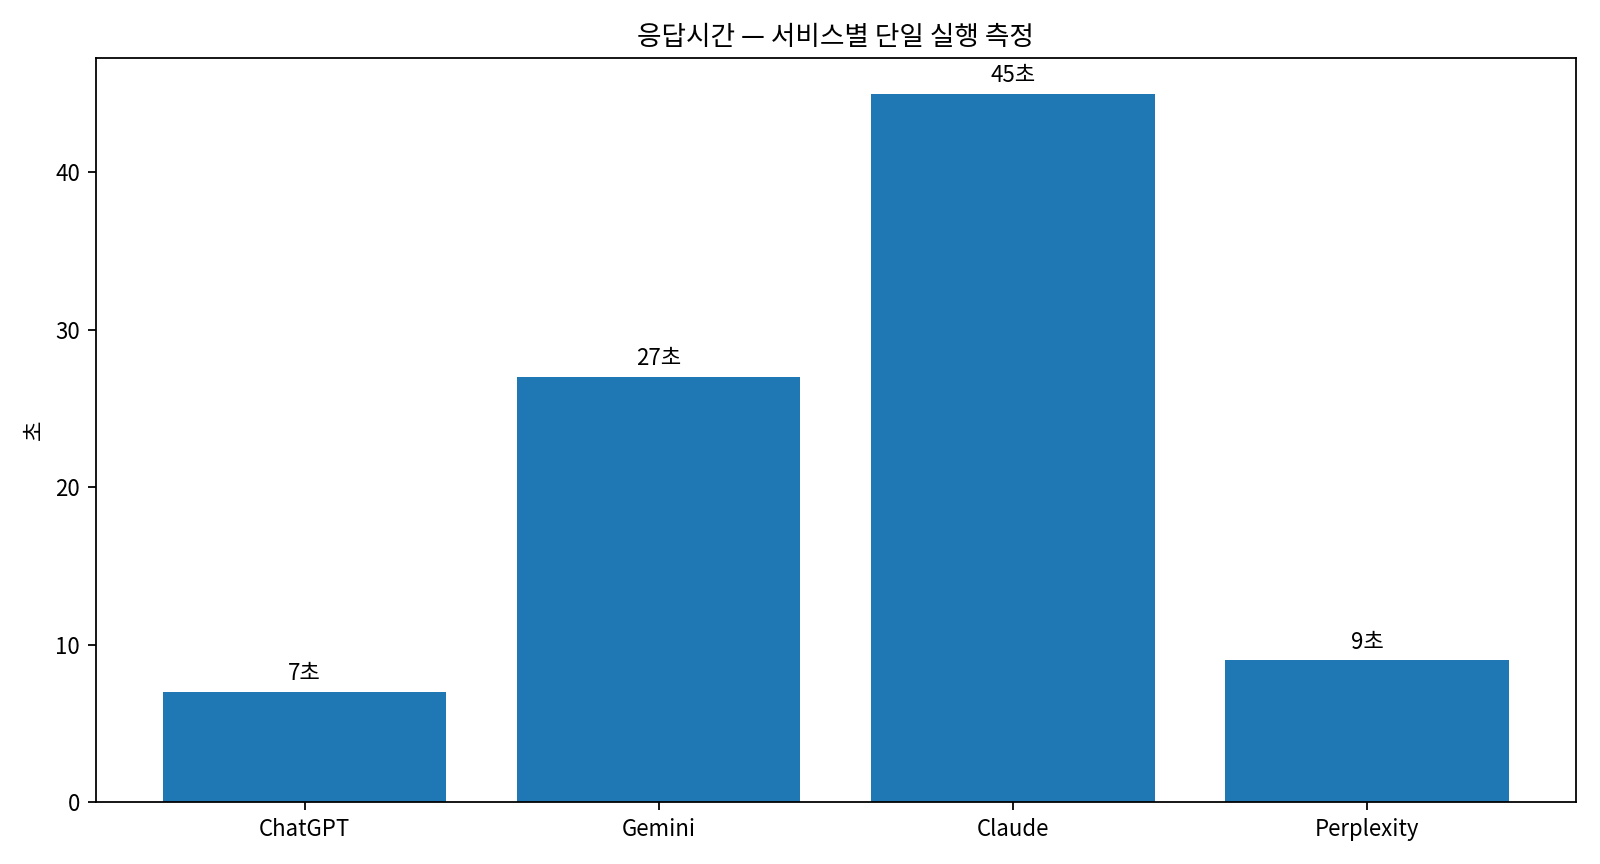
실측 응답시간은 ChatGPT 7초, Perplexity 9초, Gemini 27초, Claude 45초였습니다. 각 서비스에서 한 번만 측정한 값이므로 서버 상태와 계정 환경에 따라 달라질 수 있고, 일반적인 속도 순위로 확대해 해석하지 않았습니다.
이번 테스트에서 확인된 점
이번 조건에서는 금액 계산 자체보다 여러 오류가 동시에 존재할 때 어떤 오류를 대표 오류로 선택하느냐에서 차이가 발생했습니다. ChatGPT도 ExpectedCharge와 Action은 모두 맞혔기 때문에 단순 계산 실패라고 보기는 어렵습니다.
실제 데이터 감사에서도 한 레코드에 여러 문제가 겹칠 수 있습니다. 이때 후속 시스템이 하나의 대표 오류 코드만 받는다면 오류 탐지뿐 아니라 사전에 정의된 우선순위를 정확히 적용하는 것이 중요합니다.
이번 테스트의 한계
- 실제 주문 DB가 아니라 KRBench가 만든 합성 데이터입니다.
- 25개 주문과 두 개 기준표만 사용했습니다.
- 통화·세금·할인·부분 환불처럼 더 복잡한 금액 규칙은 포함하지 않았습니다.
- 정답이 기계적으로 하나로 결정되도록 설계해 현실 업무의 모호성은 포함하지 않았습니다.
- NotebookLM은 이번 테스트 목적과 입력 경로가 달라 공식 비교에서 제외했습니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
관련 KRBench 테스트
복합 한국어 지시만 주면 조건·예외·계산을 얼마나 정확히 따를까?
첨부파일 없이 25개 레코드의 Decision, Code, Result, Token을 100점으로 비교했습니다.
→ AI 지시 준수 정확도 비교 보기VIP·보안·주말 SLA가 섞인 고객지원 티켓은 얼마나 정확히 판정할까?
25개 티켓으로 우선순위, 최초응답 마감, 해결목표, 적용 규칙을 100점으로 비교했습니다.
→ AI 고객지원 SLA 판정 정확도 비교 보기담당자·마감일·금액이 계속 바뀌는 업무 메일을 AI가 끝까지 정확히 추적할까?
취소·재개·완료·과거 수정 철회가 섞인 25개 업무 스레드의 최종 상태를 100점으로 비교했습니다.
→ AI 업무 메일 최종 상태 추적 정확도 비교 보기KRBench는 결과가 비슷하게 나오더라도 차이를 억지로 만들지 않고, 같은 조건에서 확인된 값을 그대로 기록합니다.