같은 한국어 음성을 더 빠르게 들려주면 자동자막 정확도는 얼마나 떨어질까요? 이번에는 약 2분 6초짜리 동일한 원본 음성을 1.25배와 1.50배로 가속한 뒤 Vrew, CapCut, VEED, Notta, Happy Scribe 5개 서비스에 넣어 다시 비교했습니다.
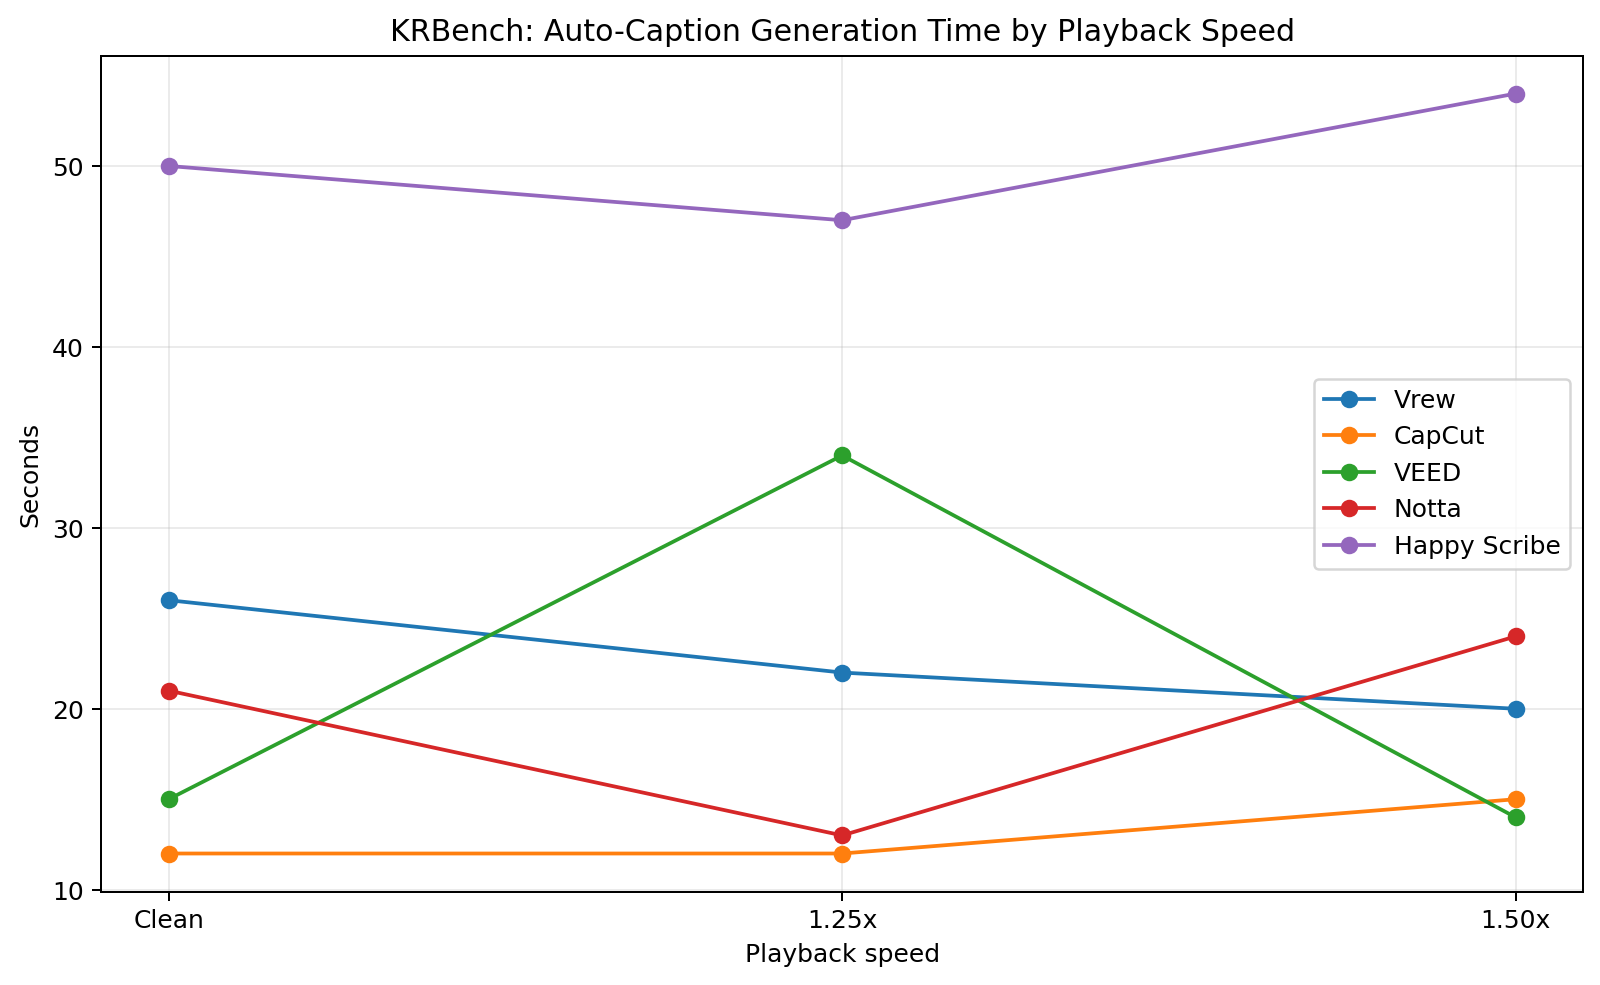
숫자 11개와 영문·약어 8개를 합친 핵심 필드 19개를 기준으로 점수를 계산했고, 의미가 바뀌는 일반 한국어 오류와 누락·중복은 별도로 확인했습니다. 자동자막 생성시간도 Clean, 1.25x, 1.50x에서 각각 측정했습니다.
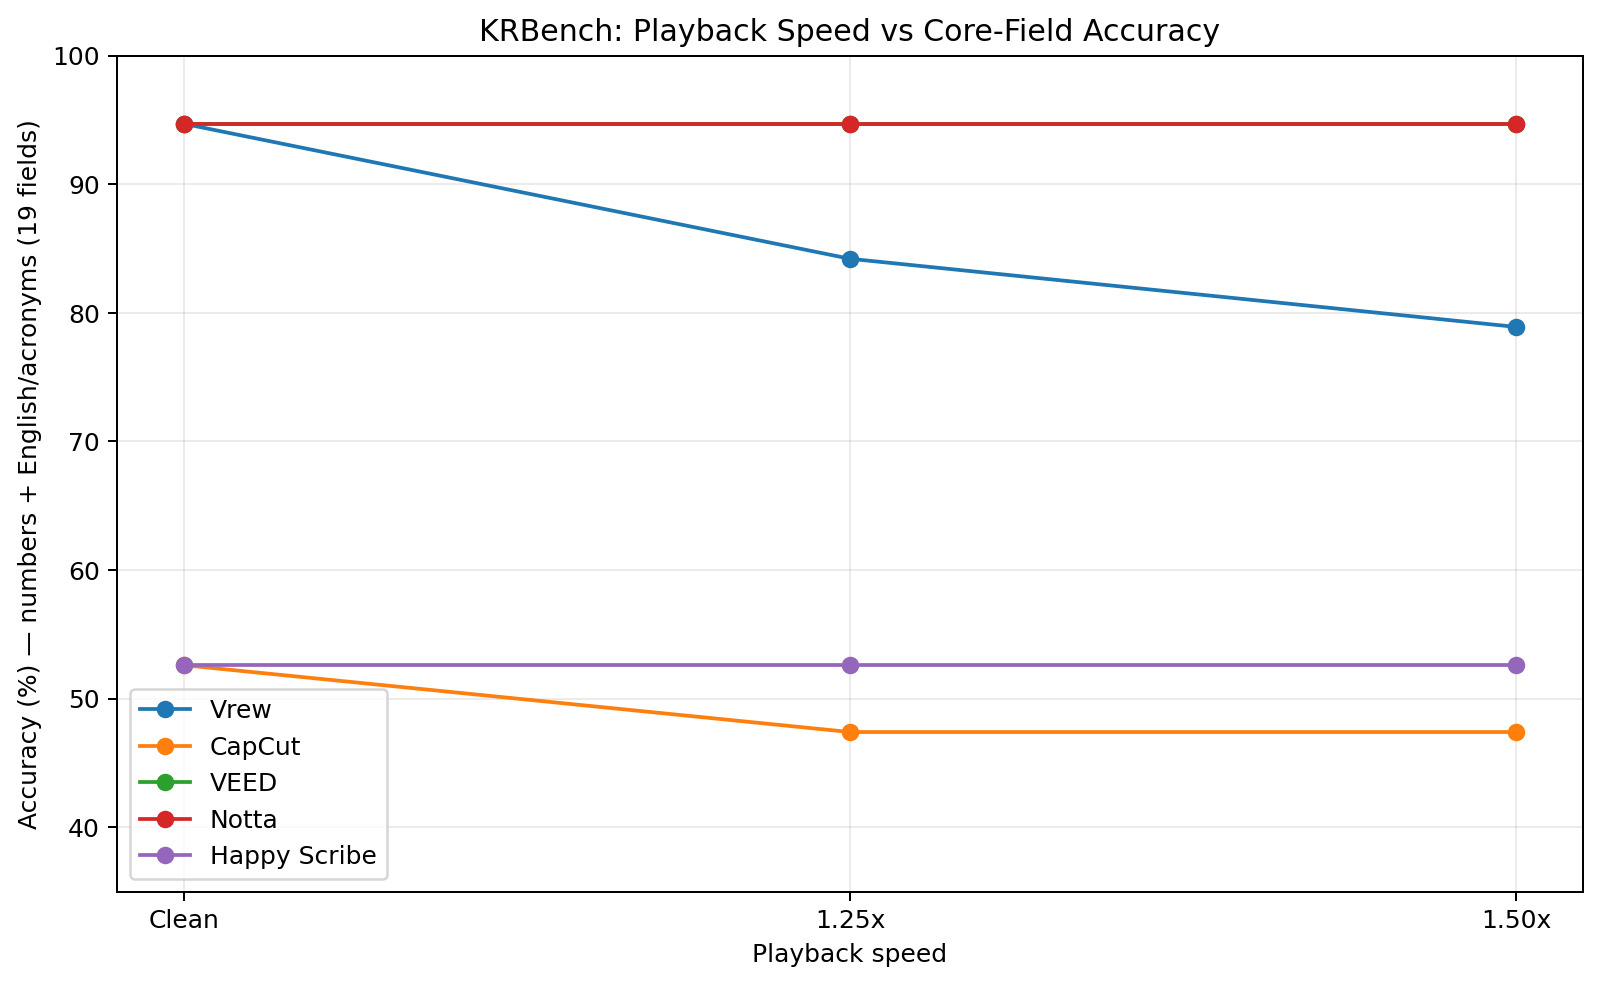
- VEED와 Notta: 1.50배에서도 핵심 필드 정확도가 Clean과 같은 94.7%를 유지했습니다.
- Vrew: 숫자는 유지했지만 속도가 빨라질수록 영문 고유명사 보존이 먼저 떨어졌습니다.
- CapCut: 속도 증가보다 기존 오인식 패턴이 거의 그대로 반복되는 모습이었습니다.
- Happy Scribe: 핵심 필드 점수는 큰 변화가 없었지만 1.50배에서 일반 문장 오류가 하나 더 늘었습니다.
- 이번 통제 실험에서는: 1.50배 가속보다 앞선 SNR 5 dB 배경소음 테스트에서 더 큰 정확도 저하가 나타났습니다.
이 테스트는 ‘실제 빠른 말하기’와 다릅니다
사람이 다시 빠르게 읽은 음성이 아니라 같은 녹음을 피치 변화 없이 1.25배·1.50배로 time-stretch한 통제 실험입니다. 따라서 화자, 발음, 마이크, 문장 내용은 그대로 두고 재생속도만 바꿨을 때의 스트레스를 비교한 결과입니다. 실제 사람이 빠르게 말할 때 나타나는 발음 축약이나 호흡 변화까지 재현한 테스트는 아닙니다.
테스트 조건
| 항목 | 테스트 조건 |
|---|---|
| 테스트 날짜 | 2026년 9월 18일 |
| 원본 음성 | 약 2분 6초, 1인 한국어 음성 |
| 속도 조건 | Clean / 1.25x(약 101초) / 1.50x(약 84초) |
| 변경 방식 | 피치 변화 없이 동일 녹음의 재생속도만 증가 |
| 기기 | MacBook Pro 16형 / Apple M4 Pro / 24GB |
| OS | macOS Tahoe 26.6.2 |
| 비교 서비스 | Vrew / CapCut / VEED / Notta / Happy Scribe |
채점 예외는 이전 글과 동일합니다.
실제 녹음에서는 KTX 이동시간을 2시간 45분으로 읽었기 때문에 실제 발화를 정답으로 사용했습니다.
Claude는 ‘클로드’가 아니라 ‘클라우드’로 잘못 발음한 항목이라 영문 고유명사 점수에서 제외했습니다.
채점 기준
숫자 11개와 영문·약어 8개를 합쳐 19개 핵심 필드를 비교했습니다. 띄어쓰기·문장부호·대소문자·하이픈 차이는 의미가 같으면 정답으로 처리했고, 영문 고유명사가 한글 음차로 바뀐 경우에는 ‘영문·약어 보존’ 항목에서 오답으로 처리했습니다.
숫자 평가 11개: 2026, 9월 18일, 3시 45분, 2시간 45분, 125만 7천 원, 18.5%, 39,900원, 3,000원, 10시 30분, 13명, 1시간 30분
영문·약어 평가 8개: KTX, ChatGPT, Gemini, Vrew, CapCut, GPT-5.6, USB-C, Wi‑Fi 7
Clean → 1.25x → 1.50x 결과
| 서비스 | Clean | 1.25x | 1.50x | 일반 오류 1.25x→1.50x |
생성시간 1.25x→1.50x |
|---|---|---|---|---|---|
| VEED | 18/19 (94.7%) | 18/19 (94.7%) | 18/19 (94.7%) | 0 → 0* | 34초 → 14초 |
| Notta | 18/19 (94.7%) | 18/19 (94.7%) | 18/19 (94.7%) | 0 → 0 | 13초 → 24초 |
| Vrew | 18/19 (94.7%) | 16/19 (84.2%) | 15/19 (78.9%) | 1 → 1 | 22초 → 20초 |
| CapCut | 10/19 (52.6%) | 9/19 (47.4%) | 9/19 (47.4%) | 5 → 5 | 12초 → 15초 |
| Happy Scribe | 10/19 (52.6%) | 10/19 (52.6%) | 10/19 (52.6%) | 2 → 3 | 47초 → 54초 |
* VEED는 무료 계정에서 전체 텍스트 파일 반출이 제한돼 전체 구간 캡처를 기준으로 확인했습니다. 이번 글에는 증빙이 글을 과도하게 차지하지 않도록 대표 구간만 작게 넣었습니다.
서비스별 결과
VEED: 1.50배에서도 핵심 필드 점수를 유지
VEED는 Clean, 1.25x, 1.50x 모두 핵심 필드 18/19(94.7%)를 유지했습니다. 숫자 항목은 1.50배에서도 안정적이었고, 기존과 마찬가지로 Wi‑Fi 7을 한글로 표기한 부분이 핵심 차이였습니다. 다만 화면상 자막 분절은 꽤 잘게 나뉘어, 정확도와 별개로 편집 화면의 가독성은 따로 볼 필요가 있었습니다.
Notta: 속도 변화에 가장 일관적인 결과
Notta도 Clean, 1.25x, 1.50x에서 핵심 필드 18/19를 유지했습니다. 숫자와 주요 영문 서비스명은 대부분 그대로 보존됐고 일반 한국어 의미 오류도 확인되지 않았습니다. 이번 속도 스트레스 테스트에서는 가장 변화가 적은 축에 속했습니다.
Vrew: 숫자는 지켰지만 영문 고유명사가 먼저 떨어졌다
Vrew는 1.25배와 1.50배에서도 숫자 항목은 모두 유지했습니다. 반면 속도가 올라가면서 Gemini, Vrew, CapCut 등의 영문명이 한글 음차 또는 다른 철자로 바뀌었고, 1.50배에서는 ChatGPT 표기도 일부 흔들렸습니다. 일반 문장에서는 ‘긴 문장’이 잘못 적히는 오류가 두 속도에서 반복됐습니다.
CapCut: 속도보다 기존 인식 패턴의 영향이 더 컸다
CapCut은 1.25배와 1.50배의 핵심 필드 점수가 동일했습니다. ‘시간→10간’, ‘일정→1정’, ‘2시간→두 10간’, ‘1시간 반→한 10간 반’처럼 Clean 테스트에서도 보였던 오류 유형이 빠른 조건에서도 거의 그대로 이어졌습니다. 즉 이번 샘플에서는 속도 증가 자체보다 기존 인식 특성이 더 강하게 보였습니다.
Happy Scribe: 핵심 필드는 비슷했지만 1.50배에서 일반 문장 오류 증가
Happy Scribe는 핵심 필드 점수만 보면 Clean·1.25배·1.50배가 동일했습니다. 다만 18.5%를 185%로 기록하는 기존 숫자 오류가 유지됐고, 1.50배에서는 KTX 누락과 일부 일반 문장 오류가 추가로 확인됐습니다.
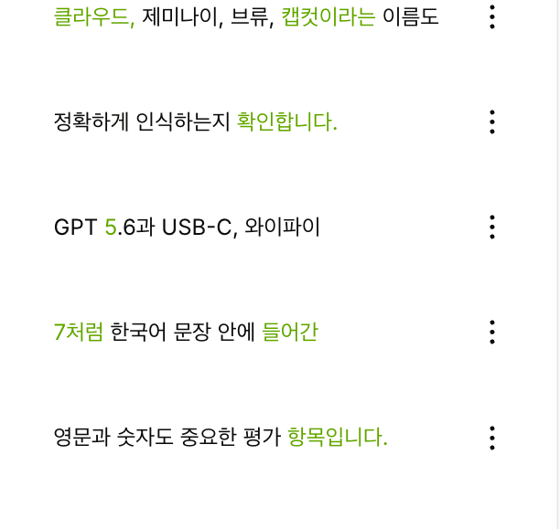
VEED 실제 화면 일부
VEED는 전체 캡처가 세로로 길어 글의 흐름을 방해하기 때문에, 이번에는 대표 구간만 작게 잘라 1.25배와 1.50배를 나란히 배치했습니다. 전체 결과는 채점에 사용했지만 본문에는 필요한 만큼만 증빙으로 남겼습니다.
배경소음 테스트와 비교하면
같은 원본을 사용한 이전 배경소음 테스트에서는 SNR 5 dB에서 일부 서비스의 숫자, 문장 의미, 중복 문제가 더 크게 늘었습니다. 반면 이번 재생속도 테스트에서는 VEED와 Notta가 1.50배까지 핵심 필드를 그대로 유지했고, Vrew도 숫자 항목 자체는 잘 버텼습니다.
따라서 이번 한 개 샘플 기준으로는 재생속도 1.50배보다 강한 배경소음이 더 큰 스트레스 요인으로 나타났습니다. 다만 실제 사람이 빠르게 말하는 상황은 발음 축약과 호흡 변화가 추가되므로 별도 자연 발화 테스트가 필요합니다.
이번 테스트의 한계
이번 결과는 한 명의 화자와 하나의 음성 파일을 대상으로 한 통제 실험입니다. 재생속도를 소프트웨어로 올린 것이므로 실제 속사포처럼 말하는 사람의 발음 변화까지 포함하지 않습니다. 또한 각 서비스의 처리시간은 서버 부하, 네트워크 상태, 업로드 과정 등에 영향을 받을 수 있어 생성시간 차이를 모델 자체의 추론속도라고 단정할 수 없습니다.
관련 KRBench 테스트
① 조용한 환경의 기본 정확도부터 확인하기
같은 원본 음성으로 숫자·영문 정확도, 생성시간, 무료 자막 다운로드를 먼저 비교했습니다.
→ 한국어 AI 자동자막 5종 기본 비교 보기② 속도보다 배경소음이 더 큰 변수일까?
같은 원본에 핑크 노이즈를 섞어 SNR 10 dB와 SNR 5 dB에서 정확도가 어떻게 달라지는지도 비교했습니다.
→ 배경소음 자동자막 비교 결과 보기추천 문구보다 같은 조건의 반복 테스트와 실제 측정값을 우선합니다.