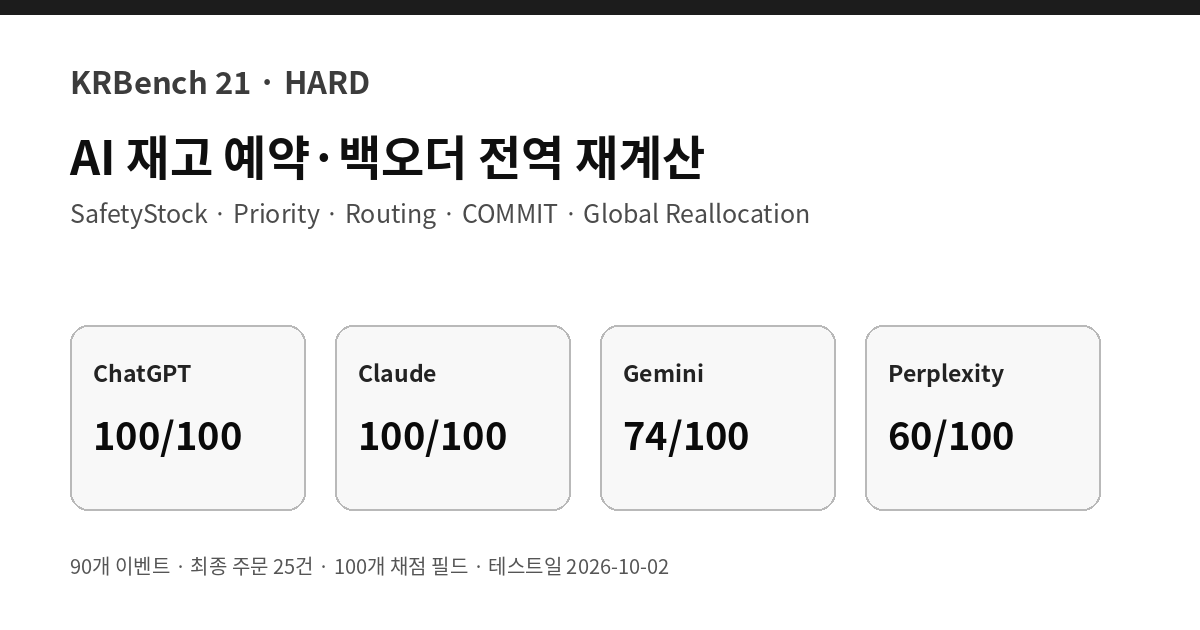
재고 예약 문제는 주문 한 건만 따로 계산하면 비교적 단순합니다. 하지만 여러 주문이 같은 SKU 재고를 공유하고, 우선순위가 바뀌고, 창고 간 재고가 이동하고, 일부 주문이 취소되거나 COMMIT으로 고정되면 한 이벤트가 뒤 주문 전체의 배정 결과를 바꿀 수 있습니다.
KRBench 21호에서는 3개 창고와 4개 SKU, 기존 주문 7건, 이후 90개 이벤트를 하나의 순차 상태 문제로 구성했습니다. 공식 채점은 최종 주문 O08~O32의 Status, AllocatedQty, BackorderQty, AllocationPlan 네 필드, 총 100점입니다.
결과 요약
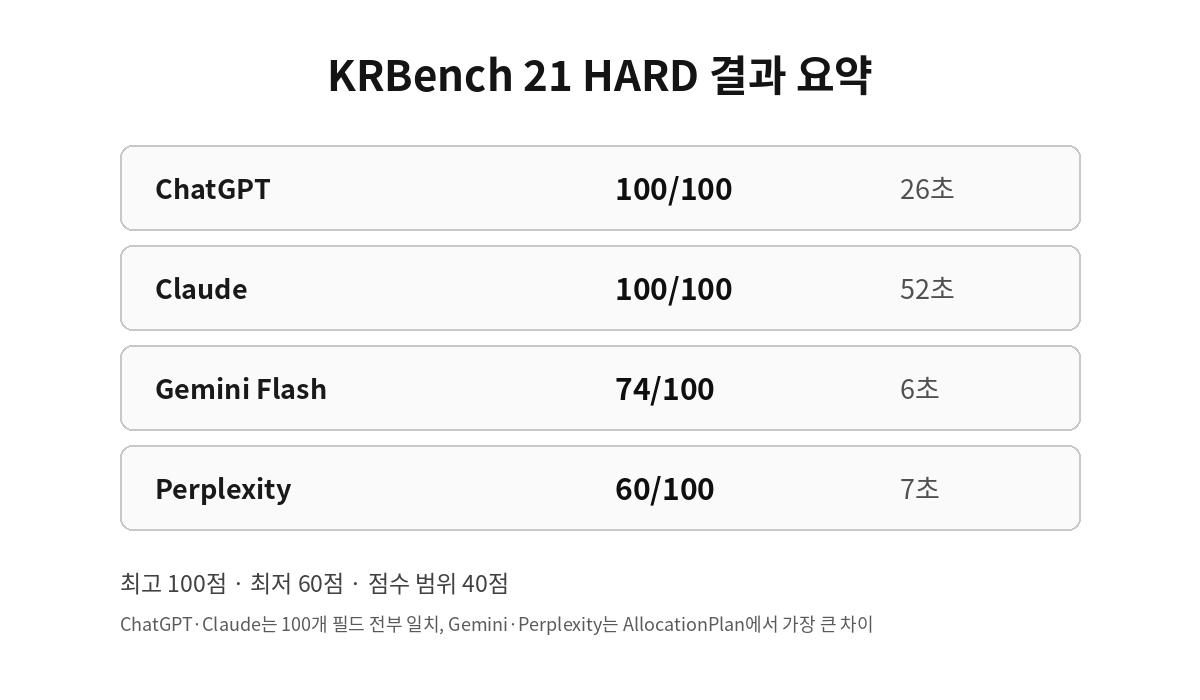
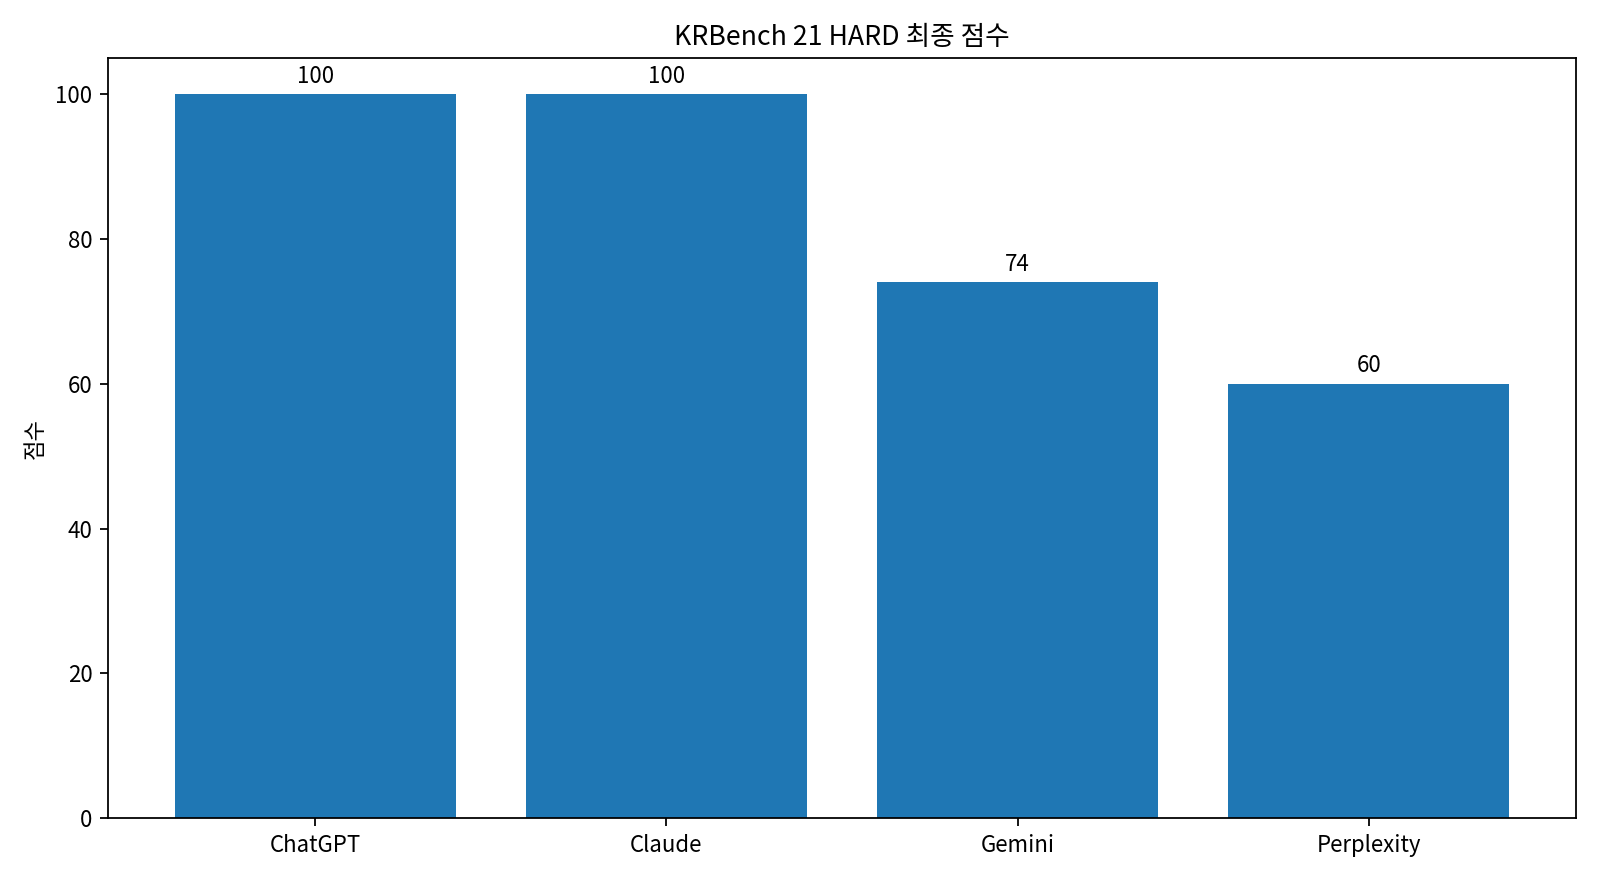
- ChatGPT: 100/100 · 26초
- Claude Sonnet 5.5 · 중간: 100/100 · 52초
- Gemini Flash: 74/100 · 6초
- Perplexity: 60/100 · 7초
- ChatGPT와 Claude는 100개 채점 필드가 모두 사전 Oracle과 일치했습니다.
테스트 방법: 한 이벤트마다 같은 SKU의 주문을 전역 재배정
초기 상태에는 W1, W2, W3 세 창고의 SKU A~D OnHand와 SafetyStock, 그리고 O01~O07 기존 주문이 있습니다. 이후 CREATE, RECEIPT, DAMAGE, MOVE, UPDATE, CANCEL, COMMIT 이벤트를 Seq 순서대로 처리했습니다.
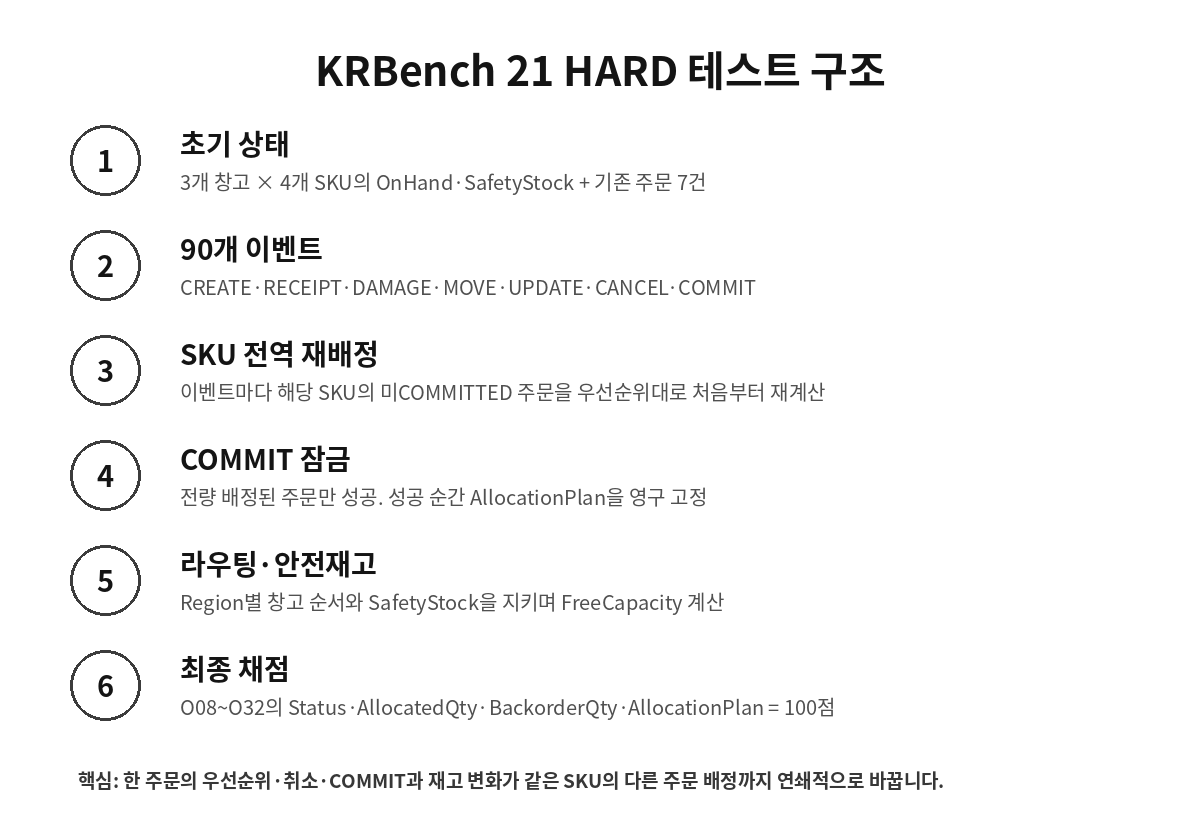
핵심은 단순한 선착순 배정이 아닙니다. 어떤 이벤트가 특정 SKU에 영향을 주면 그 SKU의 ACTIVE·미COMMITTED 주문 배정을 지우고, P1 > P2 > P3, 같은 우선순위에서는 CreatedSeq가 빠른 주문 순서로 처음부터 다시 계산합니다.
각 주문은 Region별 창고 라우팅을 따르며, FreeCapacity는 OnHand에서 SafetyStock과 이미 COMMITTED된 물량을 뺀 값입니다. 미COMMITTED 배정은 잠정 상태라 이후 더 높은 우선순위 주문이나 재고 변화가 생기면 창고와 배정량이 달라질 수 있습니다.
COMMIT이 성공하면 배정 결과가 잠긴다
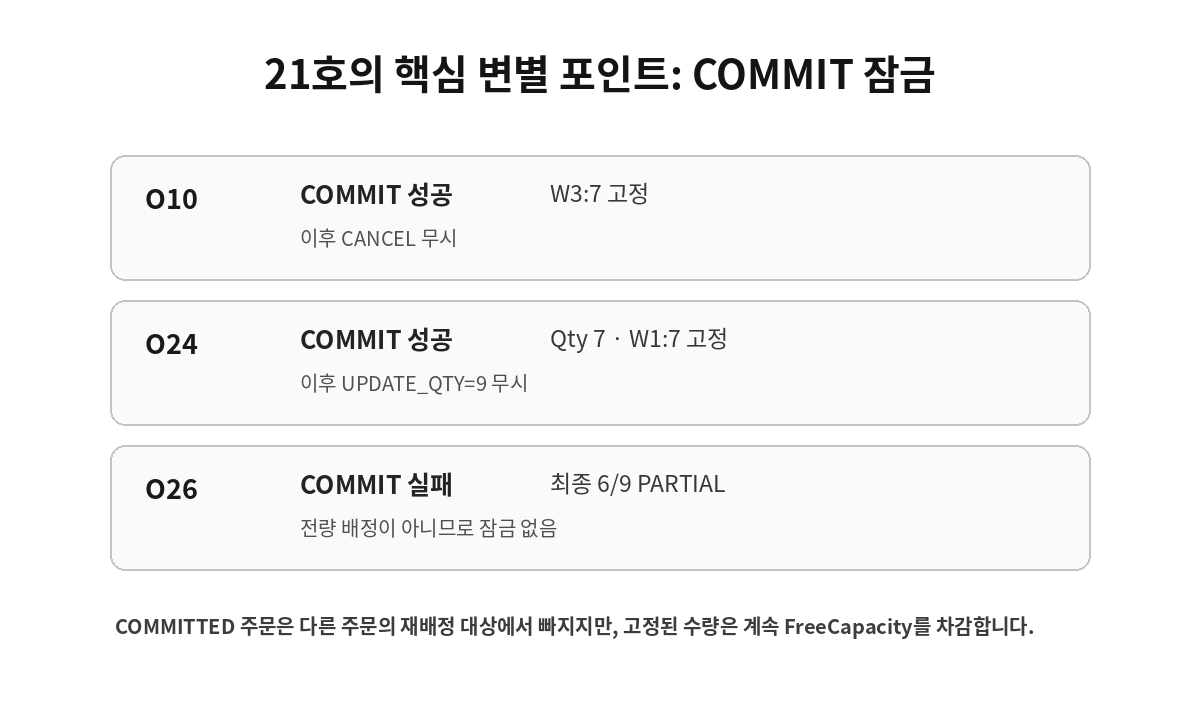
COMMIT은 해당 시점에 주문이 ACTIVE·미COMMITTED이고 Qty 전량이 배정된 경우에만 성공합니다. 성공하면 그 순간의 AllocationPlan이 고정되고, 이후 CANCEL이나 Qty·Priority·Region UPDATE는 무시됩니다.
반대로 전량 배정되지 않은 주문의 COMMIT은 무효입니다. 이번 테스트에는 이 규칙을 직접 확인할 수 있는 이벤트를 넣었습니다.
채점 기준: 25개 주문 × 4개 필드 = 100점
| 항목 | 주문당 | 총 배점 |
|---|---|---|
| Status | 1점 | 25점 |
| AllocatedQty | 1점 | 25점 |
| BackorderQty | 1점 | 25점 |
| AllocationPlan | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
숨은 정답과 채점 기준은 서비스 결과를 보기 전에 결정론적 이벤트 시뮬레이터로 생성해 고정했습니다. 이벤트별 적용·무시 여부와 재고 상태도 Oracle trace로 보존했습니다.
전체 결과: 60점부터 100점까지 40점 차이
| 서비스 | Status | AllocatedQty | BackorderQty | AllocationPlan | 총점 | 응답시간 |
|---|---|---|---|---|---|---|
| ChatGPT | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 26초 |
| Claude Sonnet 5.5 · 중간 | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 52초 |
| Gemini Flash | 21/25 | 19/25 | 19/25 | 15/25 | 74/100 | 6초 |
| Perplexity | 17/25 | 15/25 | 19/25 | 9/25 | 60/100 | 7초 |
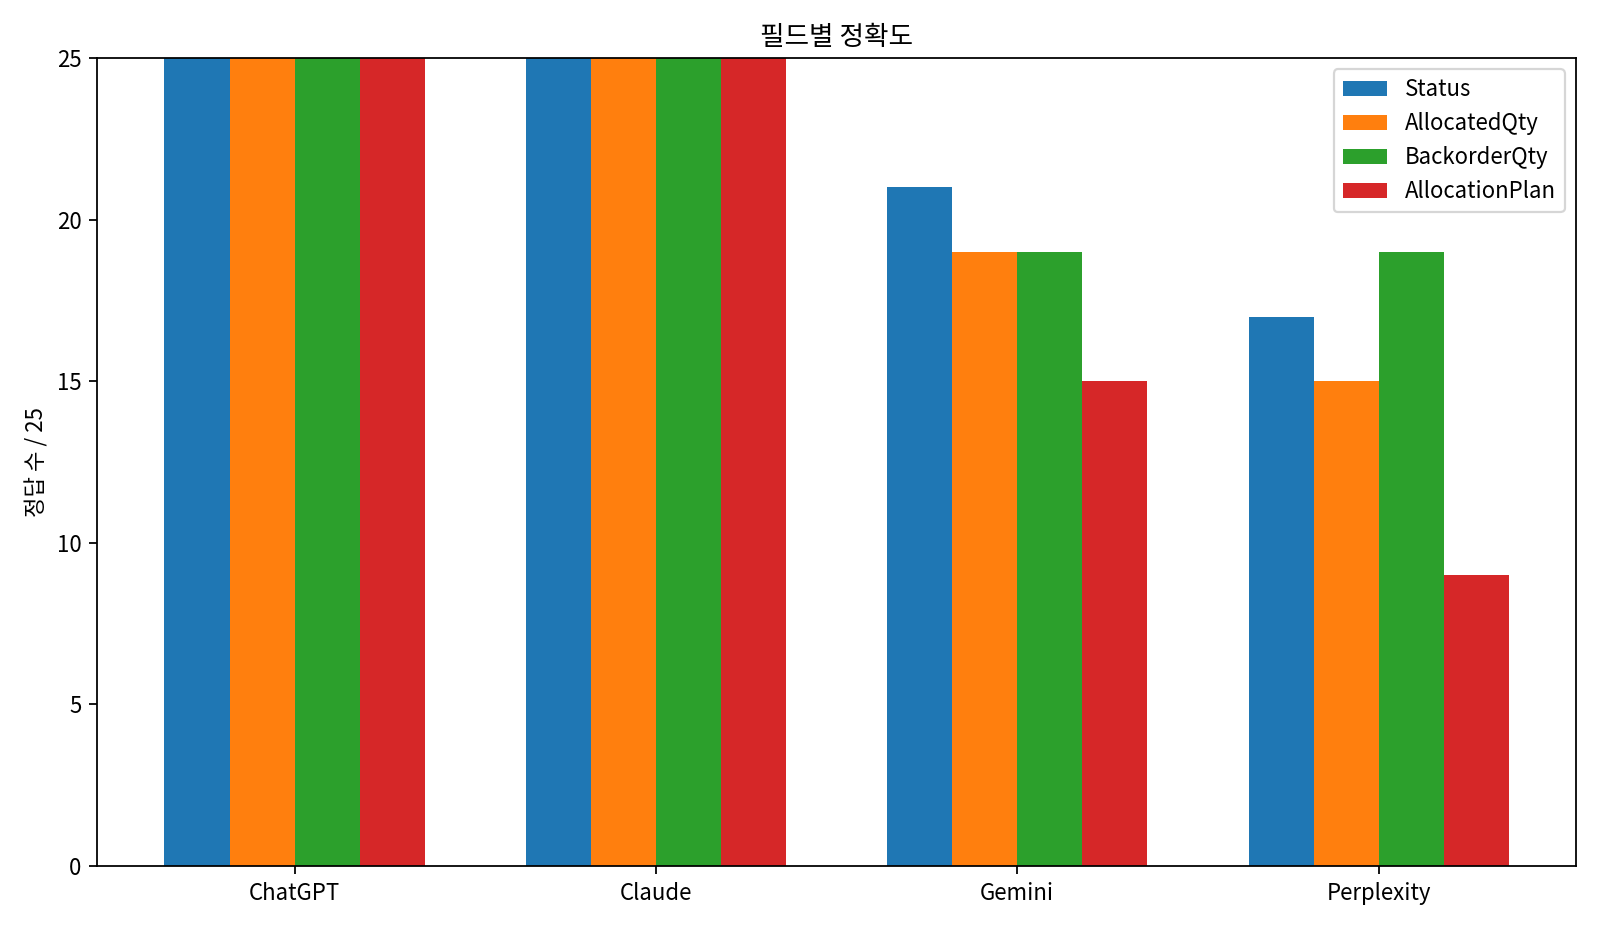
가장 큰 차이는 AllocationPlan에서 나왔습니다. ChatGPT와 Claude는 25개 모두 맞혔고, Gemini는 15/25, Perplexity는 9/25였습니다. 즉 최종 수량뿐 아니라 어느 창고에서 몇 개를 배정했는지까지 추적할 때 차이가 더 커졌습니다.
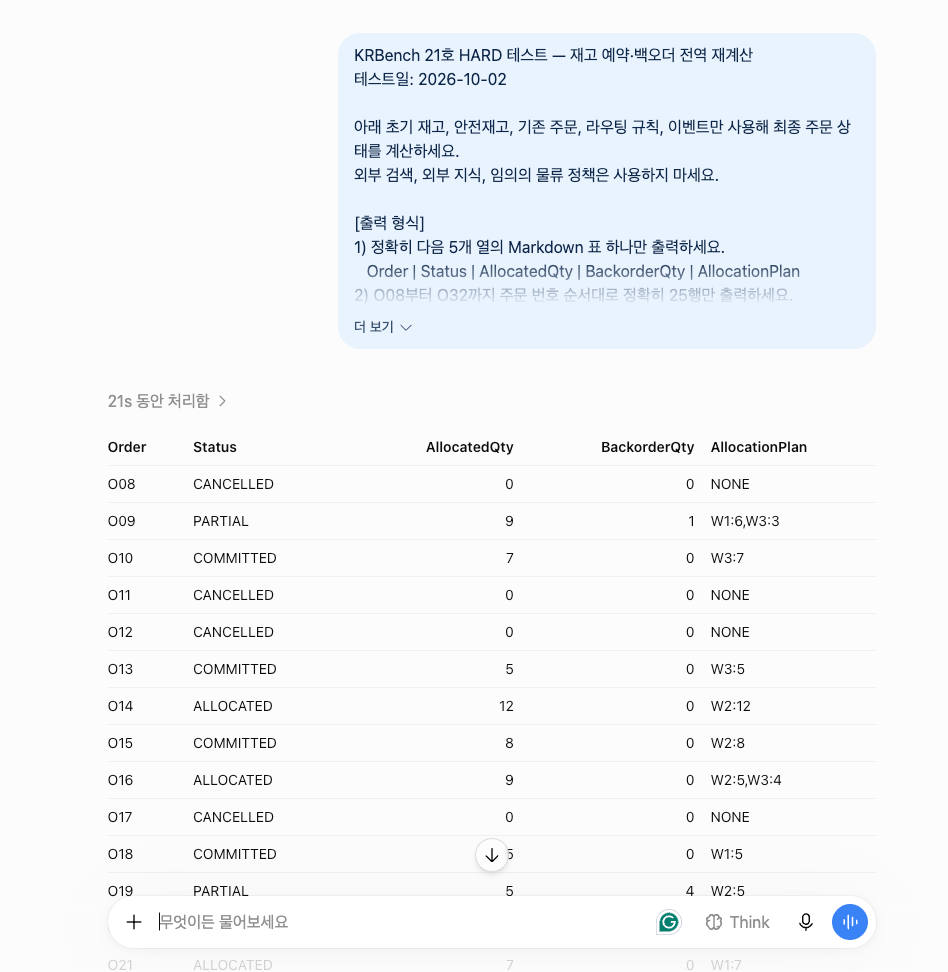
ChatGPT: 100개 채점 필드 모두 일치
ChatGPT는 O08~O32의 Status, AllocatedQty, BackorderQty, AllocationPlan을 모두 맞혀 100점을 기록했습니다.
COMMIT된 주문의 배정 고정, CANCEL 뒤 용량 반환, Priority·Qty·Region 변경 이후 전역 재배정, SafetyStock 변경과 MOVE·RECEIPT·DAMAGE까지 사전 Oracle과 일치했습니다.
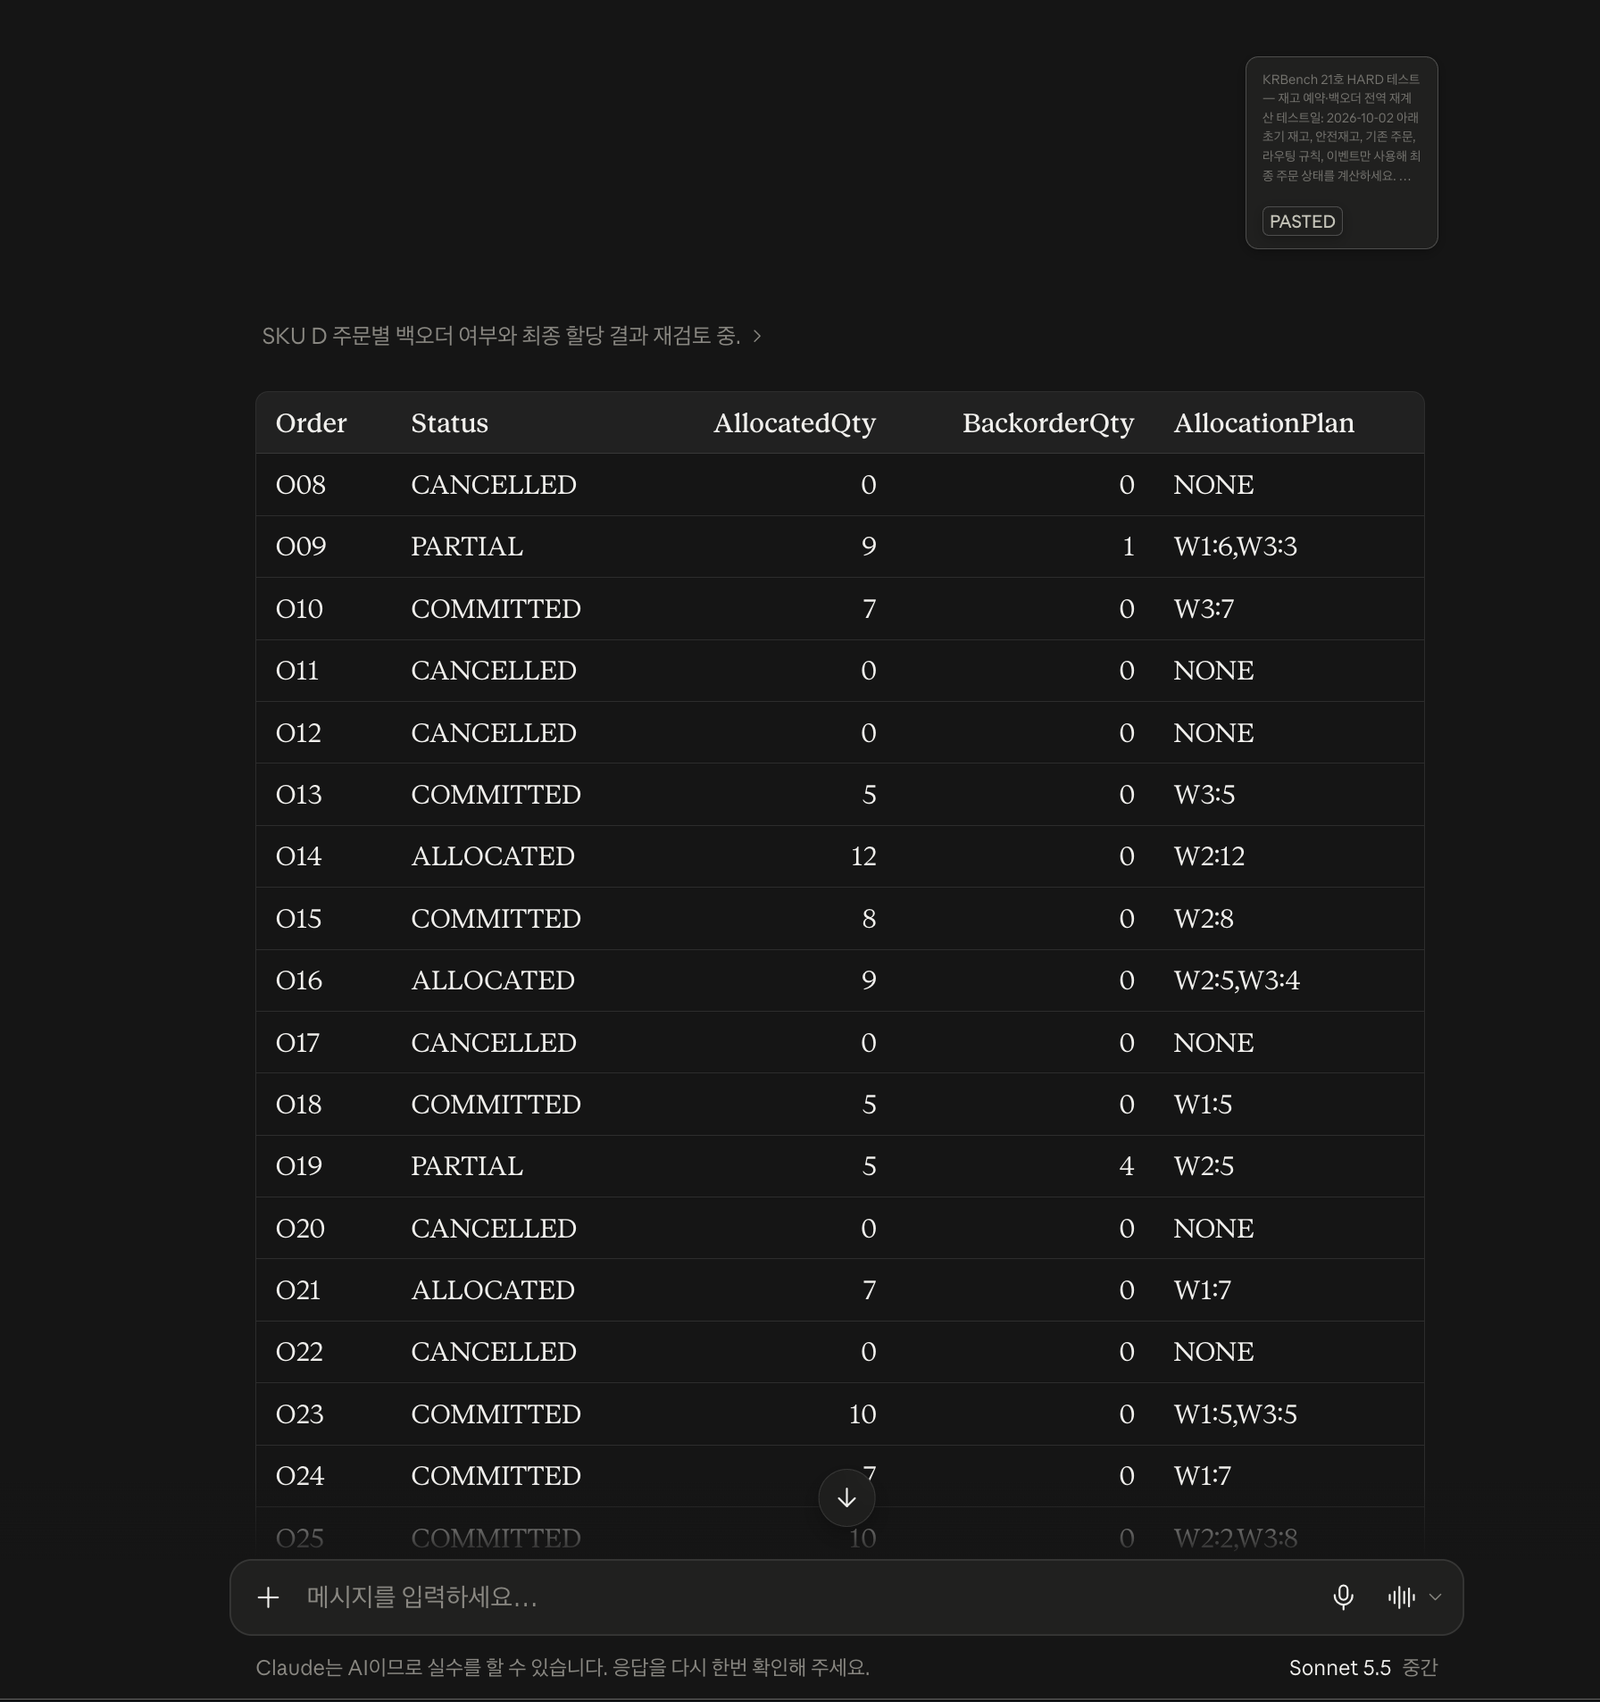
Claude: 100점, 같은 전역 재배정 결과
Claude Sonnet 5.5 · 중간도 100개 필드를 전부 맞혔습니다. 특히 PARTIAL과 BACKORDER 주문의 잔여 수량, COMMITTED 주문의 고정 AllocationPlan, 후반부 재고 이벤트 이후의 최종 배정까지 모두 사전 정답과 일치했습니다.
Gemini 74점: 10개 주문에서 전역 재배정 결과 차이
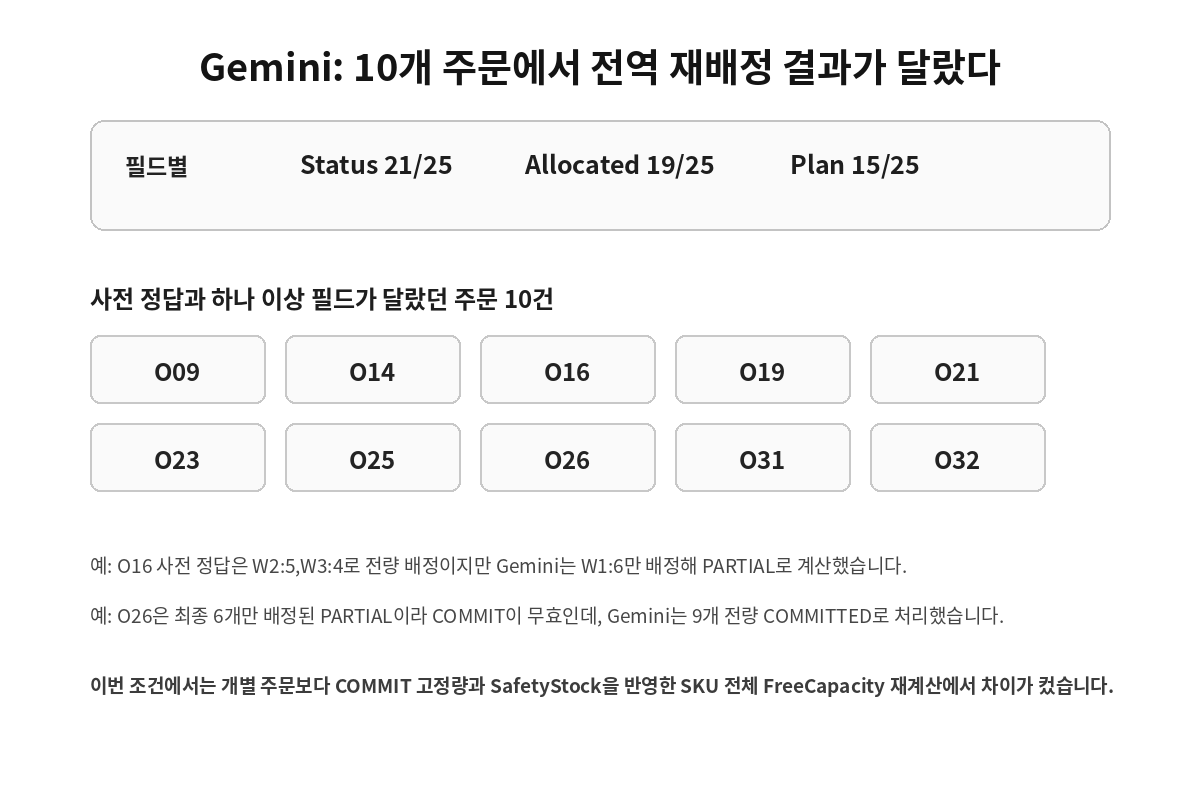
Gemini Flash는 25개 주문 중 15개를 네 필드 모두 정확히 맞혔습니다. 나머지 10개 주문에서는 하나 이상의 필드가 사전 정답과 달랐습니다.
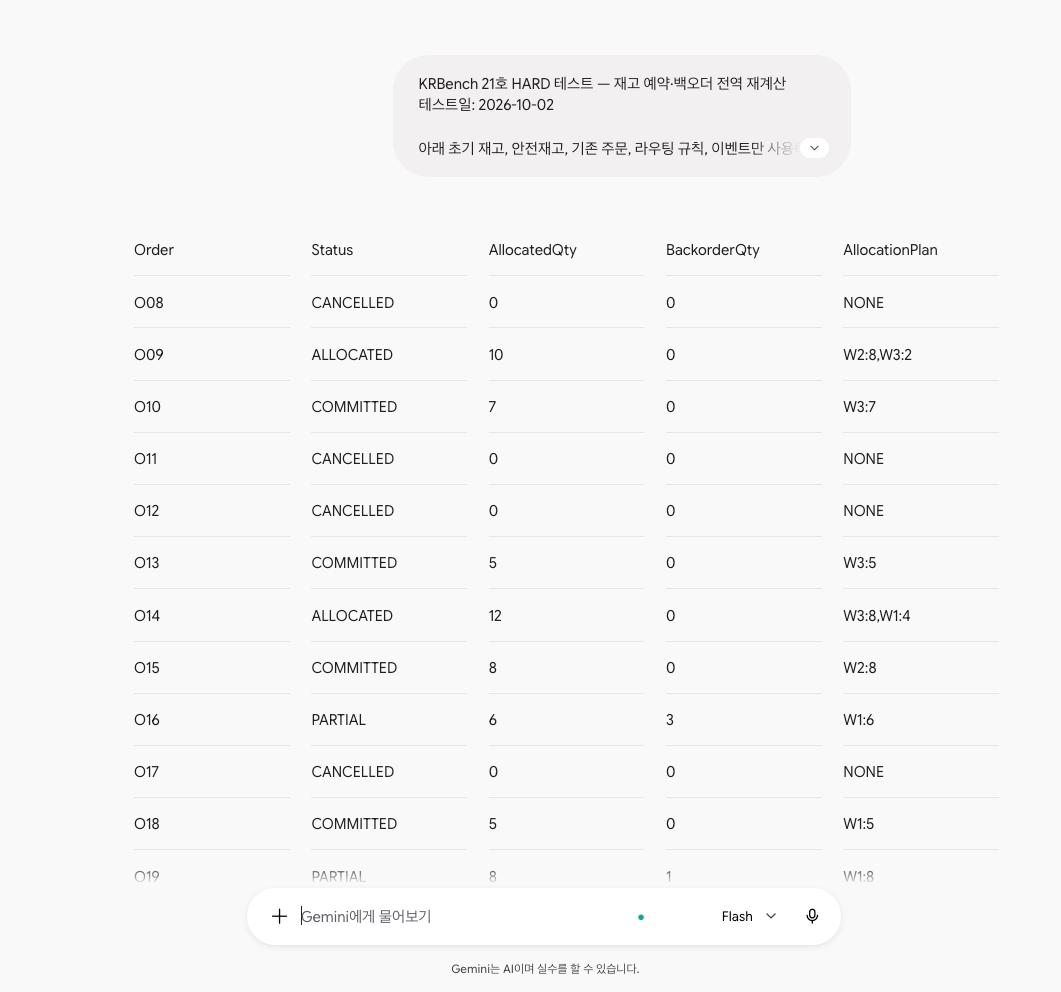
필드별로는 Status 21/25, AllocatedQty 19/25, BackorderQty 19/25, AllocationPlan 15/25였습니다. 대표적으로 O16은 사전 정답에서 W2:5,W3:4로 전량 배정되어 ALLOCATED지만 Gemini는 W1:6만 배정해 PARTIAL로 계산했습니다.
O26은 최종 시점에 6개만 배정된 PARTIAL 주문이라 COMMIT 이벤트가 무효인데, Gemini는 9개를 W2에 전량 배정한 COMMITTED로 처리했습니다.
Perplexity 60점: COMMIT 잠금과 창고별 배정에서 큰 차이
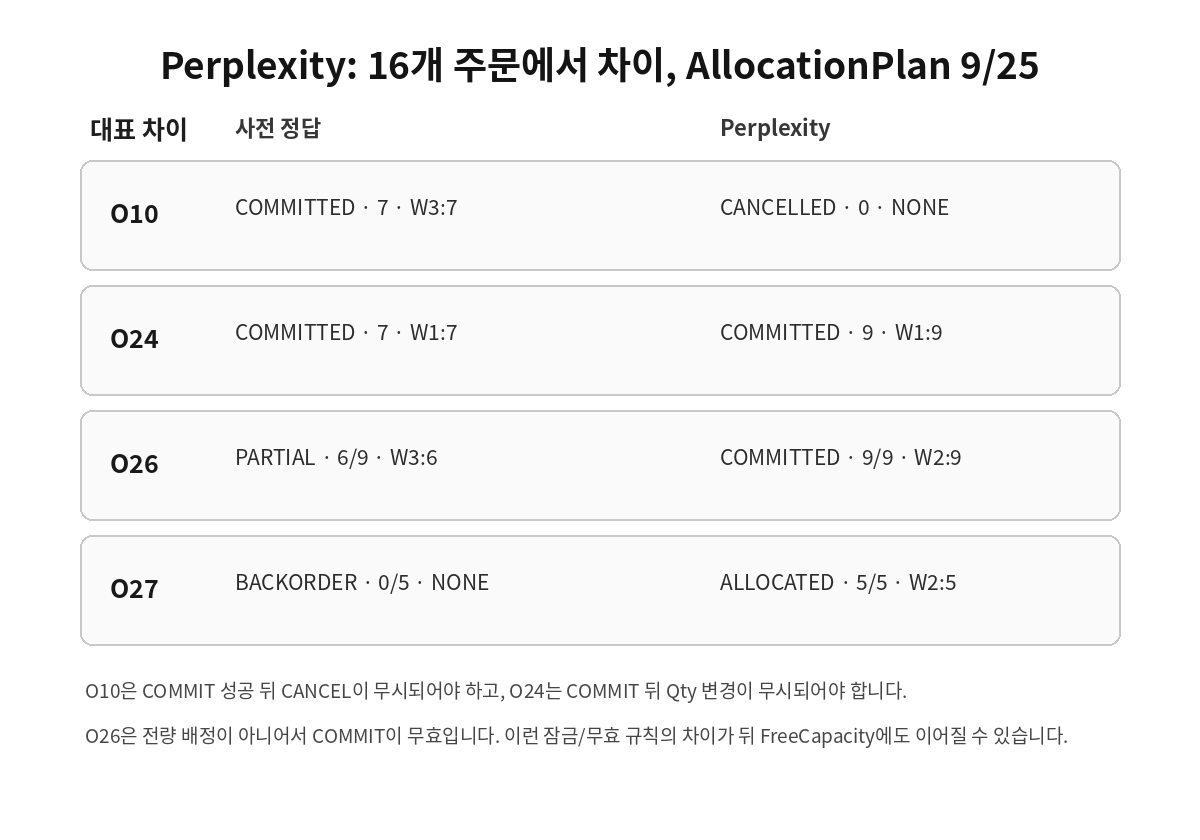
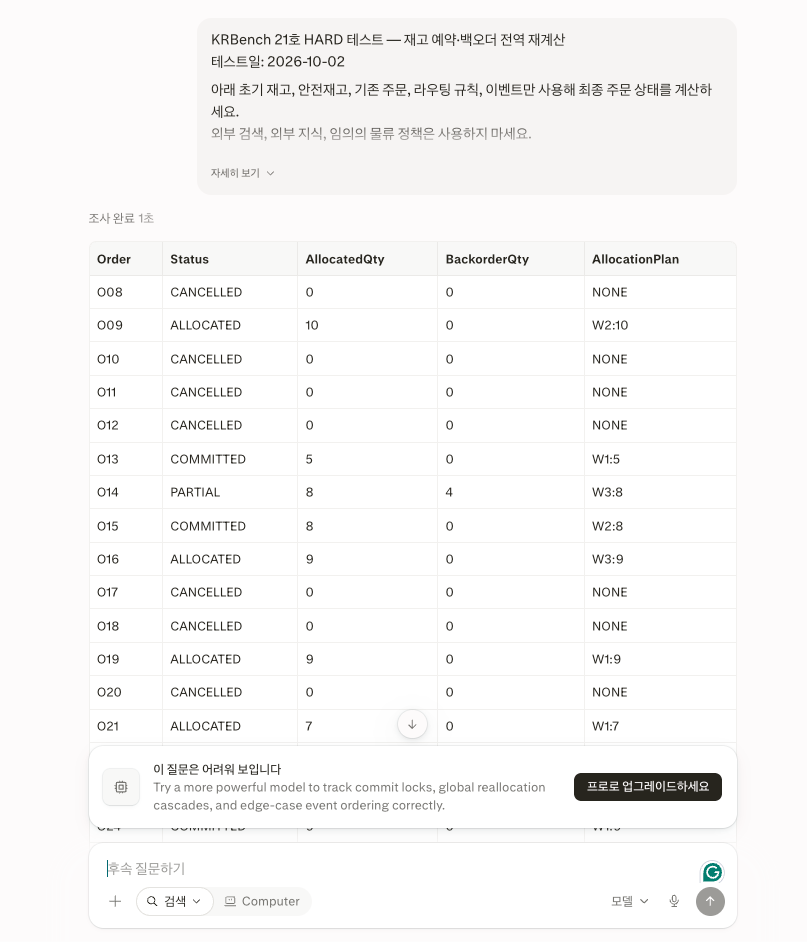
Perplexity는 Status 17/25, AllocatedQty 15/25, BackorderQty 19/25, AllocationPlan 9/25를 기록했습니다. 25개 주문 중 16개에서 하나 이상의 필드가 사전 정답과 달랐습니다.
대표적으로 O10은 COMMIT 성공 뒤의 CANCEL이 무시되어야 하므로 최종 상태가 COMMITTED, AllocationPlan은 W3:7입니다. Perplexity는 이 주문을 CANCELLED로 처리했습니다.
O24도 COMMIT 성공 시 Qty 7, W1:7이 고정된 뒤 UPDATE_QTY=9가 무시되어야 하지만 Perplexity는 COMMITTED 상태에서 9개로 바꿨습니다. O26은 전량 배정되지 않아 COMMIT이 무효여야 하지만 COMMITTED로 처리했습니다.
응답시간: 6초부터 52초
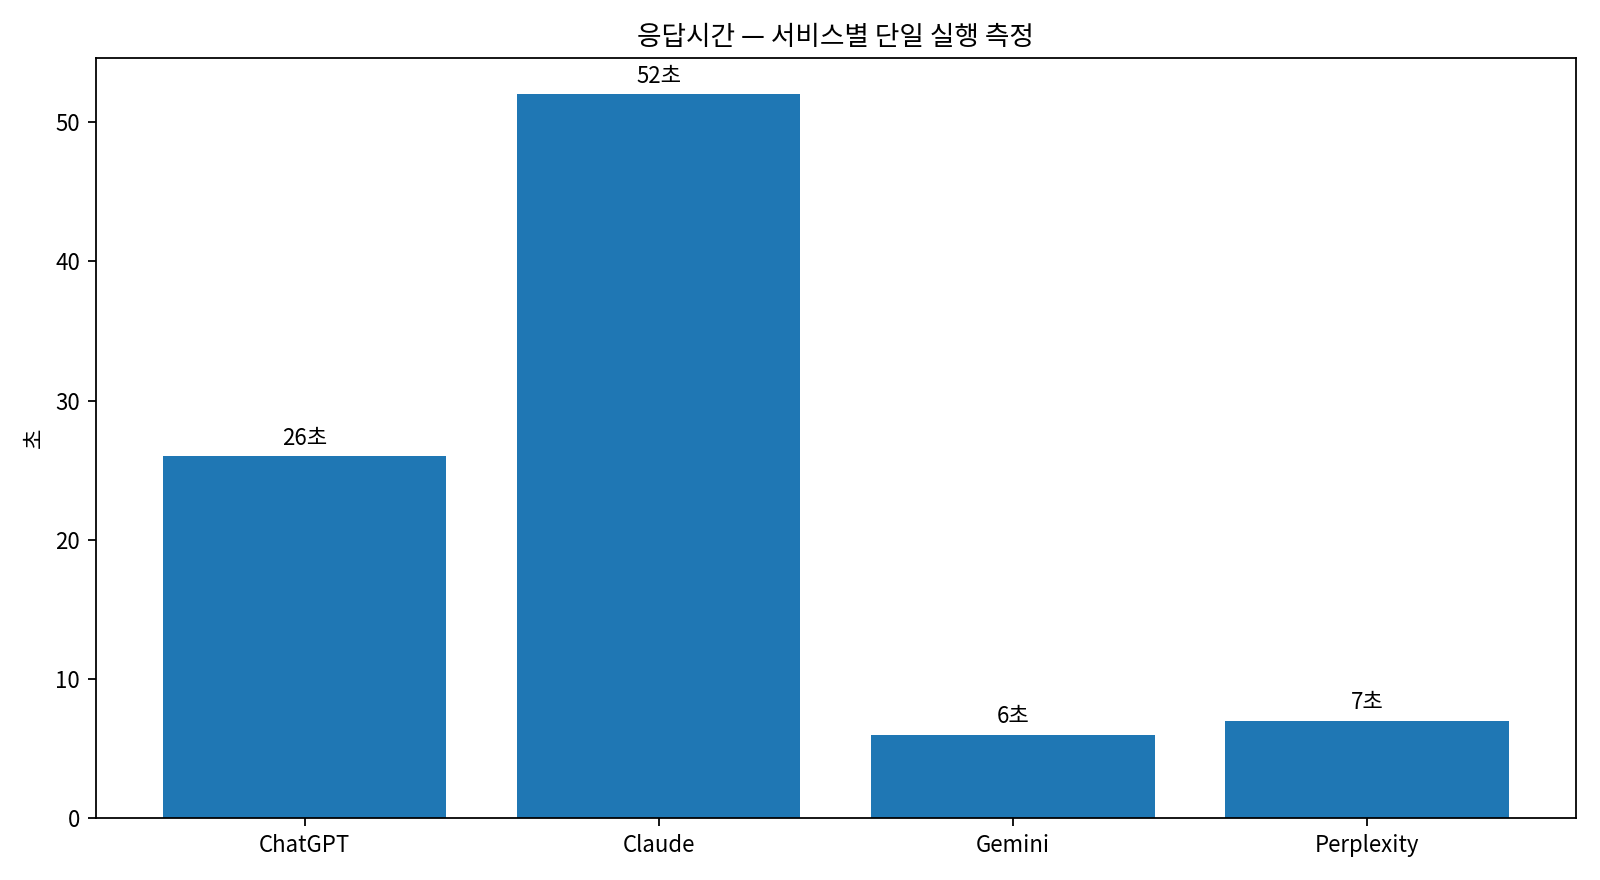
실측 응답시간은 Gemini 6초, Perplexity 7초, ChatGPT 26초, Claude 52초였습니다. 각 서비스에서 한 번만 측정한 값이므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
ChatGPT 화면에는 내부 처리시간으로 21초가 표시됐지만, 공식 기록은 다른 서비스와 같은 기준을 맞추기 위해 사용자가 전송 후 최종 답변이 화면에 모두 출력될 때까지 직접 측정한 26초를 사용했습니다.
NotebookLM은 공식 비교에서 제외
이번 테스트는 문서에서 근거를 찾는 문제가 아니라 하나의 긴 프롬프트 안에서 주문·재고 상태를 계속 갱신하는 일반 채팅형 전역 계산 문제입니다. NotebookLM은 다른 서비스와 동일한 일반 채팅 입력 경로를 맞추기 어려워 공식 비교에서 제외했습니다.
21호에서 확인된 점
이번 조건에서는 결과 차이가 단순히 최종 재고 수량을 계산하는 데서 끝나지 않았습니다. COMMIT된 물량을 잠근 채 남은 FreeCapacity를 다시 계산하고, 미COMMITTED 주문만 우선순위에 따라 매 이벤트마다 재배정하는 과정에서 서비스별 차이가 크게 나타났습니다.
18호 일정 재계산, 19호 예산 승인, 20호 계약 청구에 이어 21호 재고 예약에서도 앞선 상태가 뒤 결과를 바꾸는 전역 상태 문제가 40점의 점수 범위를 만들었습니다. 다만 이 결과는 이번 합성 물류 규칙과 한 번의 첫 응답을 기준으로 한 것으로, 서비스 전체 성능을 뜻하지 않습니다.
이번 테스트의 한계
- 실제 WMS나 ERP 데이터가 아니라 KRBench가 만든 합성 재고·주문 데이터입니다.
- 창고는 3개, SKU는 4개로 단순화했습니다.
- 리드타임, 운송비, 로트, 유통기한, 피킹 용량, 주문 분할 비용은 포함하지 않았습니다.
- COMMIT과 SafetyStock 규칙도 테스트를 위해 명시적으로 단순화한 가상 정책입니다.
- 공식 채점은 최종 O08~O32 25개 주문만 대상으로 했습니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
관련 KRBench 테스트
계약 변경·철회·Credit이 겹치면 AI가 최종 청구액을 계산할까?
8개 계약의 57개 이벤트를 처리하고 25개 청구서의 상태, Credit 사용액, 최종 청구액을 비교했습니다.
→ AI 계약 변경 이력·청구액 HARD 테스트 보기11호~20호 업무 벤치마크 10편을 한 번에 보면?
문서 근거, 규정 판단, 상태 추적, 일정·예산·계약 계산에서 반복된 오류 유형과 HARD 전환 전후를 중간결산으로 정리했습니다.
→ KRBench 업무 벤치마크 10편 중간결산 보기그룹 상속·Rule 우선순위·리소스 이동이 겹치면 AI가 접근 권한을 정확히 판정할까?
45개 순차 이벤트와 25개 CHECK로 접근 허용·거절뿐 아니라 WinningRule, Principal, Scope 근거까지 100점으로 비교했습니다.
→ AI 접근 권한 판정 HARD 테스트 보기KRBench는 결과 차이가 크거나 작더라도 사전 정답과 채점 기준을 바꾸지 않고, 같은 조건에서 확인된 첫 응답을 그대로 기록합니다.