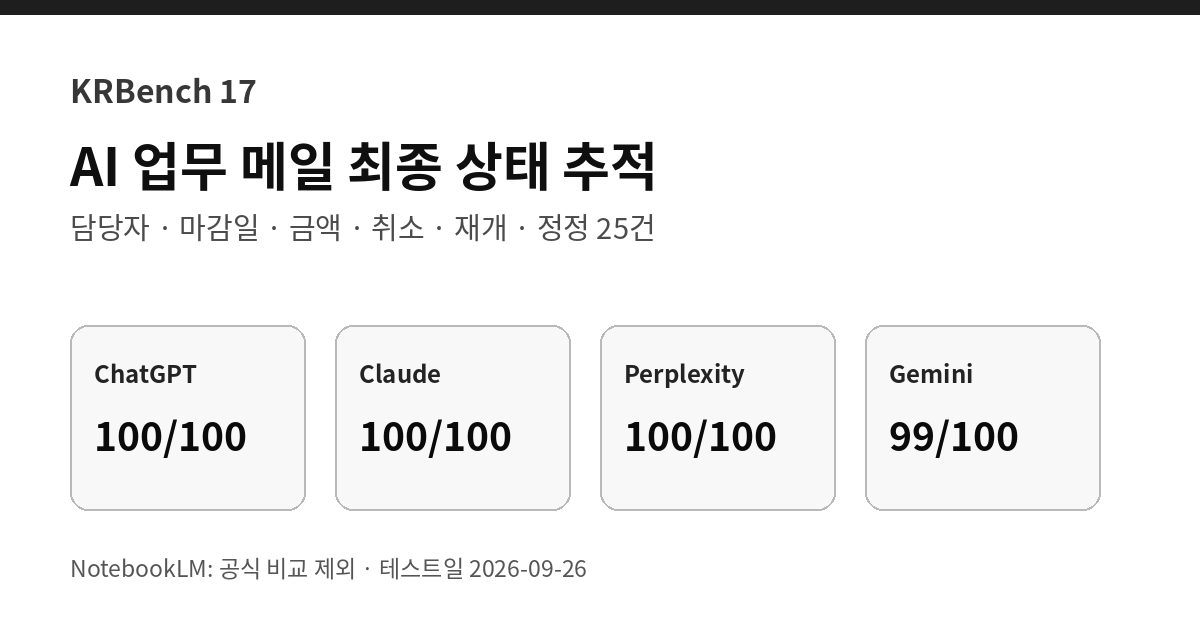
업무 메일은 마지막 메시지만 읽는다고 최종 상태가 결정되지 않을 때가 있습니다. 담당자가 여러 번 바뀌거나, 마감일과 금액이 수정되고, 업무가 취소됐다가 다시 열리거나, 이미 보낸 수정 메일을 나중에 철회하는 경우가 있기 때문입니다.
KRBench 17호에서는 이런 흐름을 25개 업무 스레드로 만들고 ChatGPT, Gemini, Claude, Perplexity가 각 건의 최종 상태, 담당자, 마감일, 금액을 얼마나 정확히 복원하는지 비교했습니다. 첨부파일 없이 같은 단일 프롬프트를 새 대화에 그대로 입력했고 첫 응답만 채점했습니다.
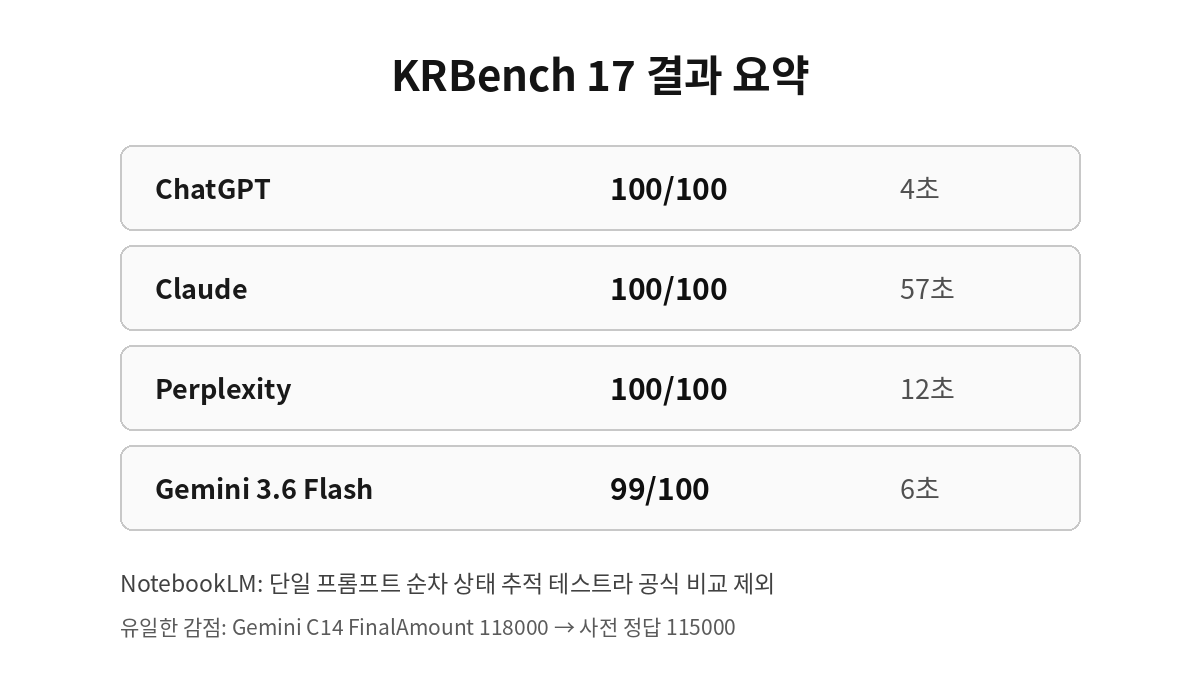
결과 요약
- ChatGPT: 100/100 · 4초
- Claude Sonnet 5 · 중간: 100/100 · 57초
- Perplexity: 100/100 · 12초
- Gemini 3.6 Flash: 99/100 · 6초
- NotebookLM: 공식 비교 제외 — 단일 프롬프트 순차 상태 추적 테스트
테스트 방법: 수정·취소·재개·철회를 순서대로 끝까지 추적
각 Case는 INIT 메시지로 시작하고, 이후 UPDATE, CANCEL, REOPEN, DONE, RETRACT가 이어집니다. UPDATE는 현재 상태가 OPEN일 때만 적용하며, CANCELLED 또는 DONE 상태에서 도착한 UPDATE는 나중에 업무가 다시 열려도 되살아나지 않도록 규칙을 고정했습니다.
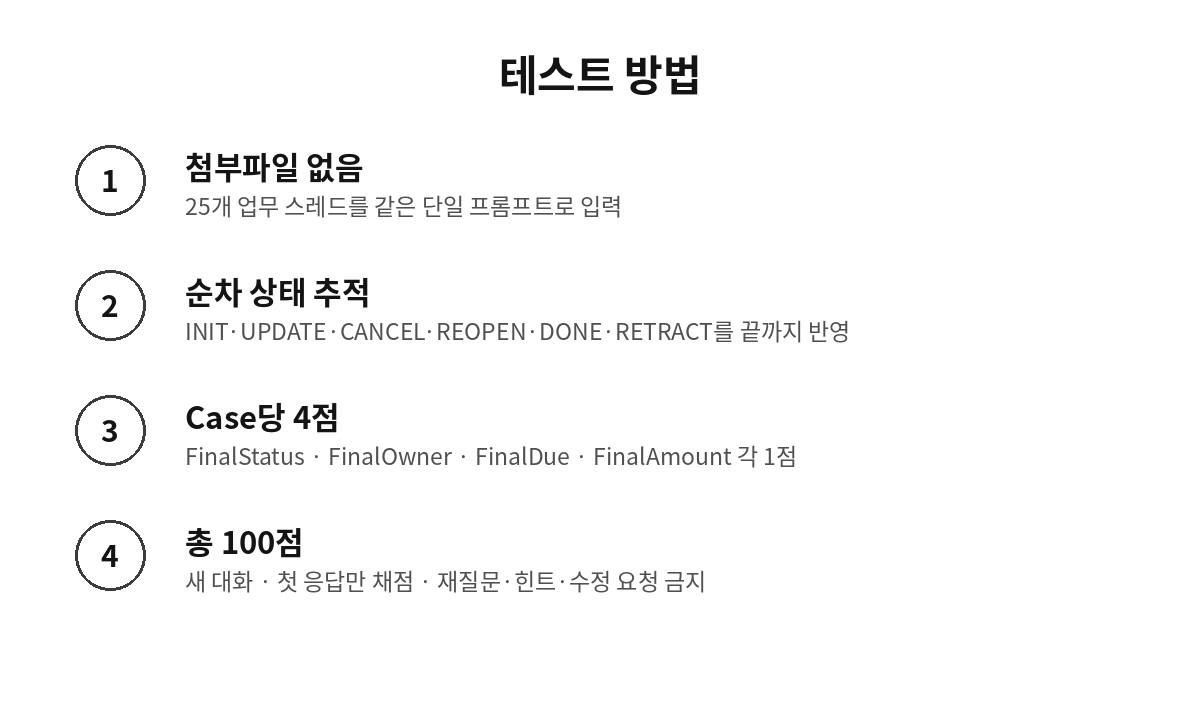
RETRACT Mxx는 같은 Case의 해당 UPDATE 메시지를 처음부터 없었던 것으로 처리합니다. 따라서 단순히 마지막 메시지를 적용하는 방식이 아니라, 과거 변경을 소급해 제거한 뒤 최종 상태를 다시 계산해야 하는 Case도 포함했습니다.
채점 기준: 25건 × 4개 최종 필드 = 100점
| 항목 | Case당 | 총 배점 |
|---|---|---|
| FinalStatus | 1점 | 25점 |
| FinalOwner | 1점 | 25점 |
| FinalDue | 1점 | 25점 |
| FinalAmount | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
정답과 규칙, 배점은 결과를 확인하기 전에 고정했습니다. 재질문이나 힌트, 수정 요청은 공식 채점에 반영하지 않았습니다.
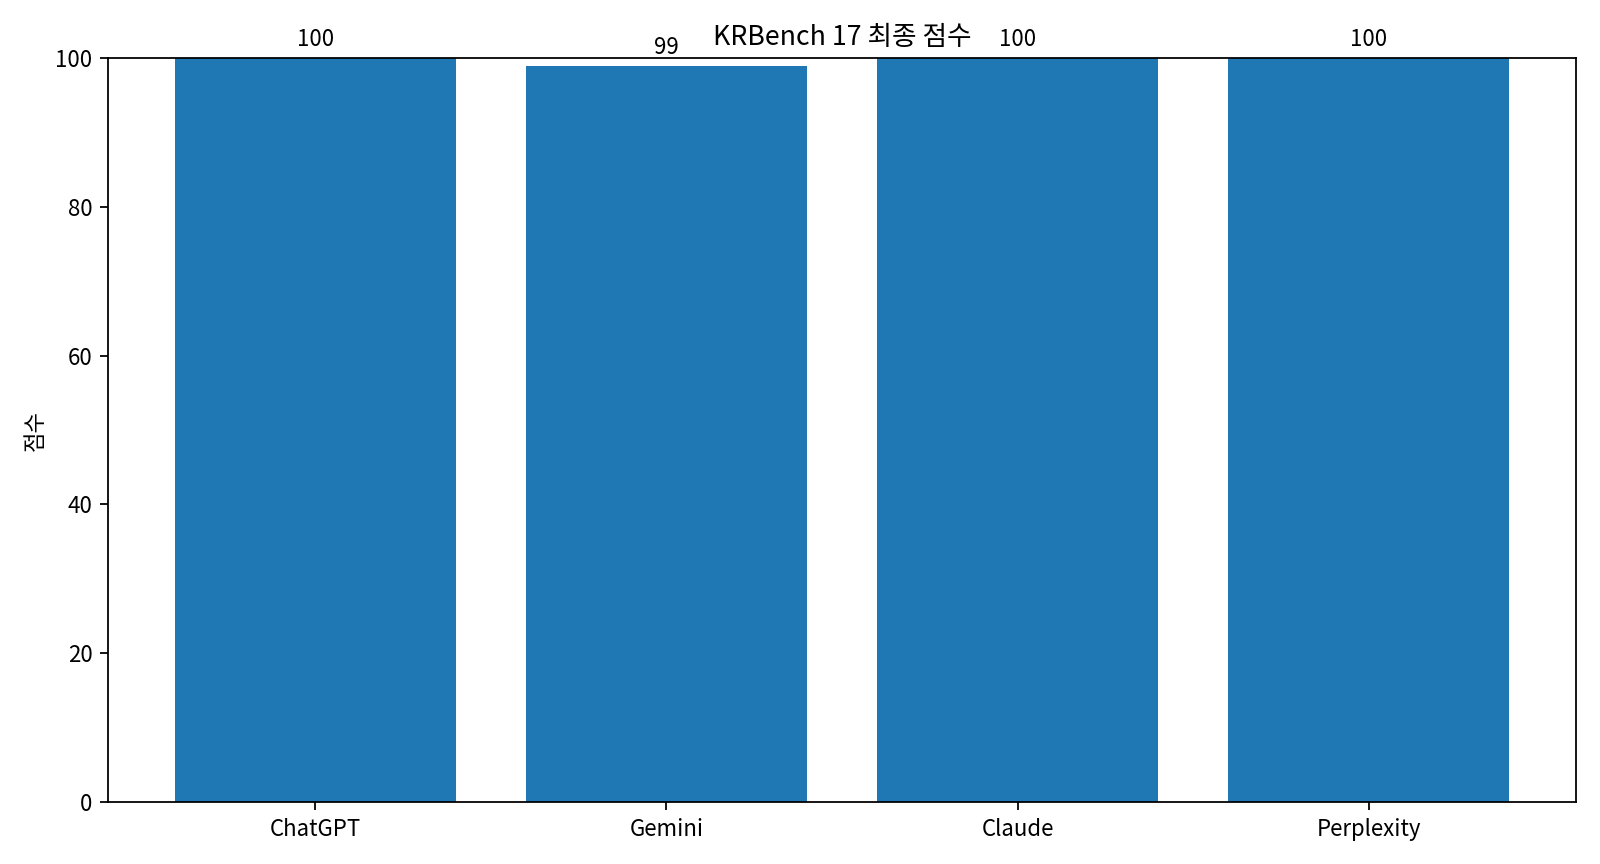
전체 결과: 3개 서비스 100점, Gemini 99점
| 서비스 | Status | Owner | Due | Amount | 총점 | 응답시간 |
|---|---|---|---|---|---|---|
| ChatGPT | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 4초 |
| Claude | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 57초 |
| Perplexity | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 12초 |
| Gemini | 25/25 | 25/25 | 25/25 | 24/25 | 99/100 | 6초 |
Gemini의 유일한 감점: 완료 뒤 RETRACT된 과거 금액 수정
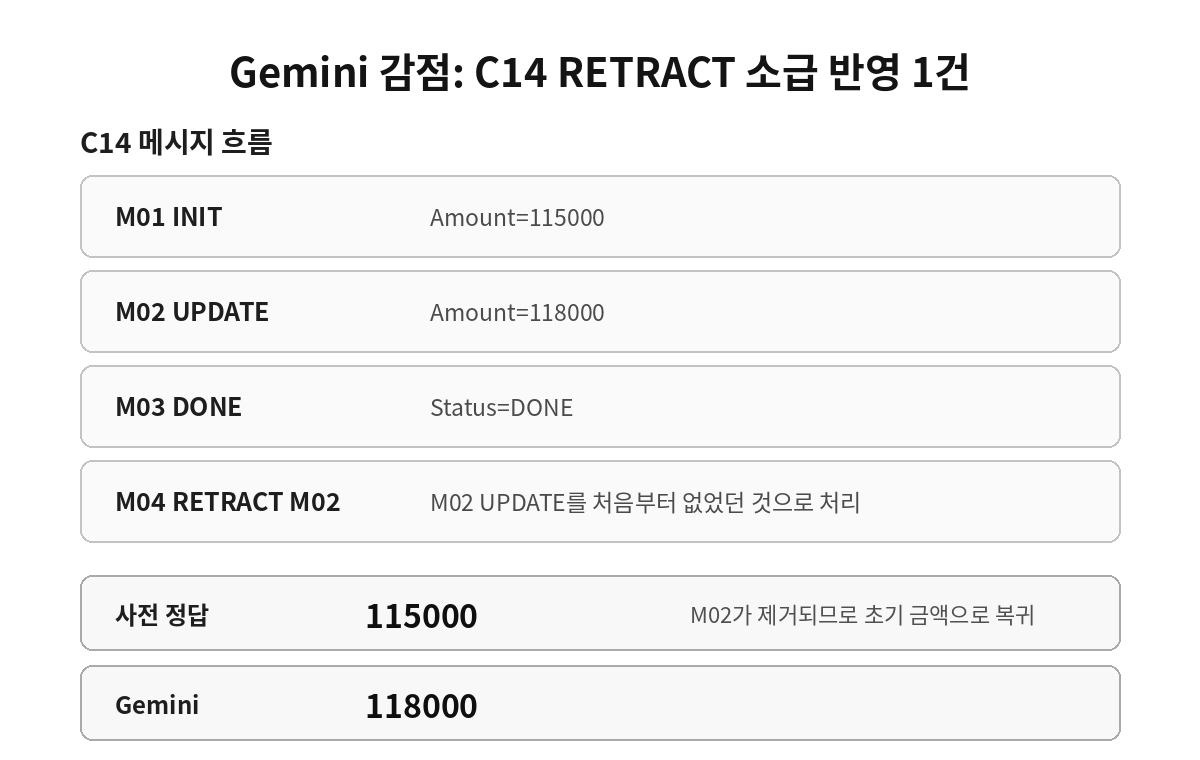
Gemini의 감점은 C14의 FinalAmount 한 곳이었습니다. C14는 처음 115000원으로 시작한 뒤 M02에서 118000원으로 바뀌고, M03에서 DONE 처리됩니다. 그다음 M04가 RETRACT M02를 보냅니다.
사전 규칙에서 RETRACT는 대상 UPDATE를 처음부터 없었던 것으로 처리합니다. 따라서 M02가 제거되면 최종 금액은 초기값인 115000원이 됩니다. Gemini는 118000원을 유지해 이 필드에서 1점을 잃었습니다.
ChatGPT·Claude·Perplexity는 25건의 최종 상태를 모두 일치시켰다
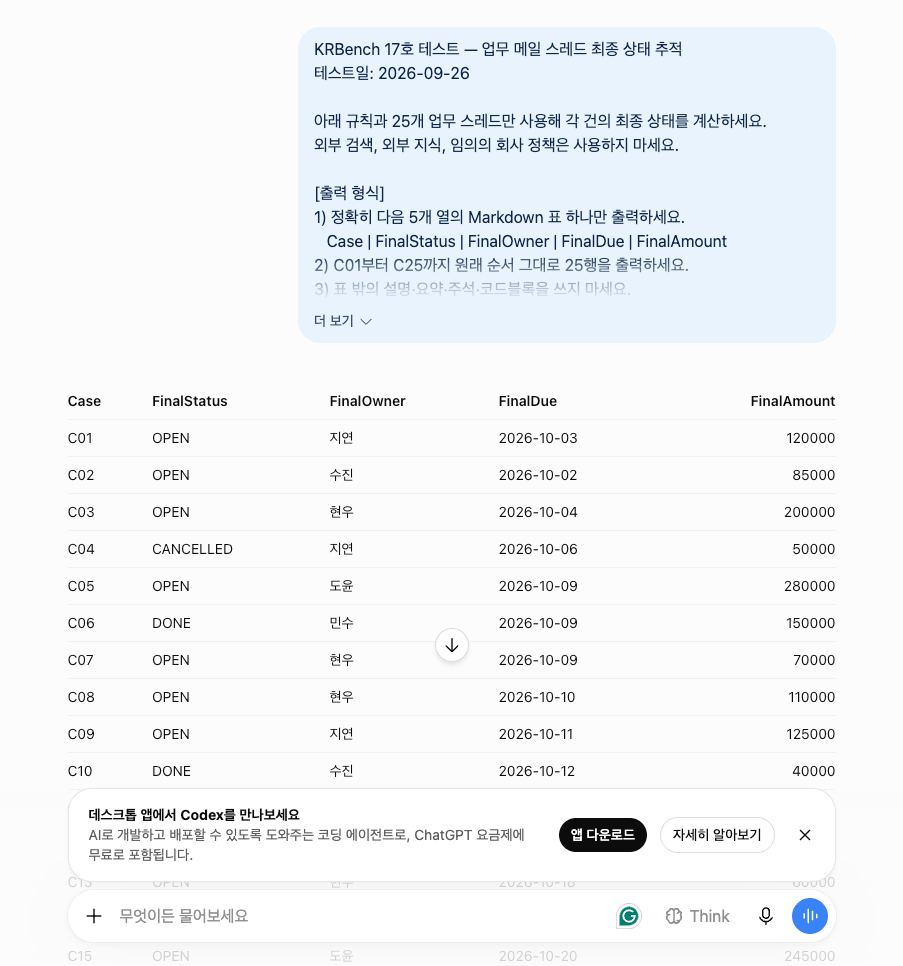
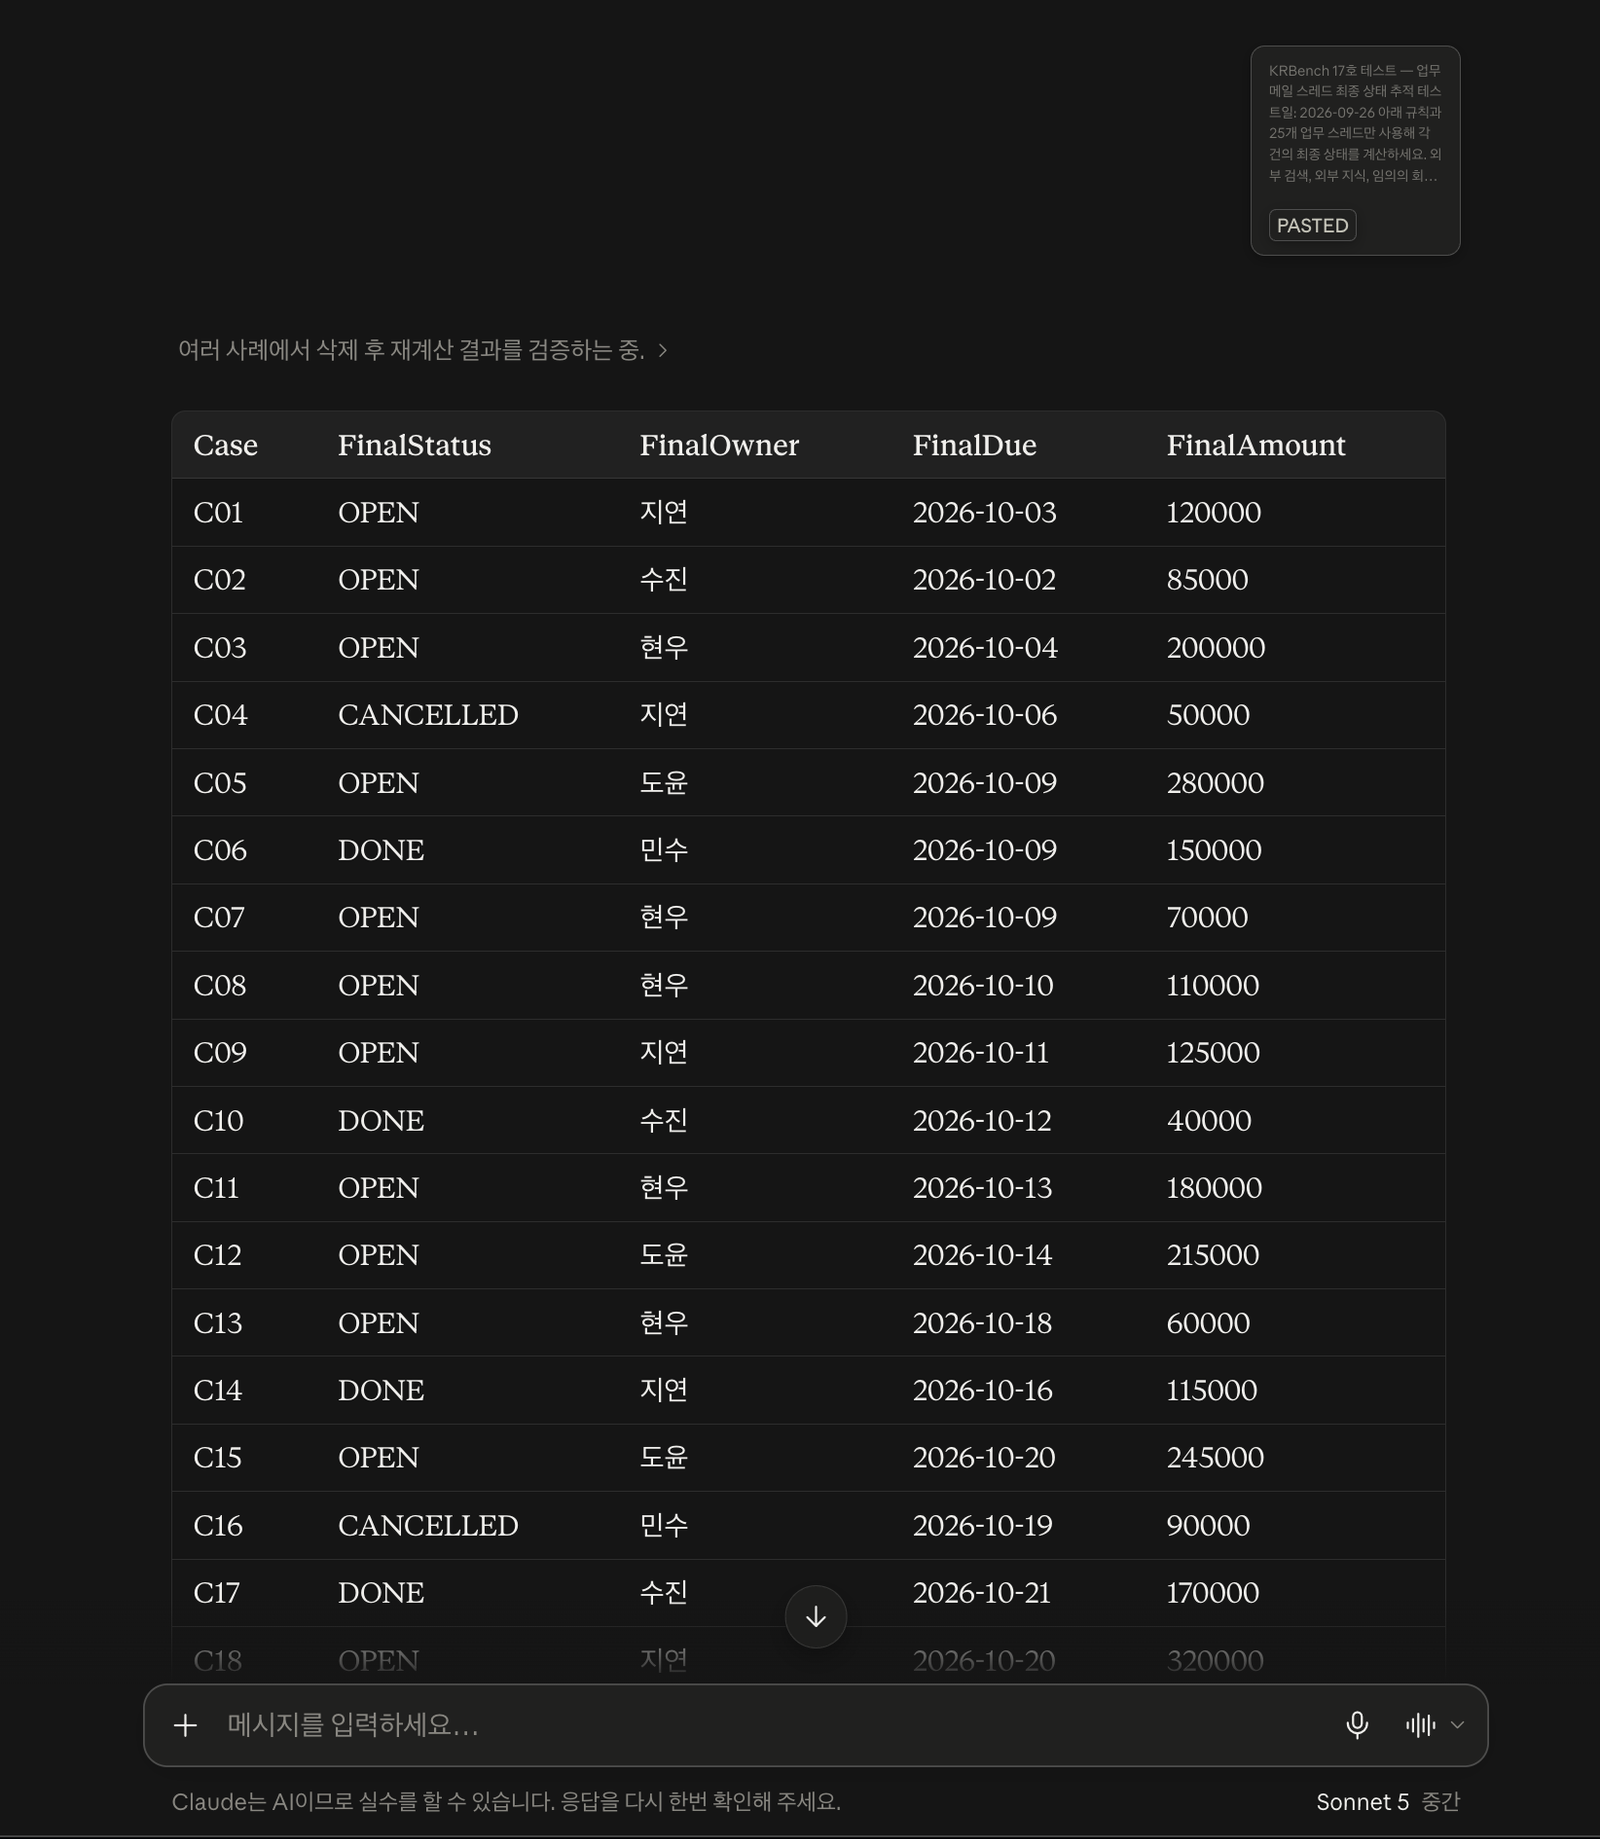
ChatGPT, Claude, Perplexity는 CANCEL 뒤 무시되는 UPDATE, REOPEN 후 새 UPDATE, DONE 뒤 변경 무시, 과거 UPDATE의 RETRACT를 포함한 25개 Case의 네 최종 필드를 모두 사전 정답과 일치시켰습니다.
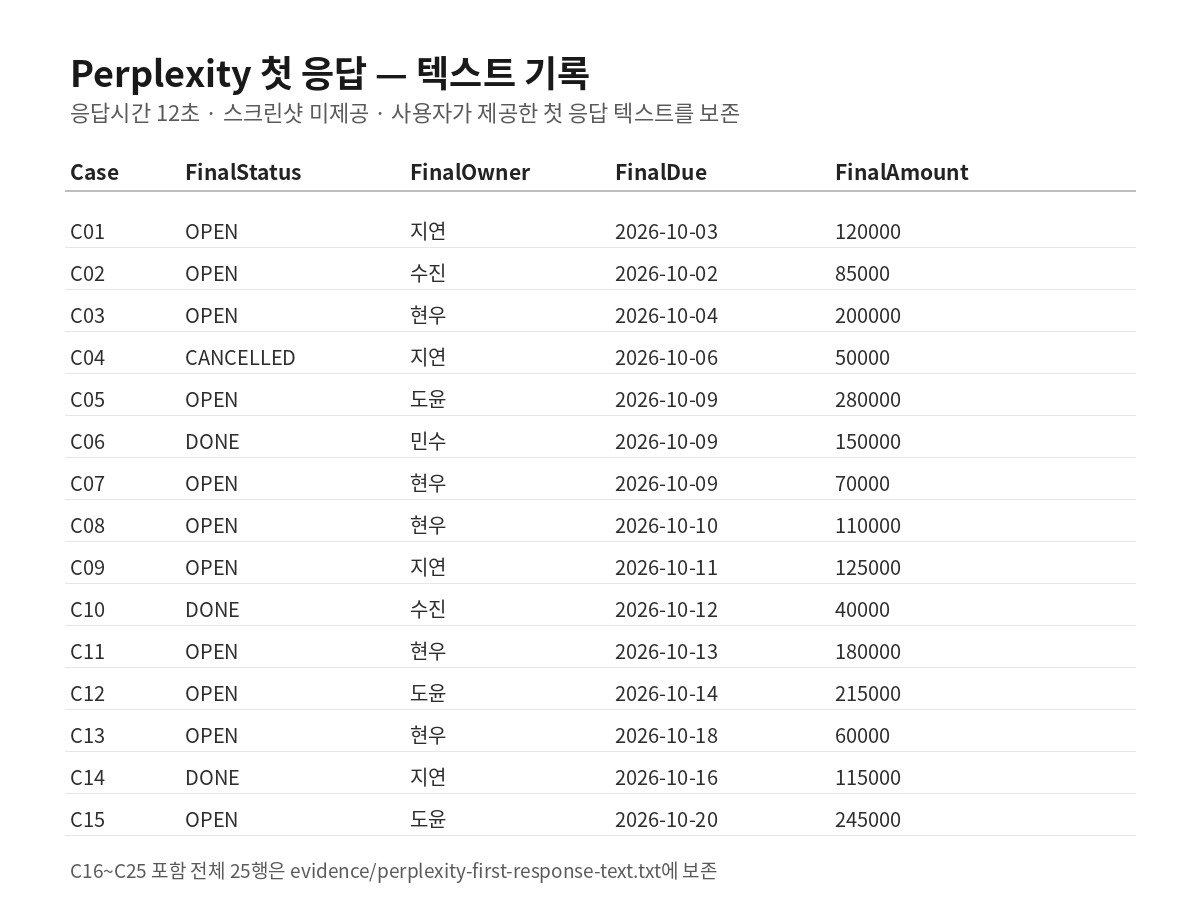
Perplexity는 이번 테스트에서 응답 스크린샷을 별도로 보존하지 못해, 사용자가 기록한 첫 응답 텍스트를 기준으로 채점하고 원문을 evidence에 보존했습니다.
NotebookLM은 이번에도 공식 비교에서 제외
NotebookLM을 제외한 이유는 성능 점수 때문이 아닙니다. 이번 테스트는 여러 소스 문서를 검색하는 작업이 아니라 하나의 긴 프롬프트 안에서 순차적인 상태 변화를 끝까지 계산하는 방식입니다.
다른 네 서비스는 같은 텍스트를 일반 채팅 입력창에 그대로 붙여넣을 수 있지만 NotebookLM은 별도의 소스 입력 절차가 필요합니다. 동일 조건을 우선해 공식 비교 대상에서는 제외했습니다.
응답시간: 4초부터 57초
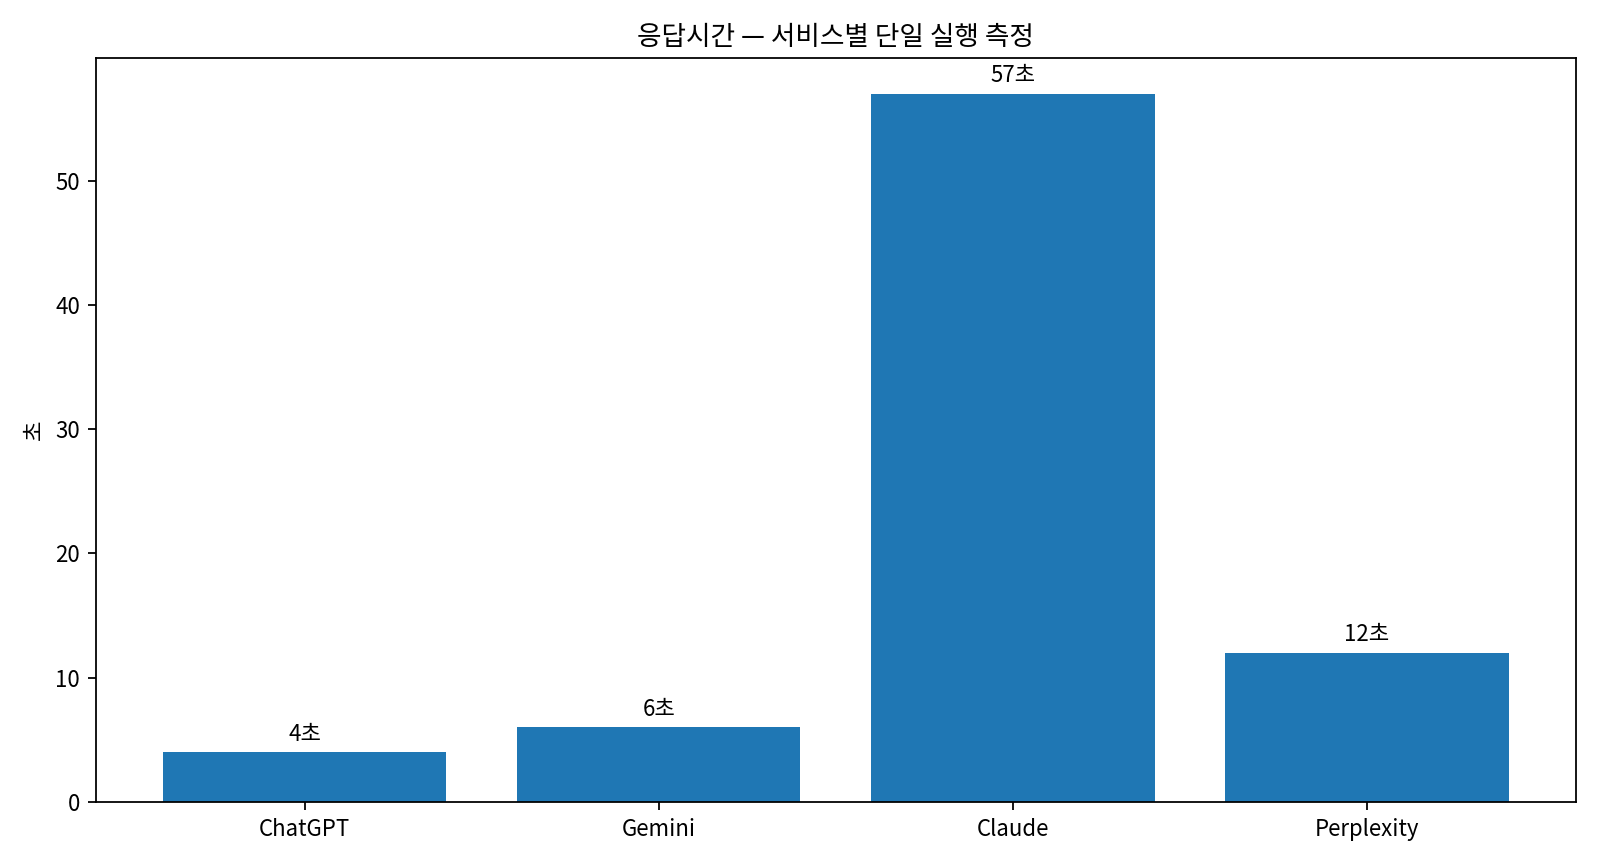
실측 응답시간은 ChatGPT 4초, Gemini 6초, Perplexity 12초, Claude 57초였습니다. 각 서비스에서 한 번만 측정한 값이므로 일반적인 속도 순위로 확대해서 해석하지 않았습니다.
이번 테스트에서 확인된 점
이번 조건에서는 네 서비스 모두 업무 스레드의 상태 추적을 매우 높은 정확도로 처리했습니다. 점수 범위는 1점에 불과했습니다. 따라서 이 테스트 결과만으로 서비스 간 큰 성능 격차가 있다고 해석하기는 어렵습니다.
다만 C14 사례처럼 이미 완료된 업무에 대해 과거의 UPDATE를 소급해서 무효화해야 하는 경우에는, 현재 상태만 유지하는 것과 전체 이력을 다시 계산하는 것이 다른 결과를 만들 수 있었습니다.
이번 테스트의 한계
- 실제 기업 메일이 아니라 KRBench가 만든 합성 업무 스레드입니다.
- 25개 Case와 네 개 최종 필드만 사용했습니다.
- RETRACT는 UPDATE만 대상으로 하는 명시적 규칙으로 단순화했습니다.
- 동시 발송, 타임존, 부분 승인, 여러 수신자의 상충 지시 같은 현실 업무의 모호성은 포함하지 않았습니다.
- NotebookLM은 입력 경로가 달라 공식 비교에서 제외했습니다.
- Perplexity는 이번 실행에서 스크린샷 대신 사용자가 기록한 첫 응답 텍스트를 증거로 보존했습니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
관련 KRBench 테스트
중복·참조·금액·날짜 오류가 겹친 주문 데이터를 AI가 정확히 감사할까?
25개 주문에서 대표 오류, 예상 청구액, 후속 조치와 다중 오류 우선순위를 100점으로 비교했습니다.
→ AI 주문 데이터 정합성 감사 정확도 비교 보기복합 한국어 지시만 주면 조건·예외·계산을 얼마나 정확히 따를까?
첨부파일 없이 25개 레코드의 Decision, Code, Result, Token을 100점으로 비교했습니다.
→ AI 지시 준수 정확도 비교 보기KRBench는 결과가 비슷하게 나오더라도 차이를 억지로 만들지 않고, 같은 조건에서 확인된 값을 그대로 기록합니다.