AI가 여러 문서를 읽고 최종 답을 맞히는 것과, 그 답이 어느 문서의 어느 근거에서 나왔는지 정확히 짚는 것은 같은 능력일까?
KRBench 11호에서는 가상의 SaaS 구매 프로젝트 자료를 PDF 6개로 나눴습니다. 요구사항 v1과 v2, 두 벤더 제안서, 보안·법무 검토, 구매위원회 최종 회의록이 서로 일부 충돌하도록 만들고, 25개 질문을 던졌습니다.
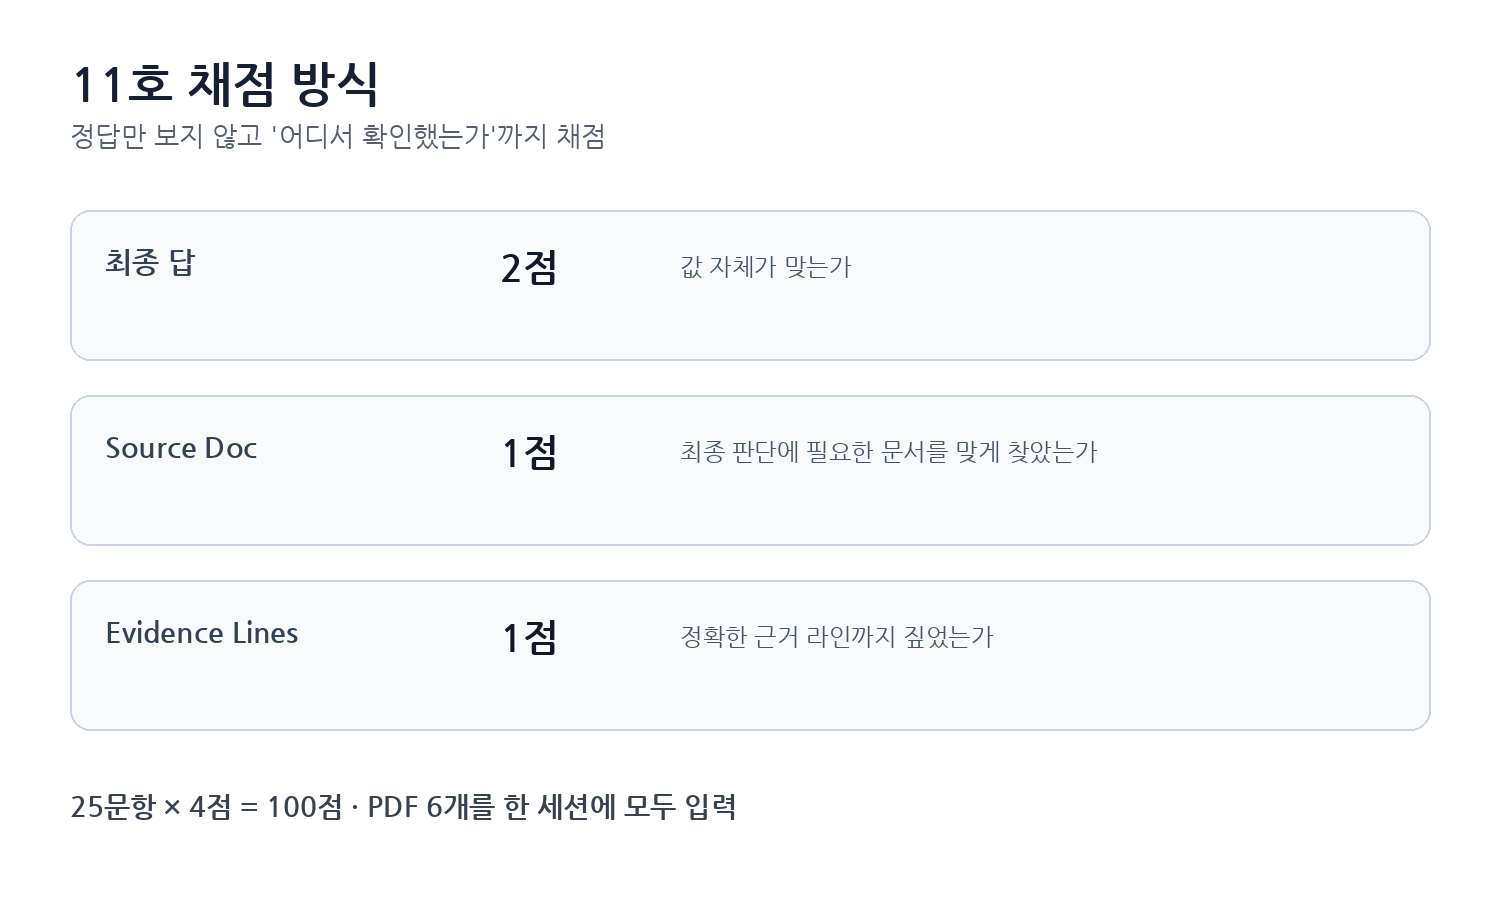
이번에는 최종 답만 맞히면 만점이 아닙니다. 최종 답 2점 + 올바른 Source Doc 1점 + 정확한 Evidence Lines 1점으로 문항당 4점, 총 100점으로 채점했습니다.
결과 요약
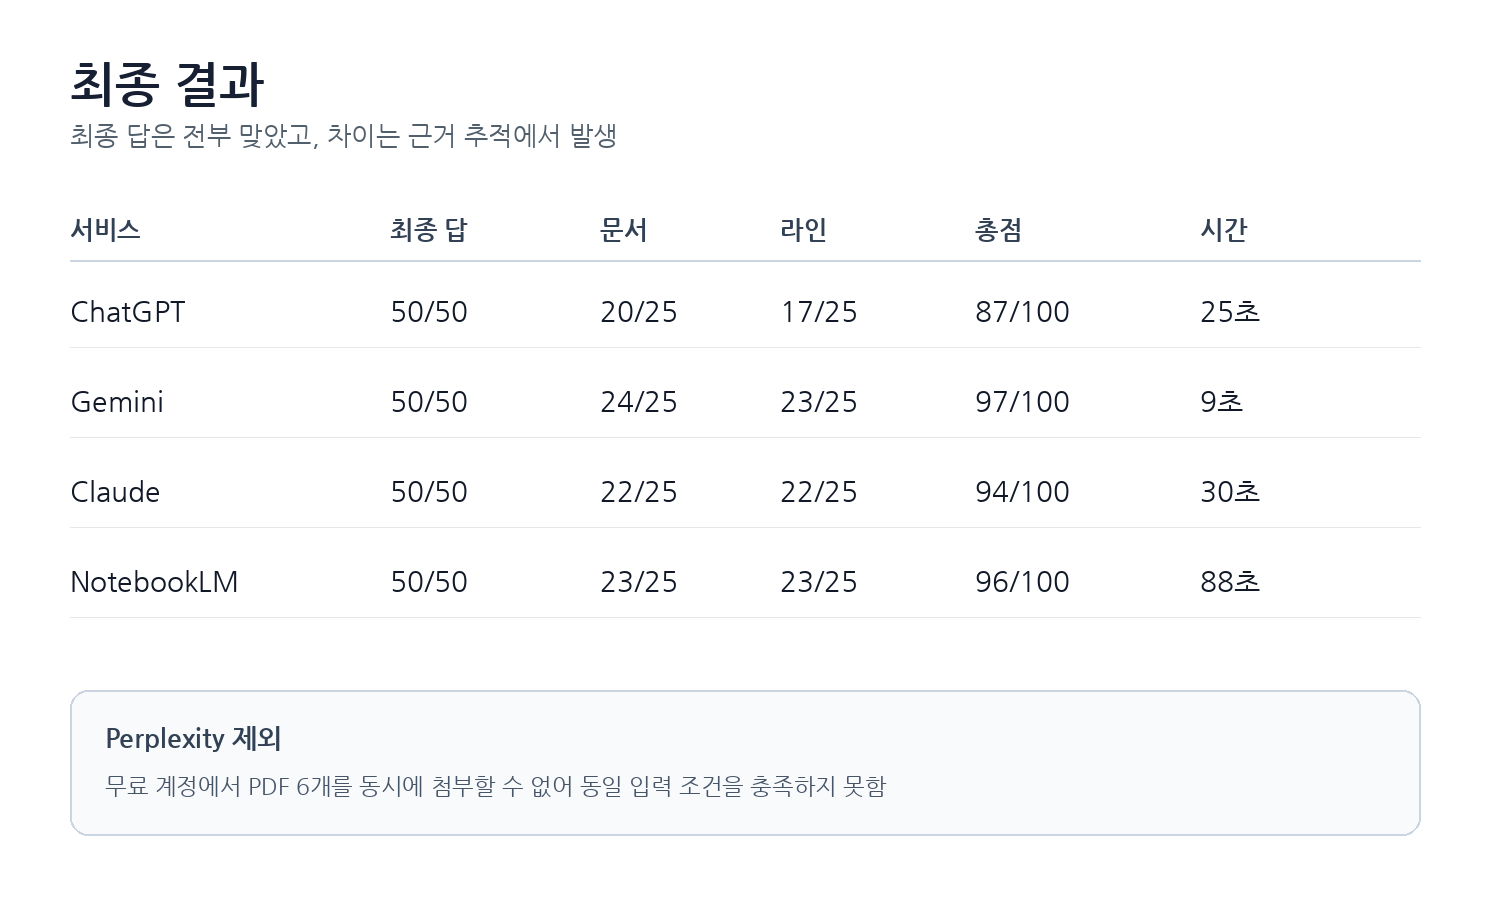
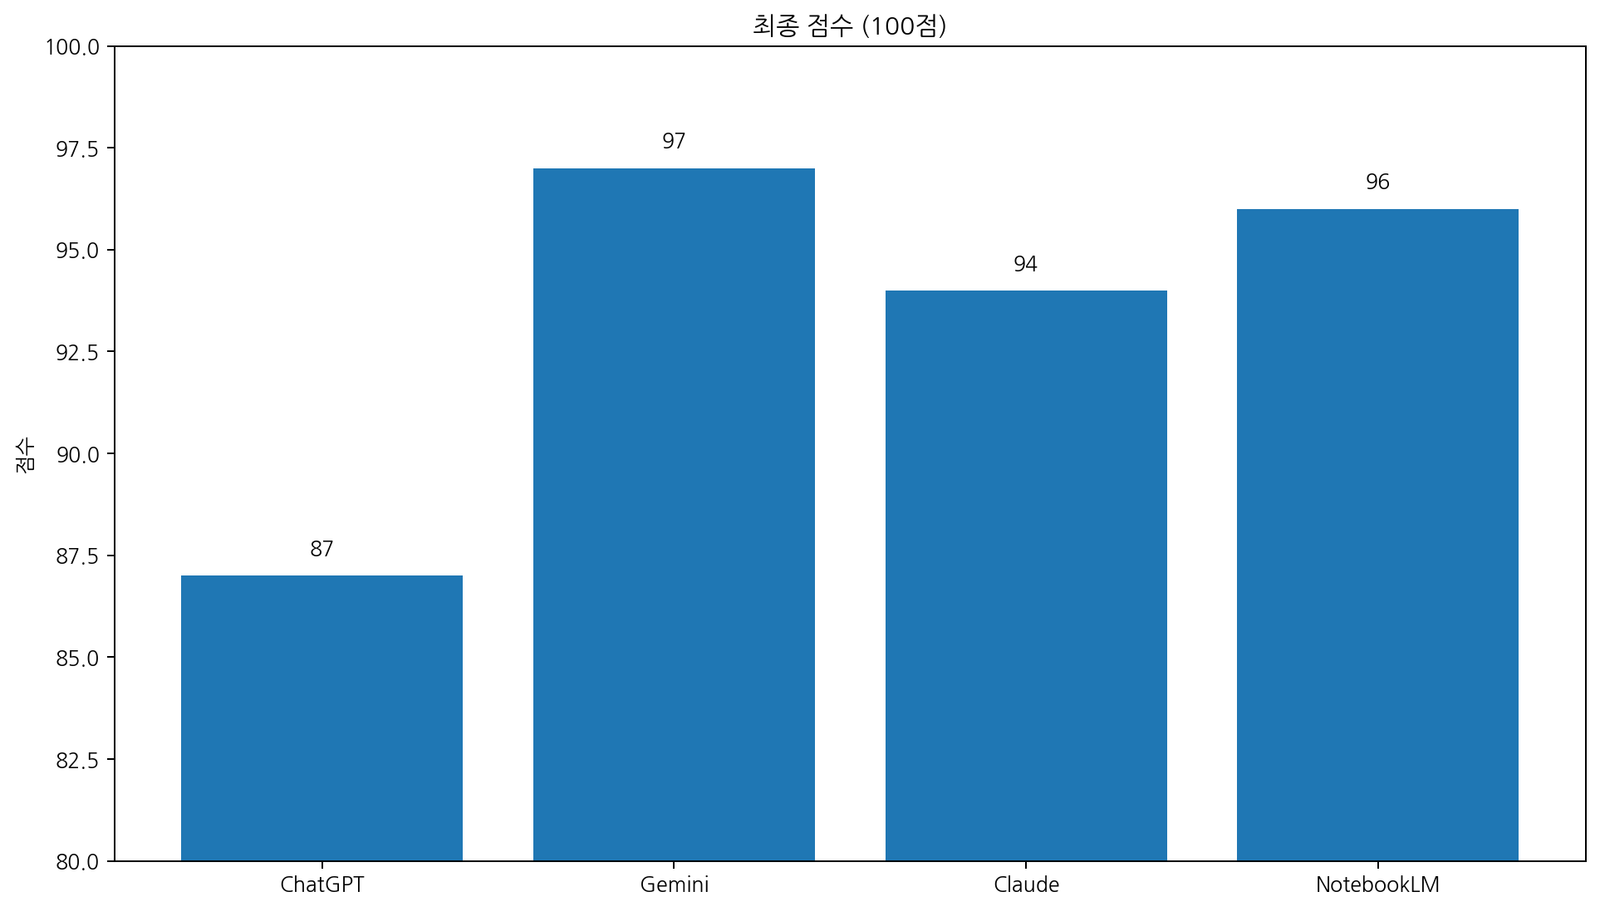
- Gemini: 97/100 · 9초
- NotebookLM: 96/100 · 88초
- Claude: 94/100 · 30초
- ChatGPT: 87/100 · 25초
- Perplexity: 무료 계정에서 PDF 6개 동시 첨부가 되지 않아 동일 조건 실행 불가로 제외
가장 흥미로운 점은 실제로 테스트한 4개 서비스 모두 최종 답 25개를 전부 맞혔다는 것입니다. 점수 차이는 전부 근거 문서와 라인 추적에서 발생했습니다.
테스트 방법: 답뿐 아니라 출처까지 4점으로 채점
| 항목 | 배점 | 판정 |
|---|---|---|
| 최종 답 | 2점 | 최종 값 자체가 맞는지 |
| Source Doc | 1점 | 최종 판단에 필요한 문서를 정확히 찾았는지 |
| Evidence Lines | 1점 | 정확한 라인 ID까지 모두 제시했는지 |
| 합계 | 4점 × 25문항 | 100점 |
문서는 모두 테스트용으로 직접 만든 가상 자료입니다. 문서마다 라인 ID를 넣어 모델이 실제로 어떤 근거를 사용했는지 확인할 수 있게 했습니다.
우선순위 규칙도 미리 고정했습니다. 같은 요구사항은 v2가 v1보다 우선하고, 보안·법무 검증은 벤더 제안보다 우선하며, 구매위원회 최종 회의록이 명시적으로 확정한 값은 이전 문서를 덮어쓰도록 했습니다.
최종 점수: 87점부터 97점
| 서비스 | 최종 답 | Source Doc | Evidence Lines | 총점 | 응답시간 |
|---|---|---|---|---|---|
| ChatGPT | 50/50 | 20/25 | 17/25 | 87/100 | 25초 |
| Gemini | 50/50 | 24/25 | 23/25 | 97/100 | 9초 |
| Claude | 50/50 | 22/25 | 22/25 | 94/100 | 30초 |
| NotebookLM | 50/50 | 23/25 | 23/25 | 96/100 | 88초 |
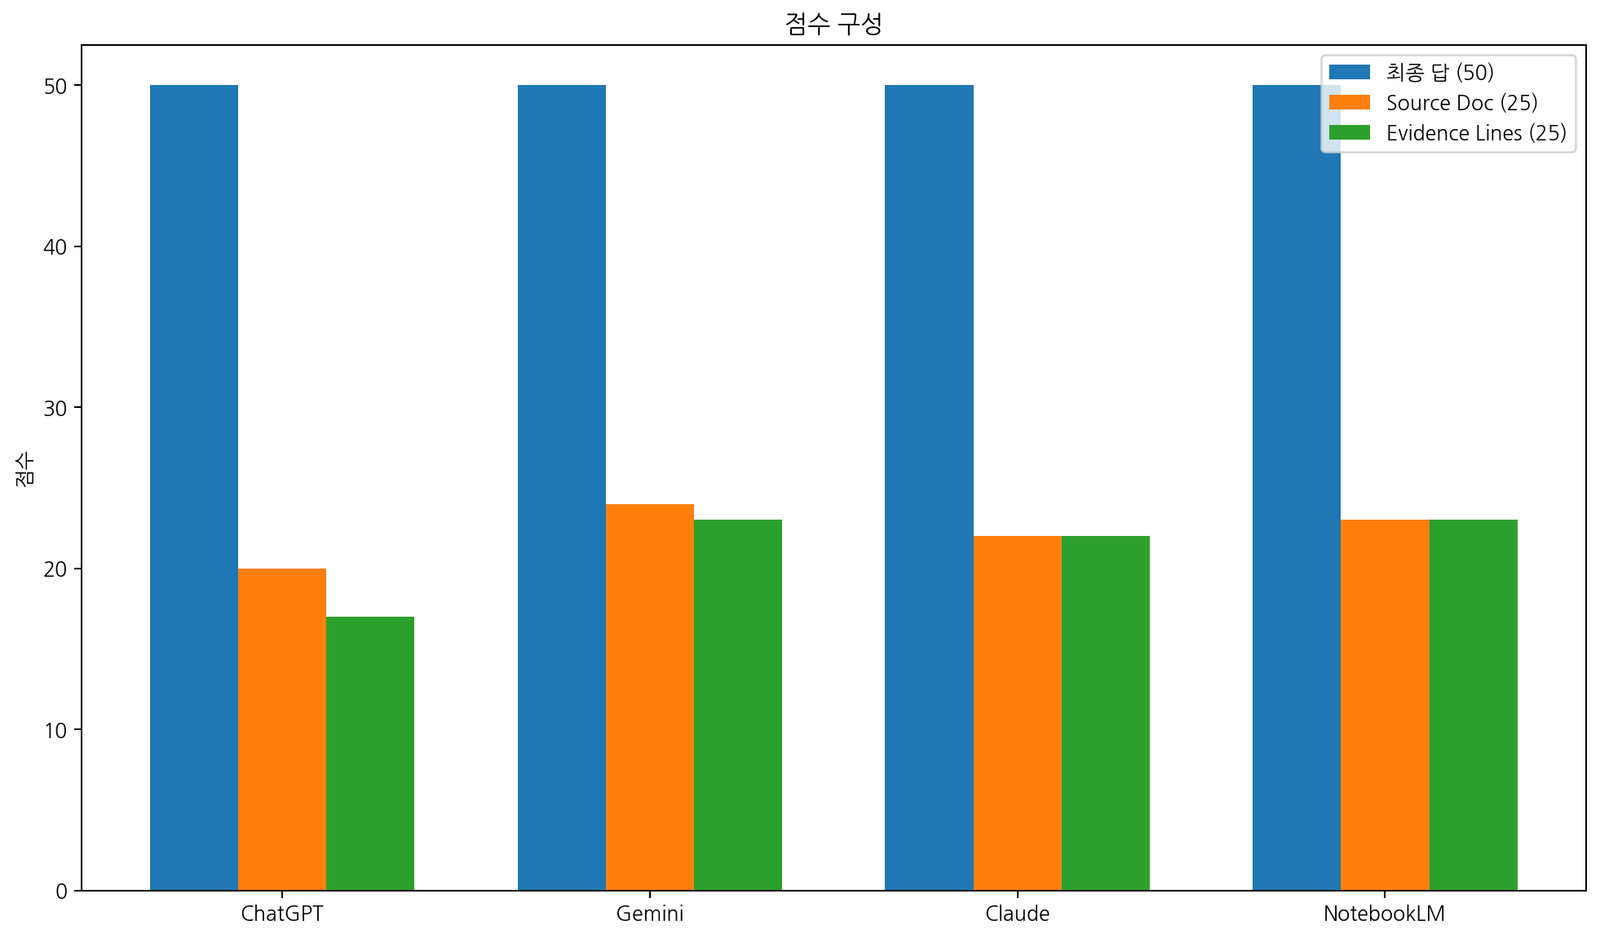
최종 답은 네 서비스 모두 25개 전부 맞혔다
25개 질문에는 단순 조회만 들어간 것이 아닙니다. 최신 요구사항과 최종 회의록을 구분해야 하는 항목, 벤더 제안과 보안 검증이 충돌하는 항목, 문서에 없는 값을 추측하지 말아야 하는 항목, 최종값이 아직 정해지지 않은 항목도 포함했습니다.
또 라이선스 좌석, 할인율, 구축비, 지원 옵션, 한국 리전, 감사 로그, 마이그레이션 크레딧을 합쳐 84,360,000원을 계산하고, 예산 상한 85,000,000원에서 이를 빼 640,000원의 여유액을 구하는 문제도 넣었습니다.
그럼에도 ChatGPT, Gemini, Claude, NotebookLM 모두 최종 답 50/50을 기록했습니다. 이번 테스트에서 차이를 만든 것은 정답 자체가 아니라 근거 추적이었습니다.
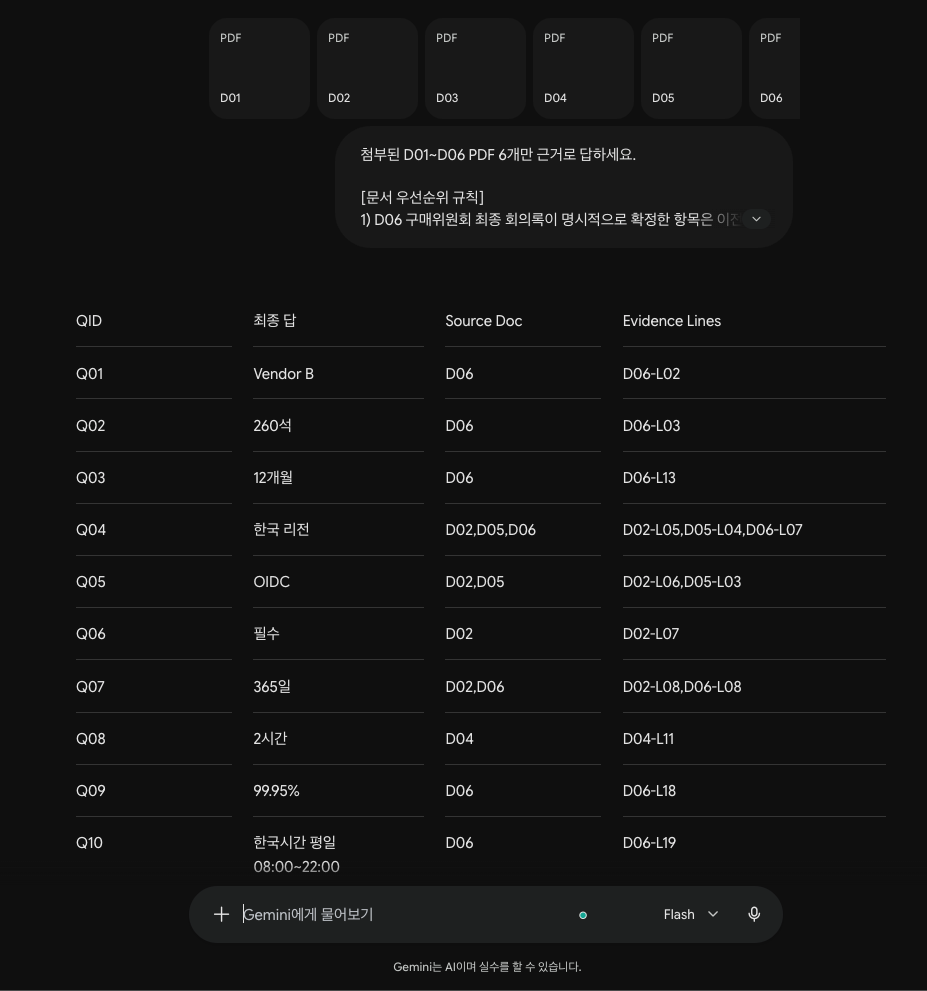
Gemini는 근거 추적 47/50으로 가장 적게 놓쳤다
Gemini는 최종 답 50점에 Source Doc 24점, Evidence Lines 23점을 받아 총 97점을 기록했습니다.
감점은 Q08의 RTO 2시간에서 최종 선정 Vendor B와 연결되는 D06 근거를 빠뜨린 것, Q22의 사고 통지 기한 미확정에서 D06-L29를 빠뜨린 것이었습니다.
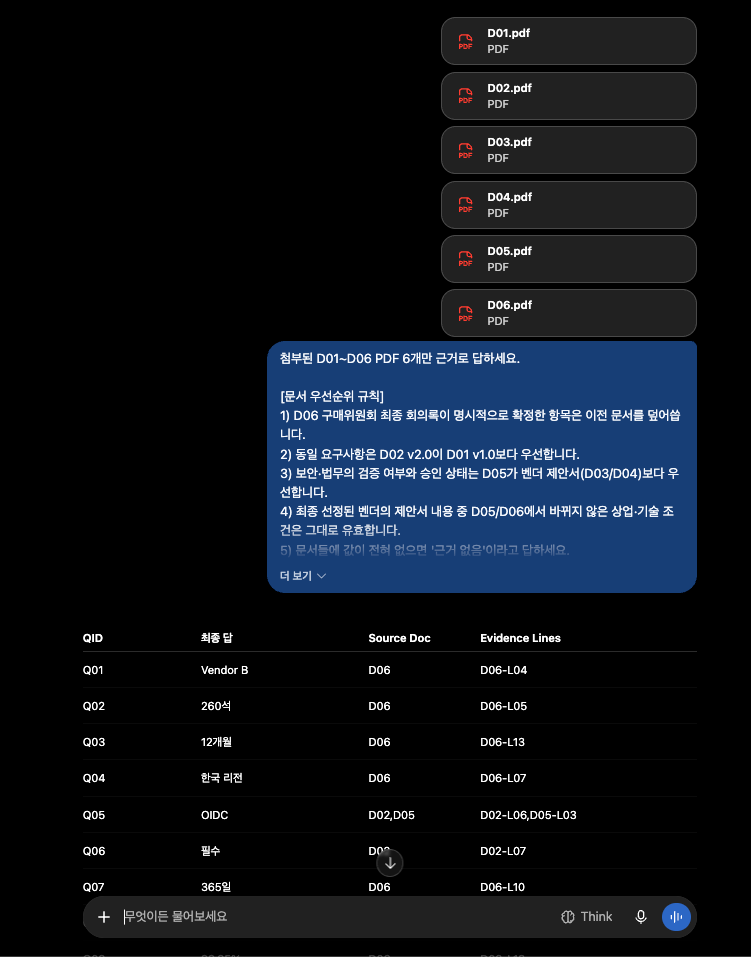
ChatGPT는 정답은 모두 맞았지만 라인 인용에서 더 많이 흔들렸다
ChatGPT도 25개 최종 답은 전부 맞았습니다. 그러나 Source Doc은 20/25, Evidence Lines는 17/25였습니다.
예를 들어 Q01에서 최종 벤더를 Vendor B라고 정확히 답했지만, 최종 선정 근거인 D06-L02 대신 할인 조건이 적힌 D06-L04를 인용했습니다. Q02의 260석도 정답이었지만 D06-L03 대신 구축비가 적힌 D06-L05를 근거로 제시했습니다.
Q24의 최종 현금 지출액 84,360,000원 역시 계산값은 정확했지만, 260석을 확정한 D06-L03이 Evidence Lines에서 빠졌습니다.
네 서비스가 모두 놓친 공통 근거 체인: Q08
Q08은 최종 선정 벤더의 계약 RTO를 묻는 문제였습니다. 정답은 2시간입니다.
2시간이라는 기술 조건은 Vendor B 제안서의 D04-L11에 있습니다. 하지만 이 값을 최종 답으로 쓰려면 구매위원회가 Vendor B를 최종 선정했다는 D06-L02까지 연결해야 합니다.
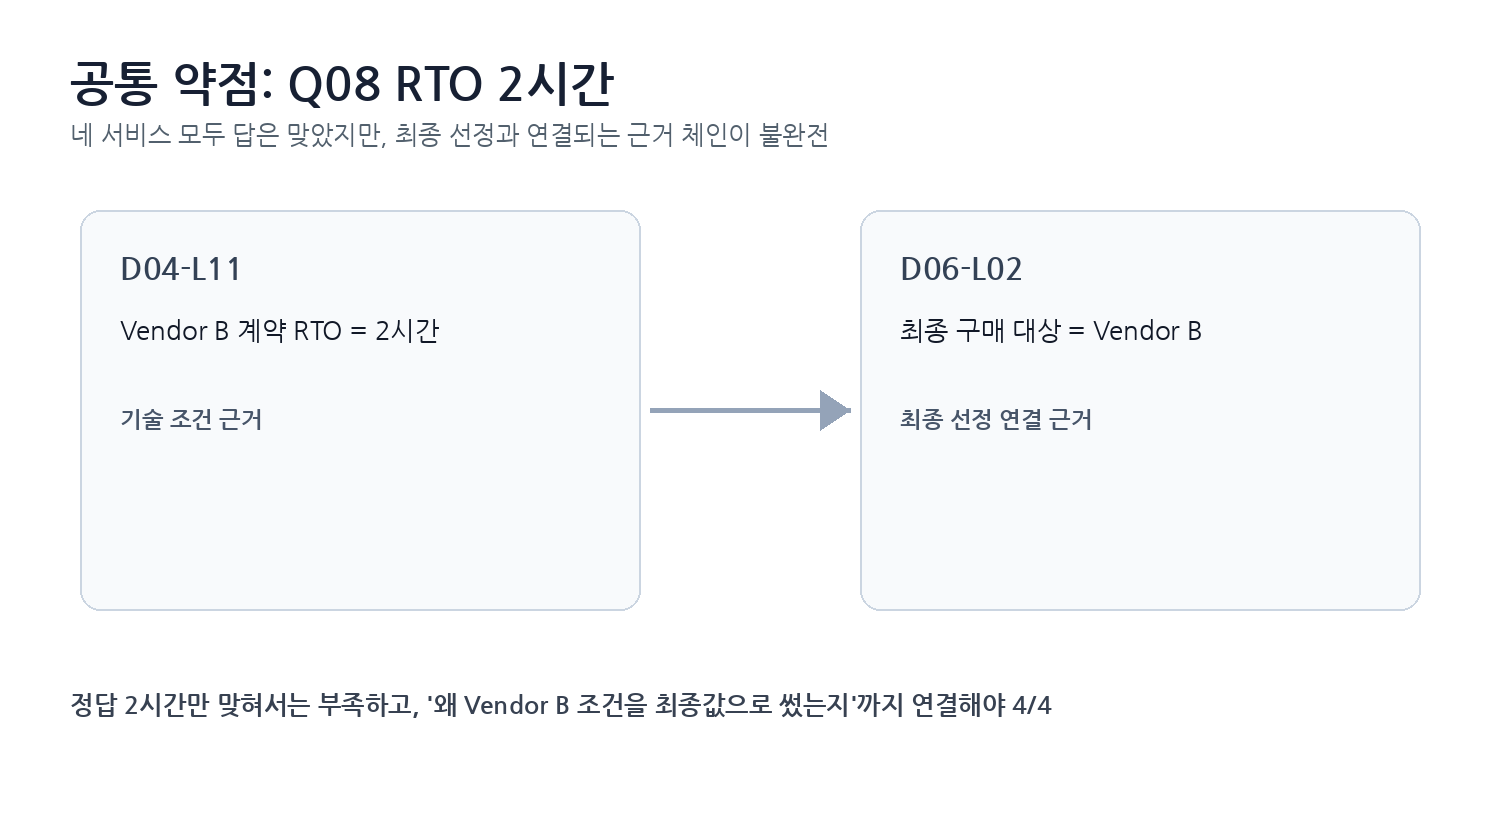
네 서비스 모두 2시간이라는 답은 정확했지만, Source Doc/Evidence Lines에서 이 두 문서를 완전하게 연결하지 못했습니다. 문서 안에서 값을 찾는 것보다, 여러 문서의 논리적 연결을 명시적으로 인용하는 것이 더 어려웠던 사례입니다.
Perplexity는 무료 계정의 첨부 제한 때문에 제외
이번 테스트의 필수 입력 조건은 D01~D06 PDF 6개를 같은 세션에 동시에 제공하는 것이었습니다.
무료 Perplexity 계정에서는 PDF 6개를 한 번에 첨부할 수 없어 동일 조건을 충족하지 못했습니다. PDF를 하나로 병합하거나 파일 수를 줄이는 방식은 다른 서비스와 입력 조건을 바꾸게 되므로 사용하지 않았습니다.
따라서 이번 11호에서 Perplexity는 성능 점수를 매기지 않고 ‘동일 조건 실행 불가’로 제외했습니다.
응답시간: 9초부터 88초
- Gemini: 9초
- ChatGPT: 25초
- Claude: 30초
- NotebookLM: 88초
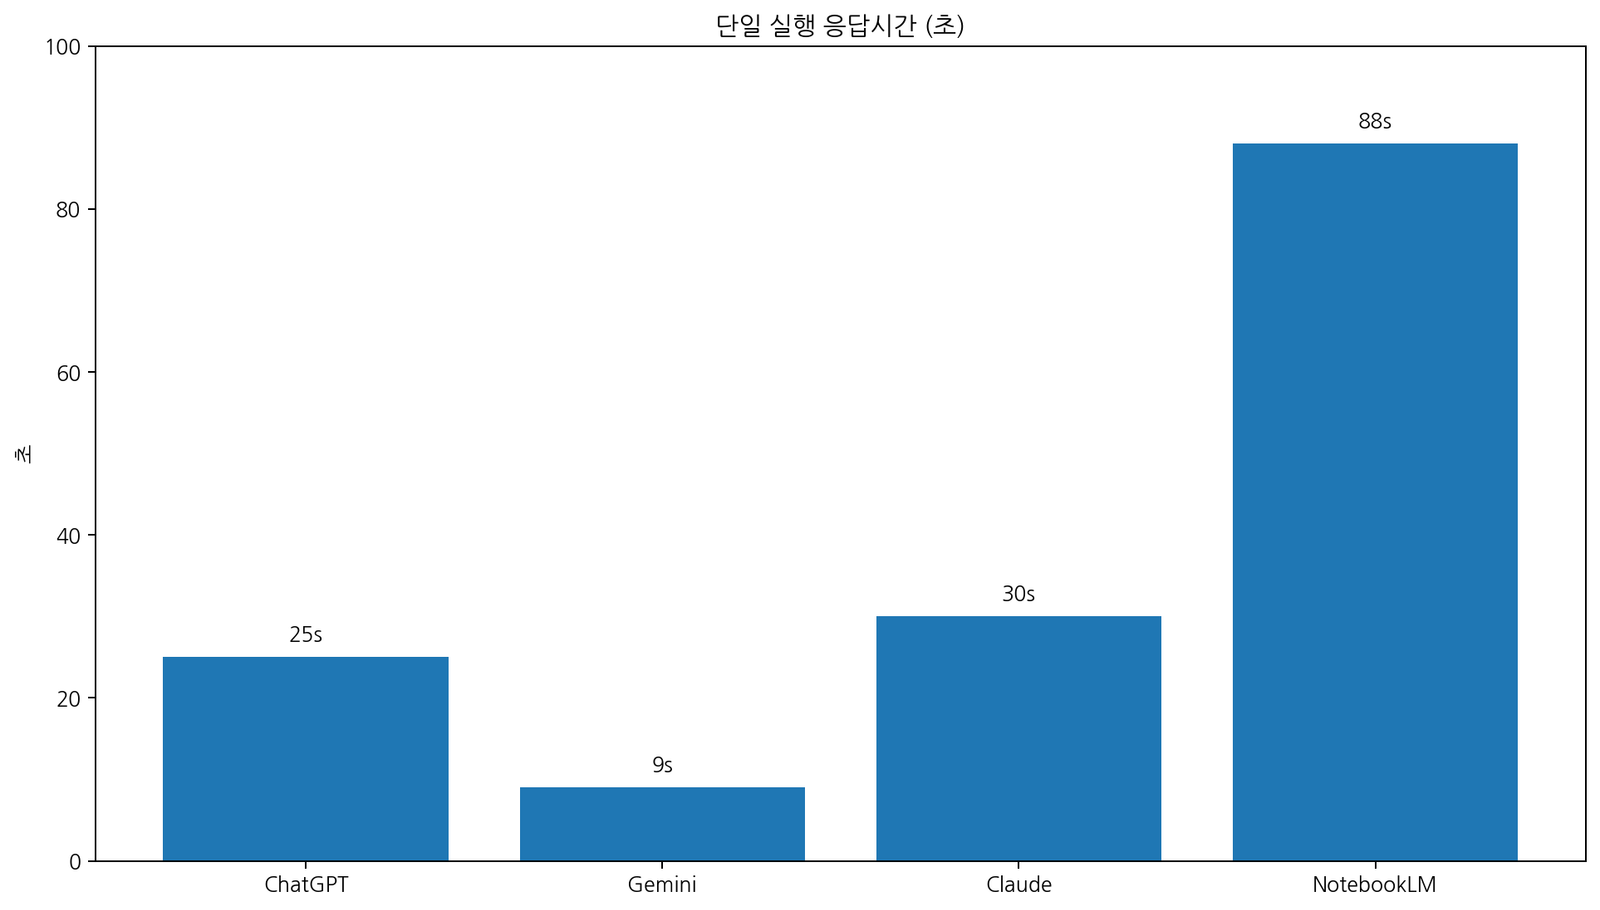
응답시간은 각 서비스에서 한 번만 측정한 값입니다. 서버 상태, 계정 환경, 모델 처리 과정에 따라 달라질 수 있으므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
이번 테스트에서 확인된 점
이번 조건에서는 네 서비스 모두 여러 문서의 내용을 종합해 최종 결론 자체를 도출하는 능력은 매우 높았습니다.
하지만 근거 문서와 라인까지 엄격하게 요구하자 차이가 나타났습니다. 특히 “Vendor B의 RTO가 2시간”처럼 단일 문서에서 값을 찾는 것과, “왜 Vendor B의 그 값이 최종 계약 조건인지”를 최종 선정 문서까지 연결해 제시하는 것은 다른 문제였습니다.
따라서 규정 검토, 계약 비교, 감사 대응처럼 정답뿐 아니라 출처 추적이 중요한 업무에서는 결과값만 확인하는 것보다 근거 인용까지 함께 검증하는 편이 안전합니다.
이번 테스트의 한계
- 실제 기업 문서가 아니라 KRBench가 만든 가상 SaaS 구매 자료입니다.
- PDF 6개는 텍스트가 명확한 디지털 문서이며 스캔 품질 문제는 포함하지 않았습니다.
- 라인 ID를 미리 넣었기 때문에 실제 문서보다 정확한 근거 인용이 쉬운 측면이 있습니다.
- 25개 질문은 하나의 프로젝트 자료 안에서 만들어져 완전히 독립적인 25개 업무는 아닙니다.
- Source Doc과 Evidence Lines는 KRBench가 사전에 정한 authoritative evidence 기준으로 채점했습니다.
- 응답시간은 서비스별 1회 측정값입니다.
- Perplexity는 무료 계정의 첨부 제한 때문에 동일 조건으로 실행하지 못했습니다.
관련 KRBench 테스트
복잡하게 정정되는 회의록의 최종 상태를 얼마나 정확히 정리할까?
담당자·마감일·상태·계산형 최종값 100개 필드로 5개 AI 서비스를 비교했습니다.
→ AI 회의록 정확도 비교 보기한 개의 한국어 PDF를 읽는 정확도는?
같은 7페이지 한국어 PDF와 10개 질문으로 정답, 환각, 근거 페이지, 응답시간을 비교했습니다.
→ 한국어 PDF AI 정확도 비교 보기AI는 개인정보만 정확히 가리고 주문번호·상품코드는 남길 수 있을까?
가상 고객 기록 25개에 개인정보 50개와 비개인 유사 문자열 25개를 넣어 ChatGPT·Gemini·Claude·NotebookLM·Perplexity를 100점 만점으로 비교했습니다.
→ AI 개인정보 비식별화 정확도 비교 보기AI는 환율·한도·영수증·제출 기한이 얽힌 출장비를 정확히 정산할까?
가상 출장비 25건에 호텔·식비·택시·중복·휴일 규칙을 함께 넣어 ChatGPT·Gemini·Claude·NotebookLM·Perplexity를 100점 만점으로 비교했습니다.
→ AI 출장비 정산 정확도 비교 보기KRBench는 정답률만 보지 않고, 실제 업무에서 필요한 근거 추적과 재현 가능성까지 같은 조건에서 확인합니다.