CSV 파일을 AI에 올리면 단순히 한 행의 값을 찾는 것뿐 아니라, 조건을 여러 개 걸어 합계를 내고 비율을 계산하거나 잘못된 데이터를 찾아낼 수 있을까?
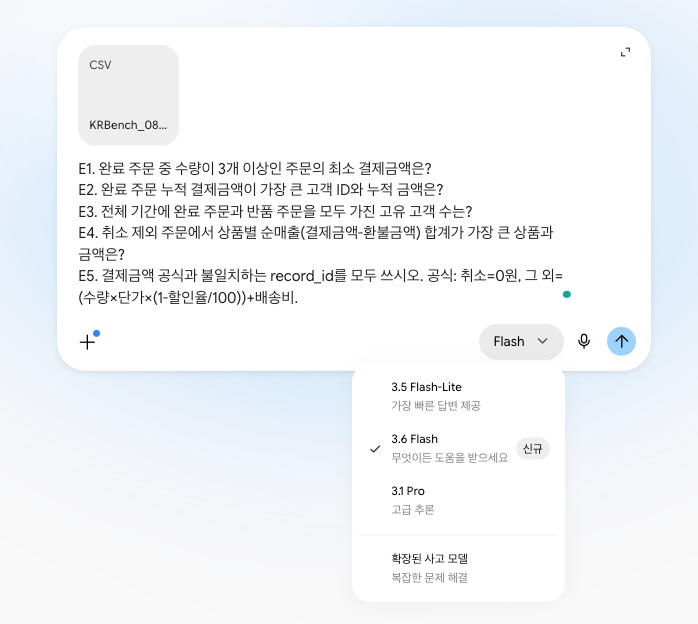
KRBench는 ChatGPT, Gemini, Claude, NotebookLM, Perplexity에 같은 한국어 이커머스 주문 CSV 1개와 같은 25개 질문을 입력했습니다. CSV는 180행·20열이며, 단순 조회부터 필터·고유 고객 수·합계·평균·반품률·순매출·수식 불일치 탐지까지 단계적으로 난도를 높였습니다.
결과 요약
- Gemini: 25/25 (100%)
- Claude: 25/25 (100%)
- NotebookLM: 25/25 (100%)
- ChatGPT: 24/25 (96%)
- Perplexity Standard(무료, 별도 계정): 6/25 (24%)
테스트 데이터와 채점 방법
테스트용 CSV는 가상의 한국 이커머스 주문 데이터 180행으로 만들었습니다. 각 행은 주문 1건이며 주문일, 고객 ID, 지역, 채널, 상품, 수량, 단가, 할인율, 쿠폰, 상태, 결제금액, 반품수량, 환불금액, 배송일수, 평점 등을 포함합니다.
| 구간 | 내용 | 문항 |
|---|---|---|
| A | 특정 record_id의 값 직접 조회 | 5 |
| B | 복수 조건 필터·카운트·고유 고객 | 5 |
| C | 합계·평균·카테고리 집계 | 5 |
| D | 월별 비교·비율·순매출 다단계 계산 | 5 |
| E | 누적 고객·교차 상태·데이터 품질 탐지 | 5 |
모든 서비스에는 같은 CSV와 같은 프롬프트를 넣었고 첫 응답만 채점했습니다. 외부 검색은 사용하지 않도록 지시했지만, 서비스 자체의 기본 데이터 분석·코드 실행 기능은 제한하지 않았습니다.
숫자가 같으면 쉼표나 ‘원·명·일·%’ 같은 통상 단위 표기 차이는 감점하지 않았습니다. 예를 들어 14.8과 14.8%는 질문에서 단위가 %로 명확한 경우 같은 값으로 처리했습니다.
최종 정확도 결과
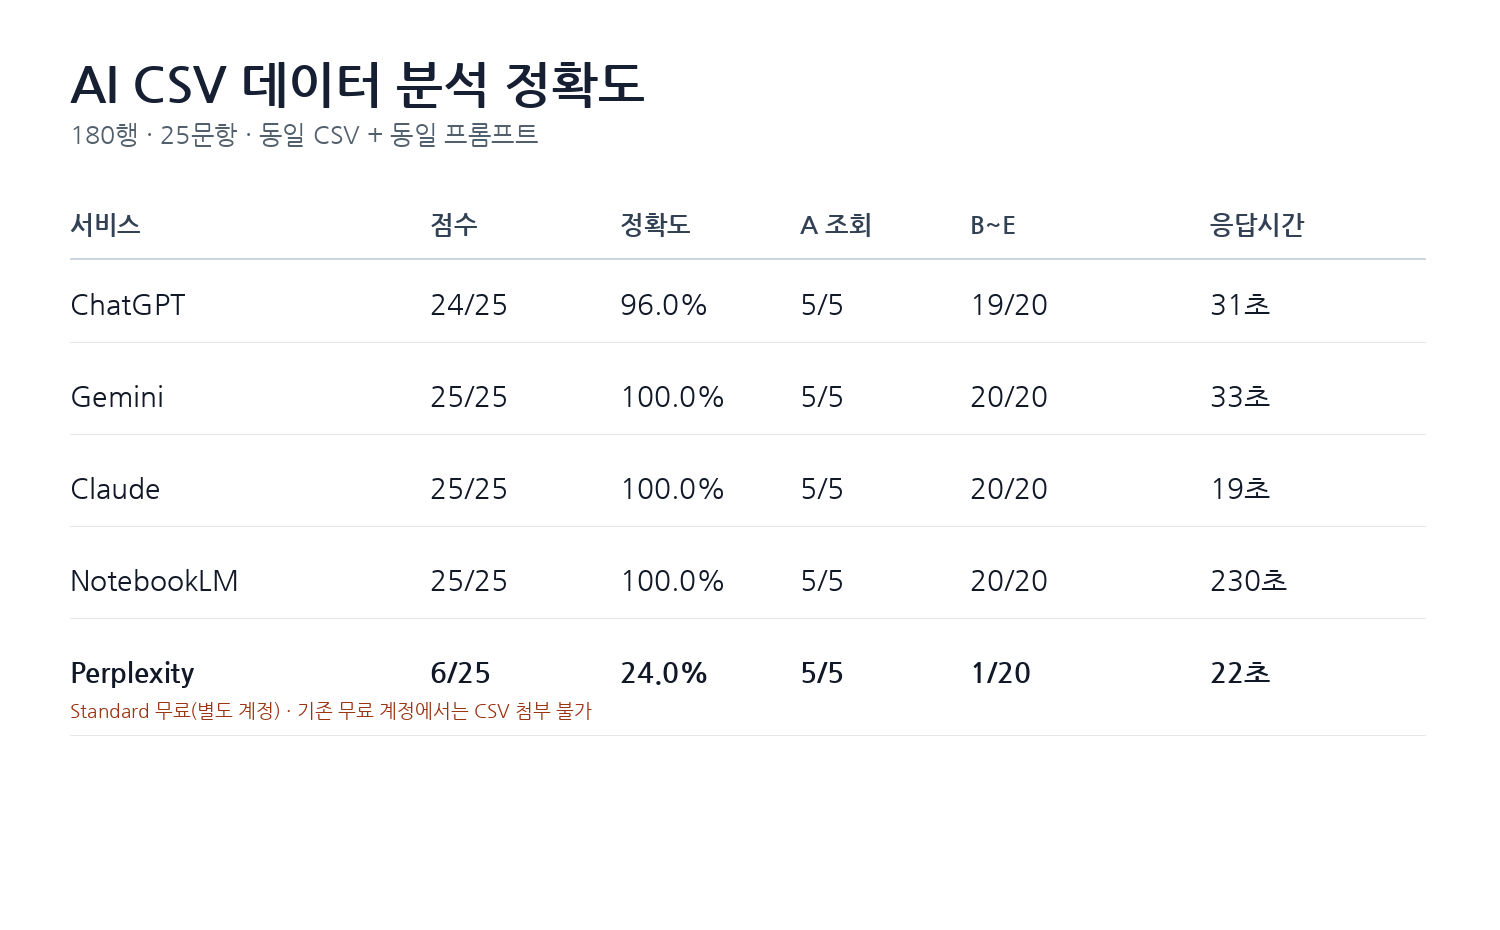
| 서비스 | 점수 | 정확도 | A 조회 | B~E | 응답시간 |
|---|---|---|---|---|---|
| ChatGPT | 24/25 | 96.0% | 5/5 | 19/20 | 31초 |
| Gemini | 25/25 | 100.0% | 5/5 | 20/20 | 33초 |
| Claude | 25/25 | 100.0% | 5/5 | 20/20 | 19초 |
| NotebookLM | 25/25 | 100.0% | 5/5 | 20/20 | 230초 |
| Perplexity Standard(무료, 별도 계정) | 6/25 | 24.0% | 5/5 | 1/20 | 22초 |
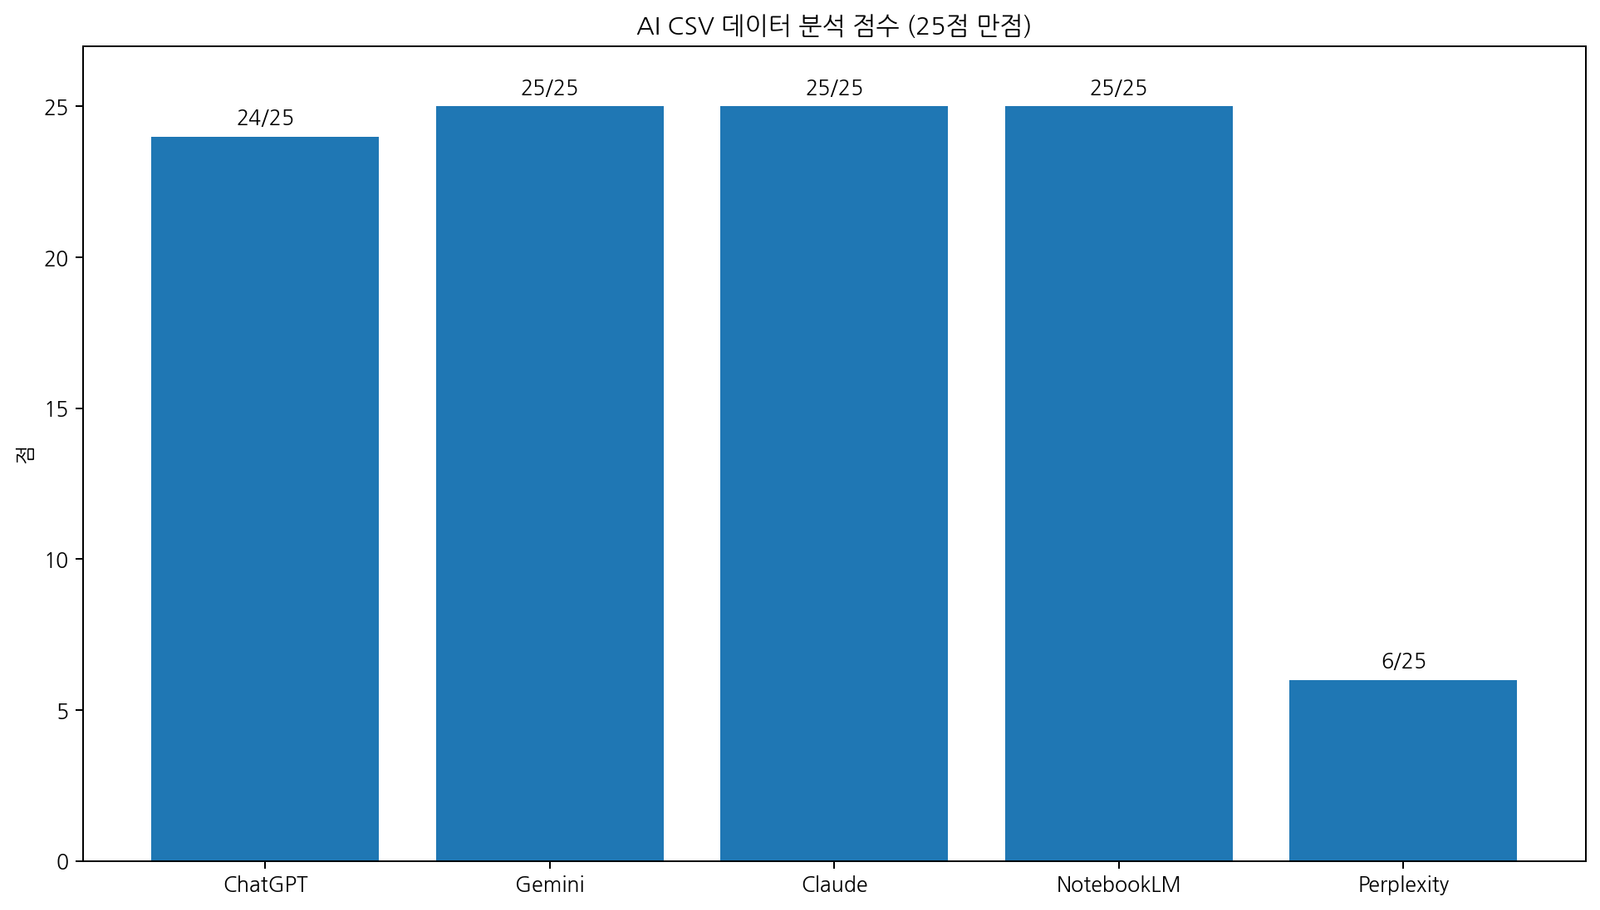
Gemini·Claude·NotebookLM은 25문항을 모두 맞혔다
Gemini, Claude, NotebookLM은 A부터 E까지 25문항을 모두 맞혔습니다. 특정 행을 읽는 문제뿐 아니라 5월 모바일 완료 주문의 고유 고객 수, 반품 주문 평균 배송일수, 부산 반품률, 상품별 순매출 같은 다단계 계산도 정답과 일치했습니다.
가장 마지막 E5에는 결제금액 공식과 일부러 맞지 않게 만든 레코드 3개를 심어두었습니다. 정답은 R0025, R0088, R0144인데 세 서비스 모두 세 개를 정확히 찾아냈습니다.
ChatGPT는 25문항 중 C4 한 문제만 틀렸다
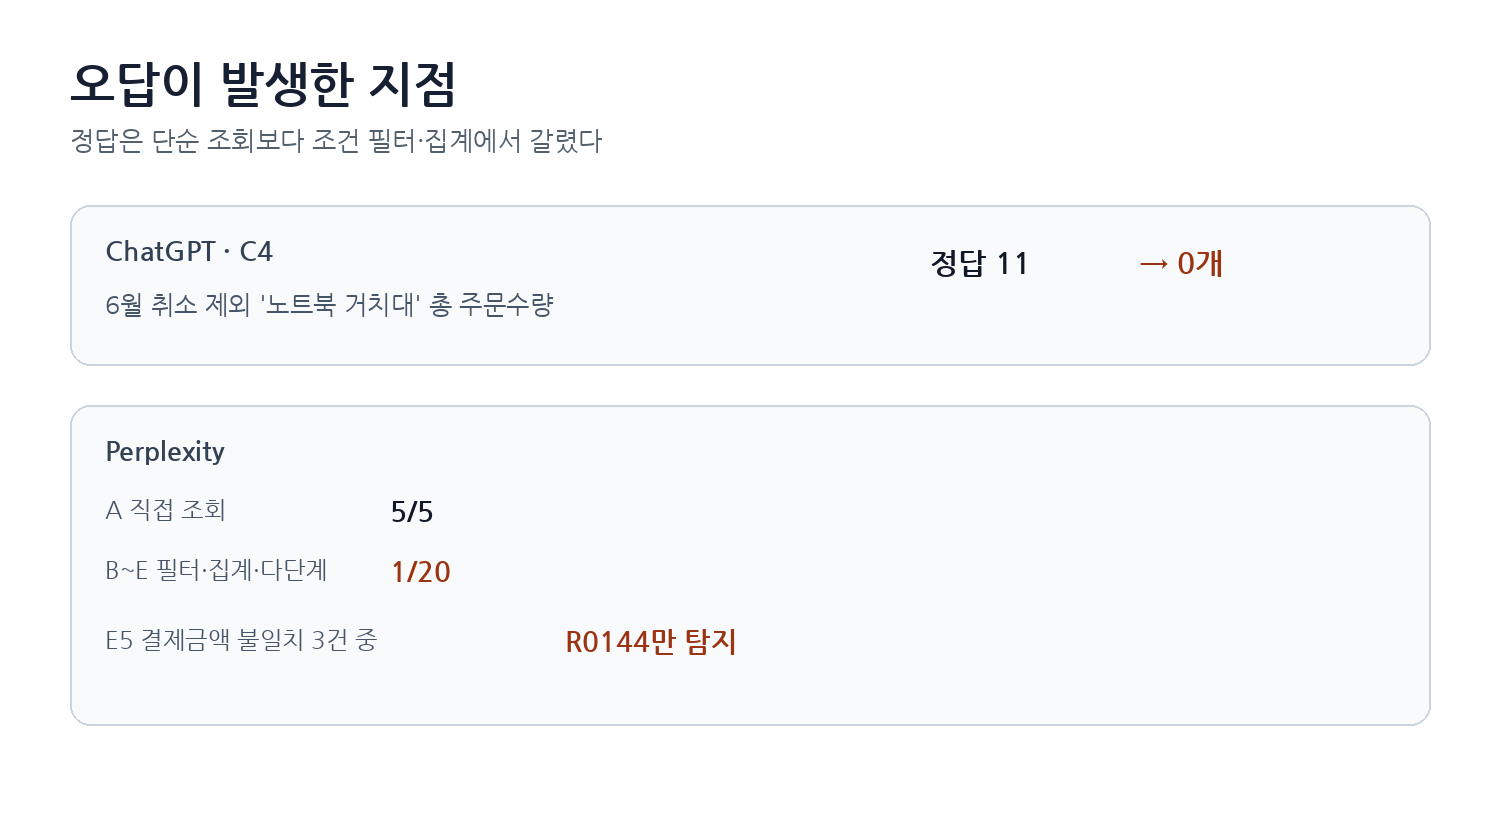
ChatGPT는 24/25를 기록했습니다. 유일한 오답은 C4였습니다.
- 질문: 6월 취소 제외 주문에서 ‘노트북 거치대’의 총 주문수량은?
- 정답: 11
- ChatGPT: 0개
그 외 고유 고객 수, 평균, 월별 최대 매출, 반품률, 순매출, 누적 구매액, 데이터 오류 3건 탐지는 모두 정확했습니다. 따라서 이번 실행에서는 단순 조회 오류가 아니라 복수 조건을 적용한 특정 상품 수량 집계 한 문항에서만 차이가 났습니다.
Perplexity는 직접 조회 5/5, 집계·계산은 1/20
Perplexity는 A 구간의 특정 record_id 직접 조회 5문항을 모두 맞혔습니다. CSV 파일 자체를 읽고 특정 행의 값을 찾는 작업은 정확했습니다.
하지만 복수 행을 필터링하거나 합계·평균·비율을 계산하는 B~E에서는 20문항 중 E1 한 문항만 맞았습니다.
- B1 완료+부산 주문 수: 정답 23 → 15
- B3 5월 모바일 완료 주문 고유 고객: 정답 13 → 26
- C1 완료 주문 중 서울 결제금액 합계: 정답 1,796,450원 → 1,982,350원
- D1 완료 주문 결제금액 최대 월: 정답 4월 3,145,050원 → 5월 2,399,850원
- D5 취소 제외 순매출: 정답 7,843,400원 → 10,067,820원
- E5 수식 불일치: 정답 R0025·R0088·R0144 → R0144만 제시
이번 한 번의 실행에서는 직접 조회와 다단계 집계·계산 사이에서 결과 차이가 크게 나타났습니다. 이 결과를 Perplexity의 모든 데이터 분석 작업으로 일반화하지 않고, 이번 CSV·프롬프트·계정 환경에서 나온 측정값으로만 기록했습니다.
Perplexity는 별도의 무료 계정에서 테스트했다
테스트에 사용하던 기존 Perplexity Standard 무료 계정에서는 이번에도 CSV 파일 첨부가 되지 않았습니다. 그래서 다른 Standard 무료 계정으로 바꾼 뒤 같은 CSV 1개와 같은 프롬프트를 입력해 첫 응답을 측정했습니다.
계정별로 파일 첨부 가능 여부가 달랐던 이유는 확인할 수 없어 추정하지 않았습니다. 따라서 결과표에는 환경 차이를 숨기지 않고 ‘Perplexity Standard(무료, 별도 계정)’으로 표시했습니다.
응답시간은 19초부터 230초까지 차이가 났다
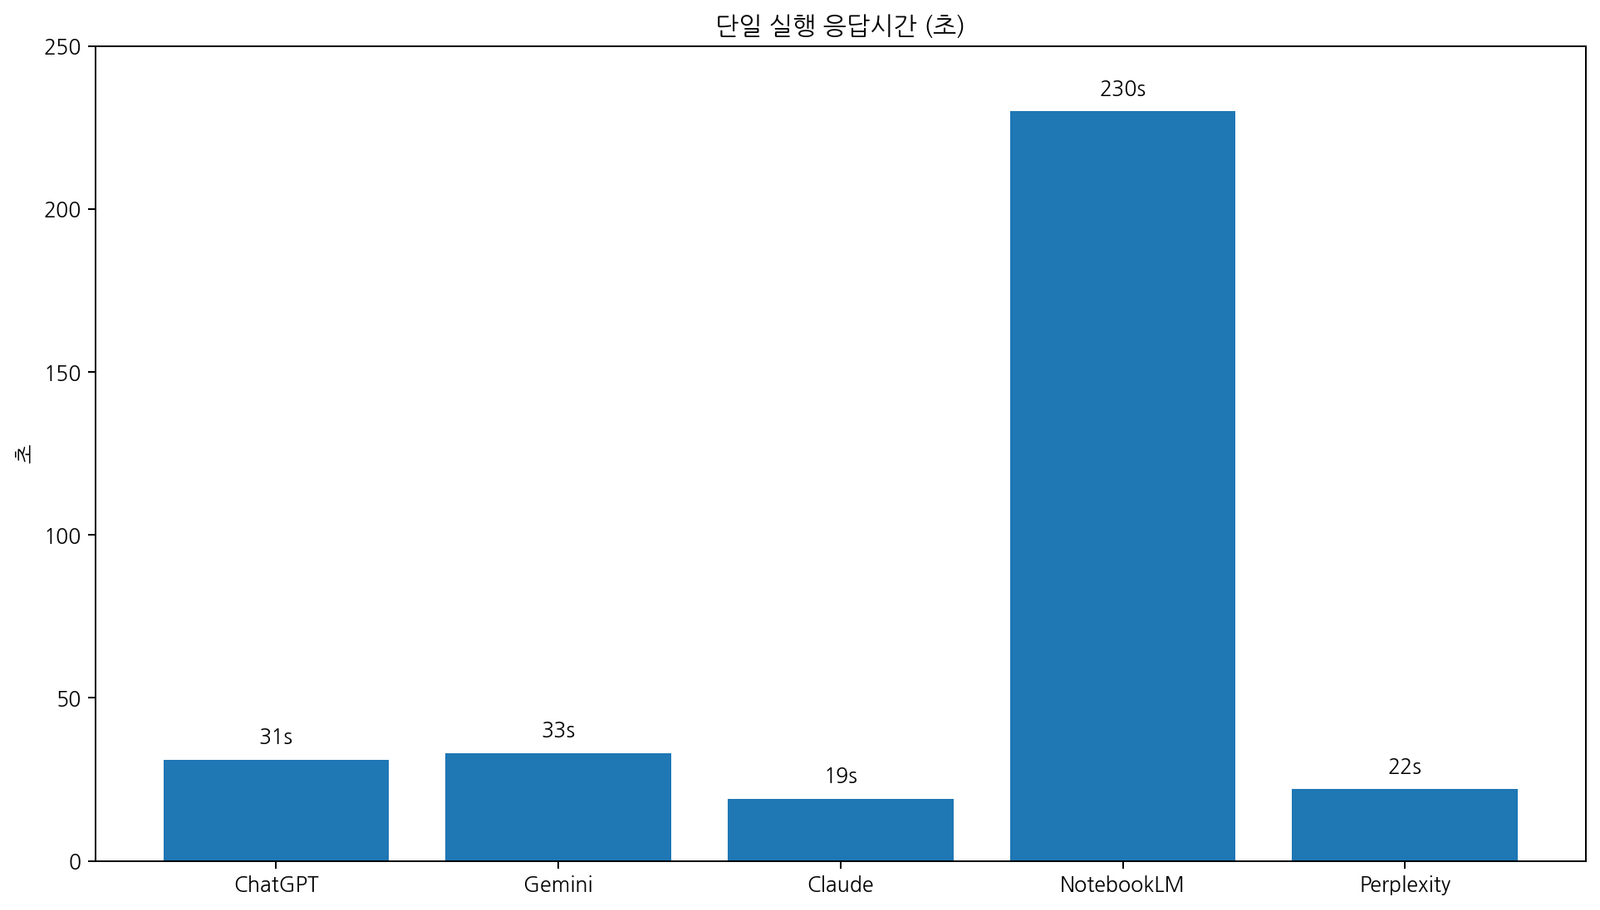
- Claude: 19초
- Perplexity: 22초
- ChatGPT: 31초
- Gemini: 33초
- NotebookLM: 230초
응답시간은 각 서비스에서 한 번만 측정한 값입니다. 네트워크 상태, 서버 부하, 분석 과정에 따라 달라질 수 있으므로 일반적인 속도 순위로 해석하지 않았습니다.
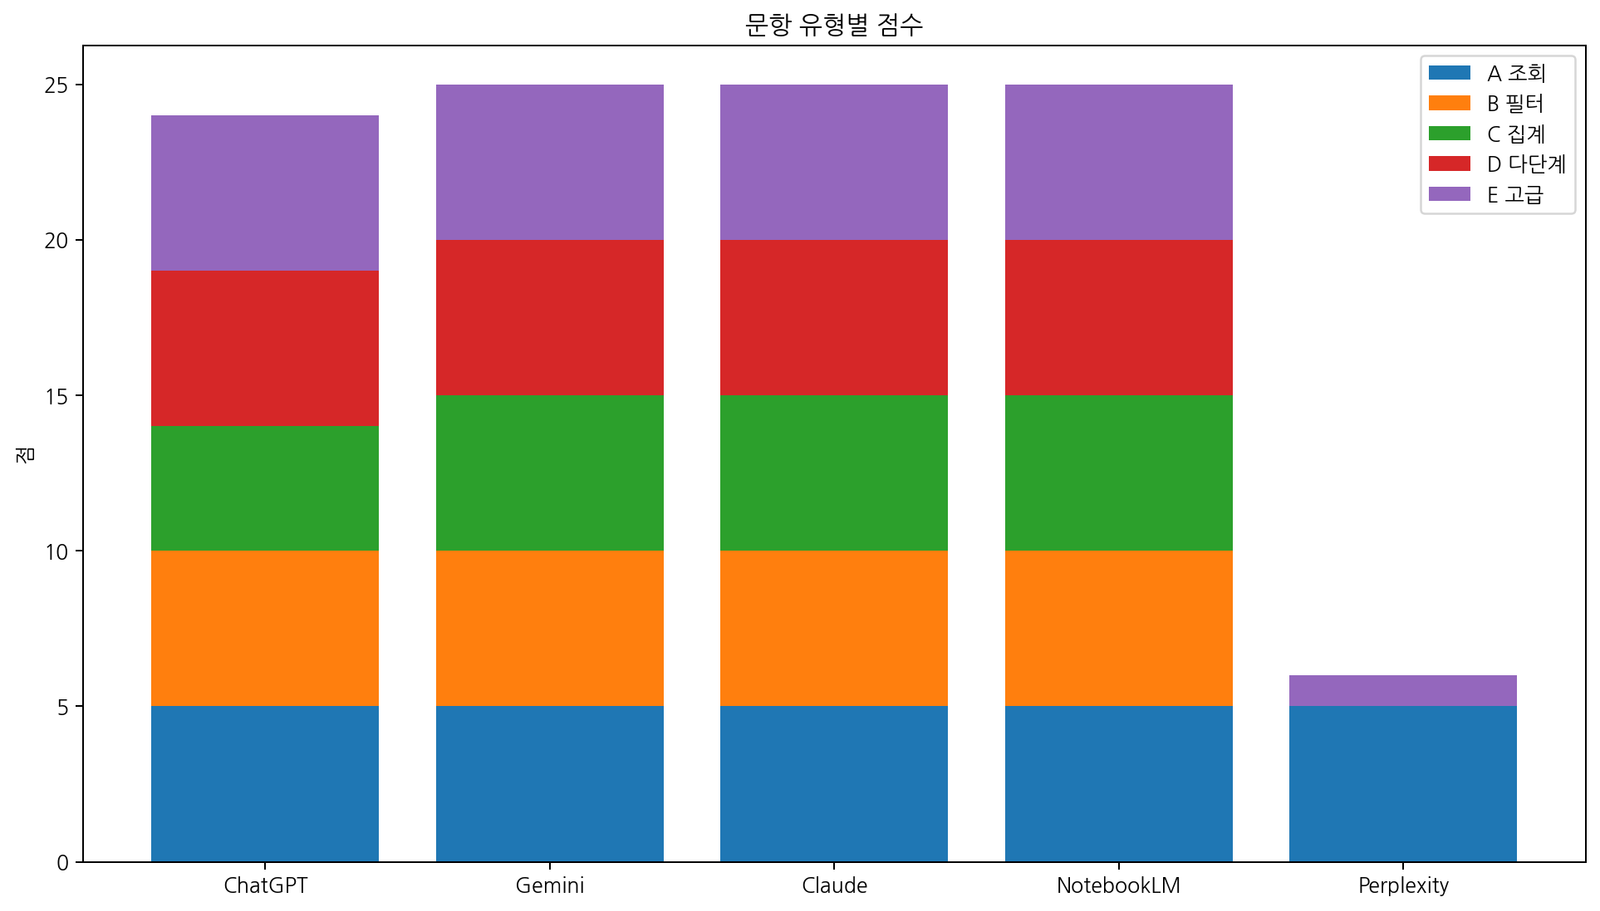
이번 테스트에서 확인한 포인트
단순히 CSV를 열 수 있는지보다 여러 조건을 동시에 적용하고, 올바른 분모를 선택해 비율을 계산하고, 그룹별 합계를 다시 비교하는 과정에서 서비스 간 차이가 더 잘 드러났습니다.
특히 E5처럼 공식으로 값을 다시 검산해 불일치 행을 찾는 문제는 단순 질의응답이 아니라 데이터 품질 점검에 가까운 작업입니다. Gemini·Claude·NotebookLM·ChatGPT는 이 문제에서 세 레코드를 모두 찾았고, Perplexity는 한 레코드만 제시했습니다.
이번 테스트의 한계
- 가상의 이커머스 CSV 1개, 180행, 25문항으로 진행한 단일 테스트입니다.
- 대용량 CSV, 여러 파일 조인, 피벗테이블 생성, 차트 작성은 이번 범위에 포함하지 않았습니다.
- 서비스별 내부 분석 도구나 코드 실행 방식은 동일하지 않을 수 있습니다.
- 각 서비스의 첫 응답만 사용했으며 재계산·수정 요청은 하지 않았습니다.
- 응답시간은 각 서비스 1회 측정값입니다.
- Perplexity는 기존 무료 계정의 파일 첨부가 되지 않아 별도 Standard 무료 계정을 사용했습니다.
관련 KRBench 테스트
PDF 문서 이해에서는 결과가 어떻게 달랐을까?
같은 7페이지 한국어 PDF와 10개 질문으로 문서 이해 정확도, 환각, 근거 페이지, 응답시간을 비교했습니다.
→ 한국어 PDF AI 정확도 비교 보기KRBench는 같은 입력과 같은 질문을 사용해 직접 시험하고, 정답뿐 아니라 실패 조건과 테스트 환경 차이도 함께 기록합니다.
CSV 분석이 아니라, 한국어 요구사항만 보고 코드를 만들게 하면 얼마나 정확할까?
ChatGPT, Gemini, Claude, Perplexity에 같은 Python 함수 8개를 구현하게 한 뒤 첫 응답 코드를 숨은 단위테스트 32개로 직접 실행해 비교했습니다.
→ AI 코딩 정확도 비교 보기