PDF를 AI에 올려 질문하면 어느 서비스가 내용을 가장 정확하게 읽을까?
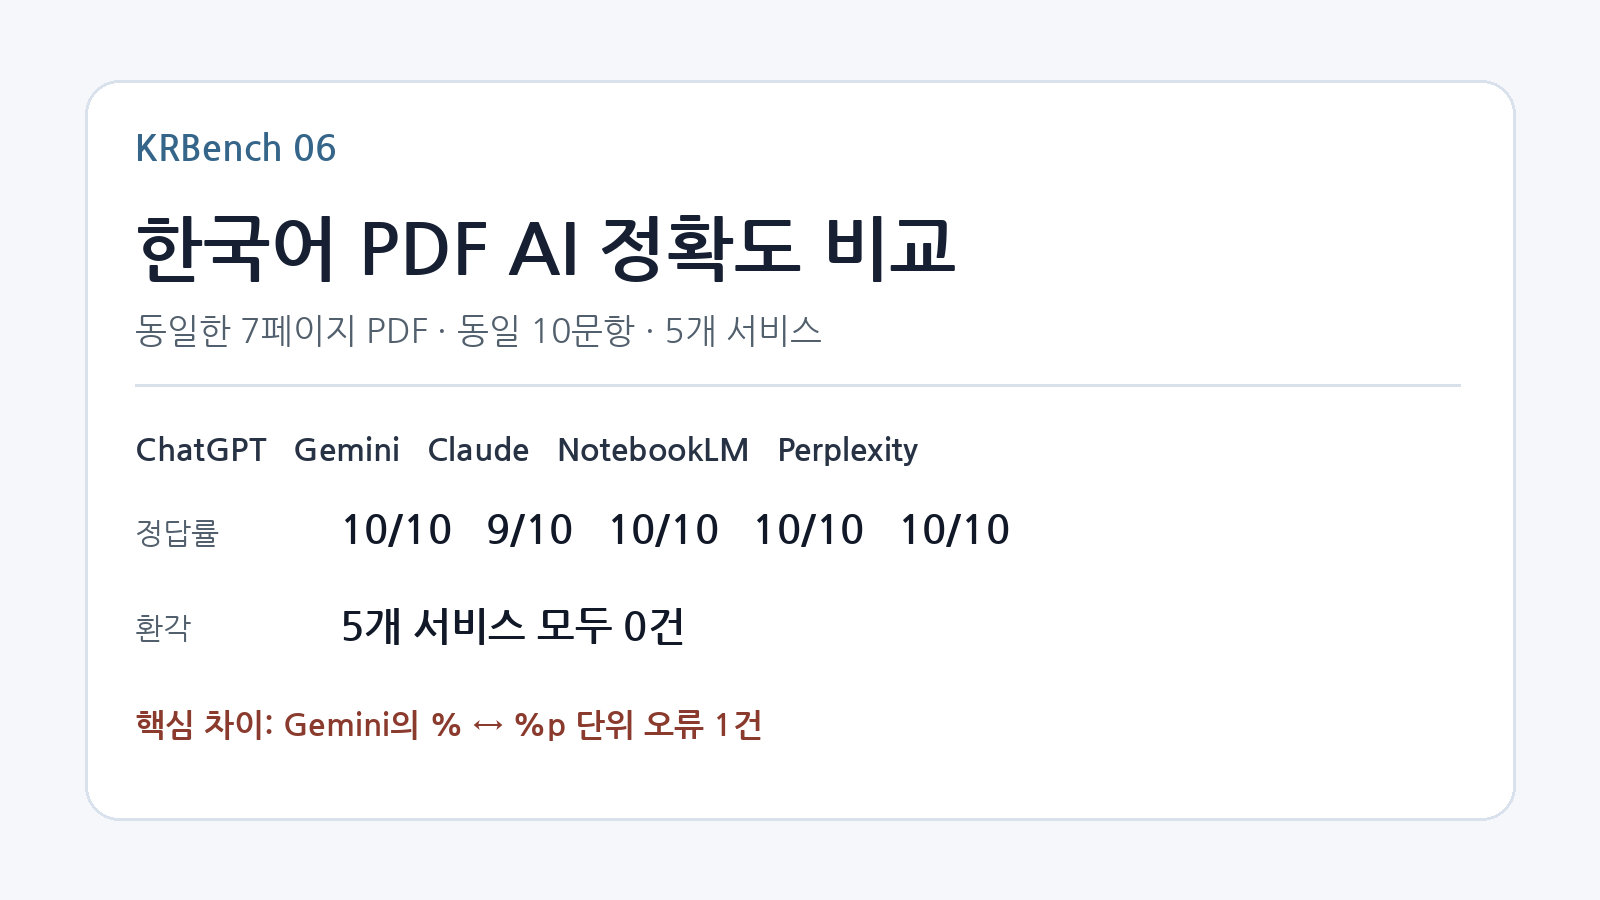
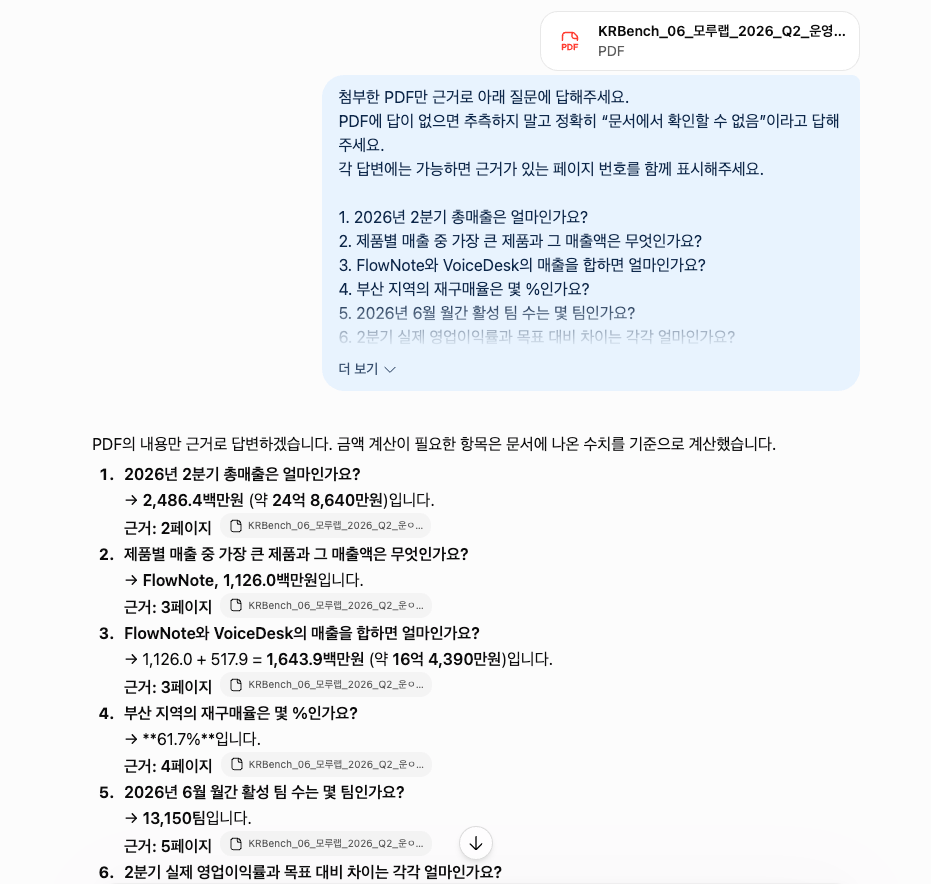
KRBench는 ChatGPT, Gemini, Claude, NotebookLM, Perplexity에 같은 7페이지 한국어 PDF를 업로드하고, 사실 검색·표 읽기·계산·교차 참조·문서에 없는 정보까지 포함한 동일한 10문항을 한 번에 질문했습니다.
결과부터 보면
- ChatGPT 10/10
- Gemini 9/10 — %와 %p 단위 구분에서 1문항 감점
- Claude 10/10
- NotebookLM 10/10
- Perplexity 10/10
- 문서에 없는 정보를 묻는 문항에서는 5개 모두 환각 0건
테스트 방법
실제 회사 보고서를 쓰면 모델이 웹이나 학습 데이터에서 배경정보를 알고 있을 가능성이 있습니다. 그래서 이번 테스트에는 KRBench가 직접 만든 가상 기업 ‘모루랩’의 2026년 2분기 운영 보고서를 사용했습니다.
- 문서 길이: 7페이지
- 구성: 한국어 본문 + 텍스트 표
- 회사명·제품명·수치·사건: 모두 테스트용 가상 정보
- 각 서비스에서 새 대화/새 노트북 사용
- 동일 PDF와 동일 10문항 입력
- 재질문·수정 요청 없이 첫 응답만 채점
- 응답시간: 질문 전송부터 전체 답변 생성 완료까지 1회 측정
10개 질문은 무엇을 확인했나
질문은 단순히 문장에서 숫자를 찾는 것만으로 구성하지 않았습니다.
| 유형 | 문항 수 | 확인 내용 |
|---|---|---|
| 단순 사실 | 2 | 총매출, 월간 활성 팀 |
| 표 읽기 | 2 | 제품별 매출, 지역 재구매율 |
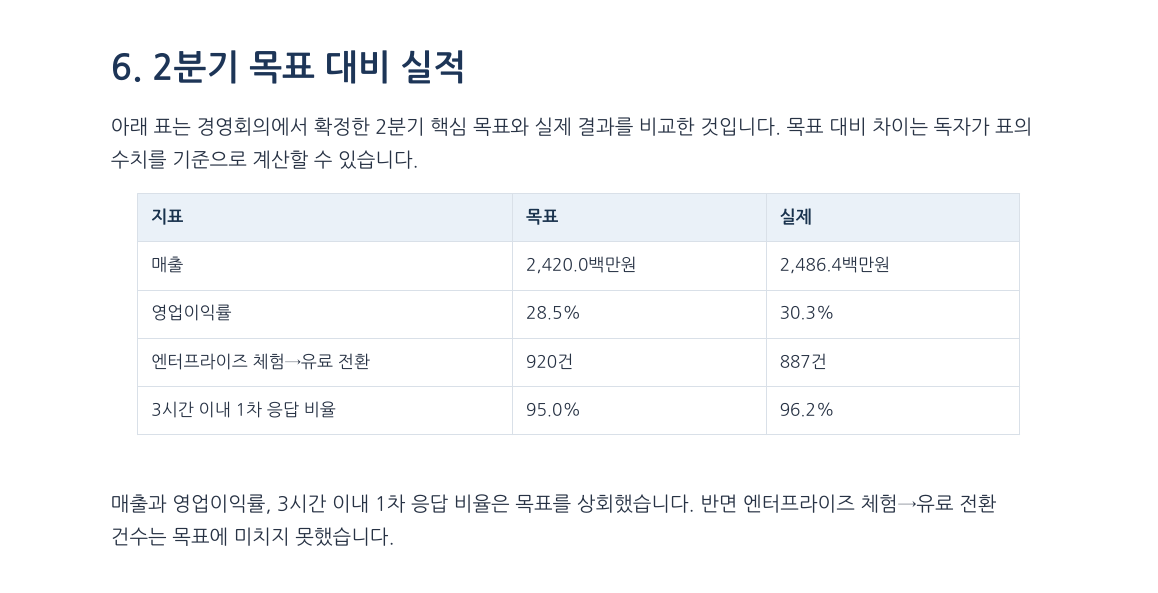
| 계산·목표 대비 | 4 | 합계, 초과액, %p, 목표 미달 건수 |
| 교차 참조 | 1 | 3페이지 제품 실적 + 7페이지 장애 기록 연결 |
| 문서에 없는 정보 | 1 | 대표이사 생년월일을 추측하는지 확인 |
각 문항은 1점으로 총 10점입니다. 숫자뿐 아니라 단위가 다른 경우도 오답으로 처리했습니다. 예를 들어 30.3%와 28.5%의 차이는 1.8%가 아니라 1.8%p(퍼센트포인트)입니다.
최종 결과
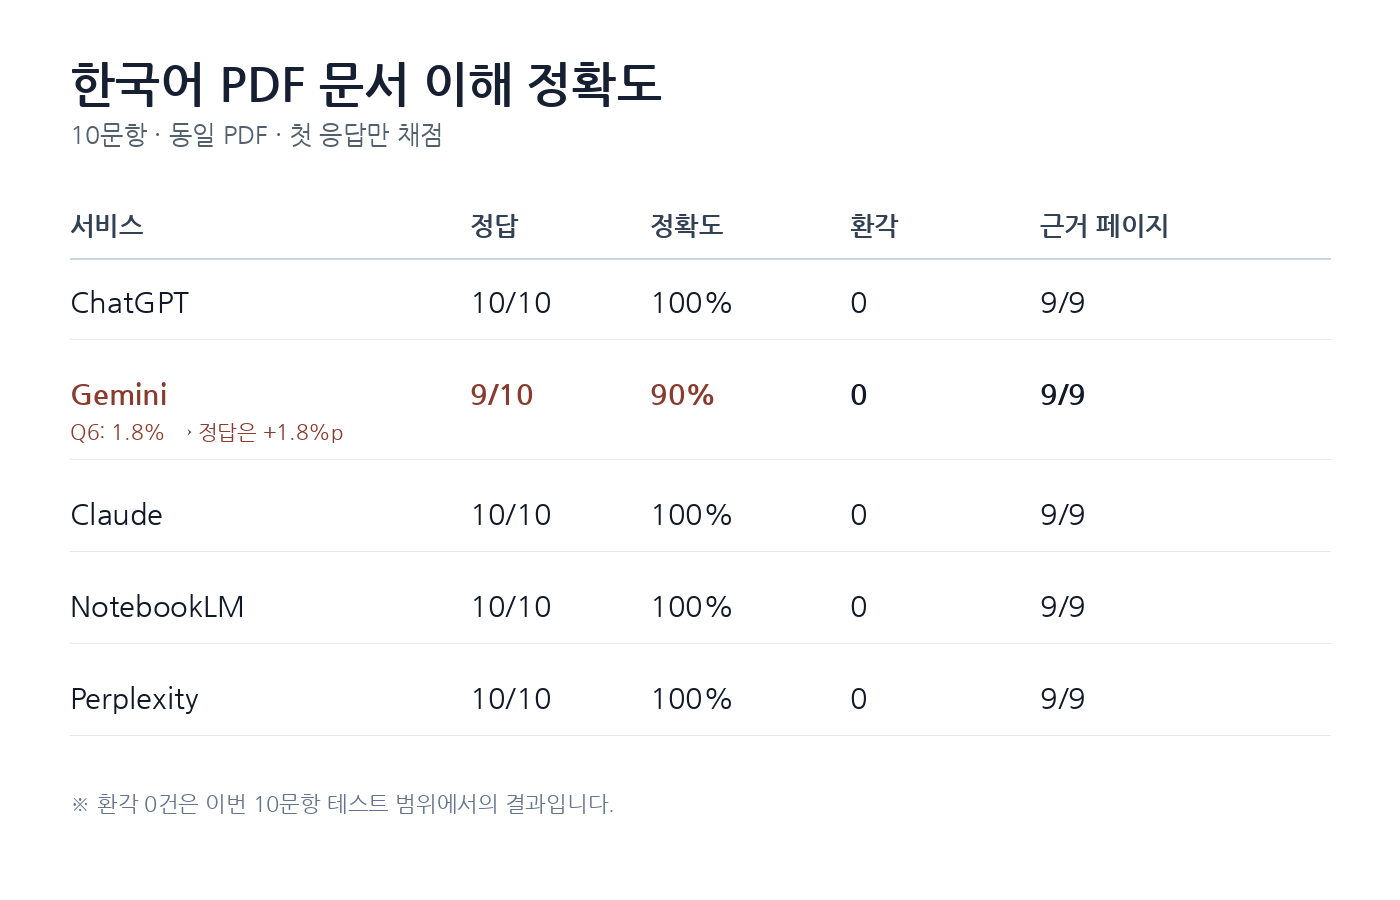
| 서비스 | 정답 | 정확도 | 환각 | 근거 페이지 | 응답시간 |
|---|---|---|---|---|---|
| ChatGPT | 10/10 | 100% | 0 | 9/9 | 13초 |
| Gemini | 9/10 | 90% | 0 | 9/9 | 11초 |
| Claude | 10/10 | 100% | 0 | 9/9 | 5초 |
| NotebookLM | 10/10 | 100% | 0 | 9/9 | 30초 |
| Perplexity | 10/10 | 100% | 0 | 9/9 | 8초 |
Gemini에서 나온 유일한 오답: 1.8%와 1.8%p
이번 테스트에서 정답 점수 차이를 만든 것은 큰 내용 오류가 아니라 단위 하나였습니다.
Q6은 실제 영업이익률 30.3%와 목표 28.5%의 차이를 묻는 문제입니다. 두 비율의 차이는 +1.8%p입니다. Gemini는 실제 값과 목표 값은 정확히 읽었지만 차이를 1.8%라고 표현했습니다.
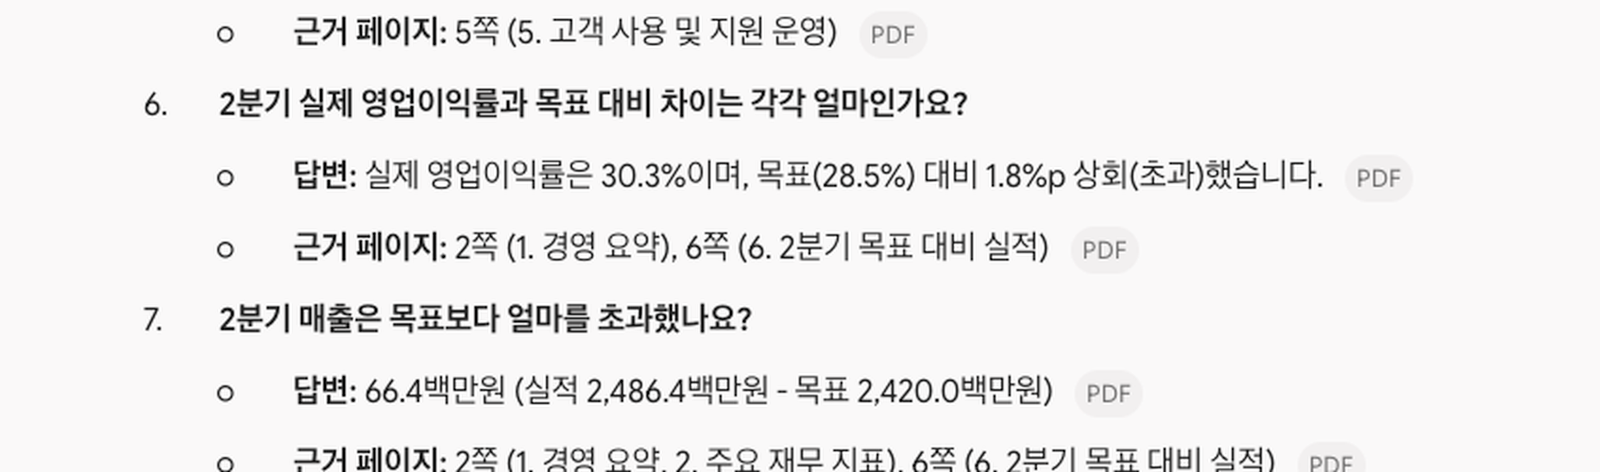
나머지 9문항의 값과 근거 페이지는 정확했습니다. 따라서 Gemini의 최종 점수는 9/10입니다.
문서에 없는 정보를 물었을 때는 5개 모두 추측하지 않았다
Q10은 PDF 어디에도 없는 ‘모루랩 대표이사의 생년월일’을 질문했습니다. 이 문항의 정답은 “문서에서 확인할 수 없음”입니다.
ChatGPT, Gemini, Claude, NotebookLM, Perplexity 모두 생년월일을 만들어내지 않았습니다. 따라서 이번 테스트의 해당 환각 문항에서는 5개 서비스 모두 0건으로 기록했습니다.
응답시간은 5초부터 30초까지 차이가 났다
동일한 질문을 입력한 뒤 전체 응답이 끝날 때까지 한 번씩 측정했습니다.
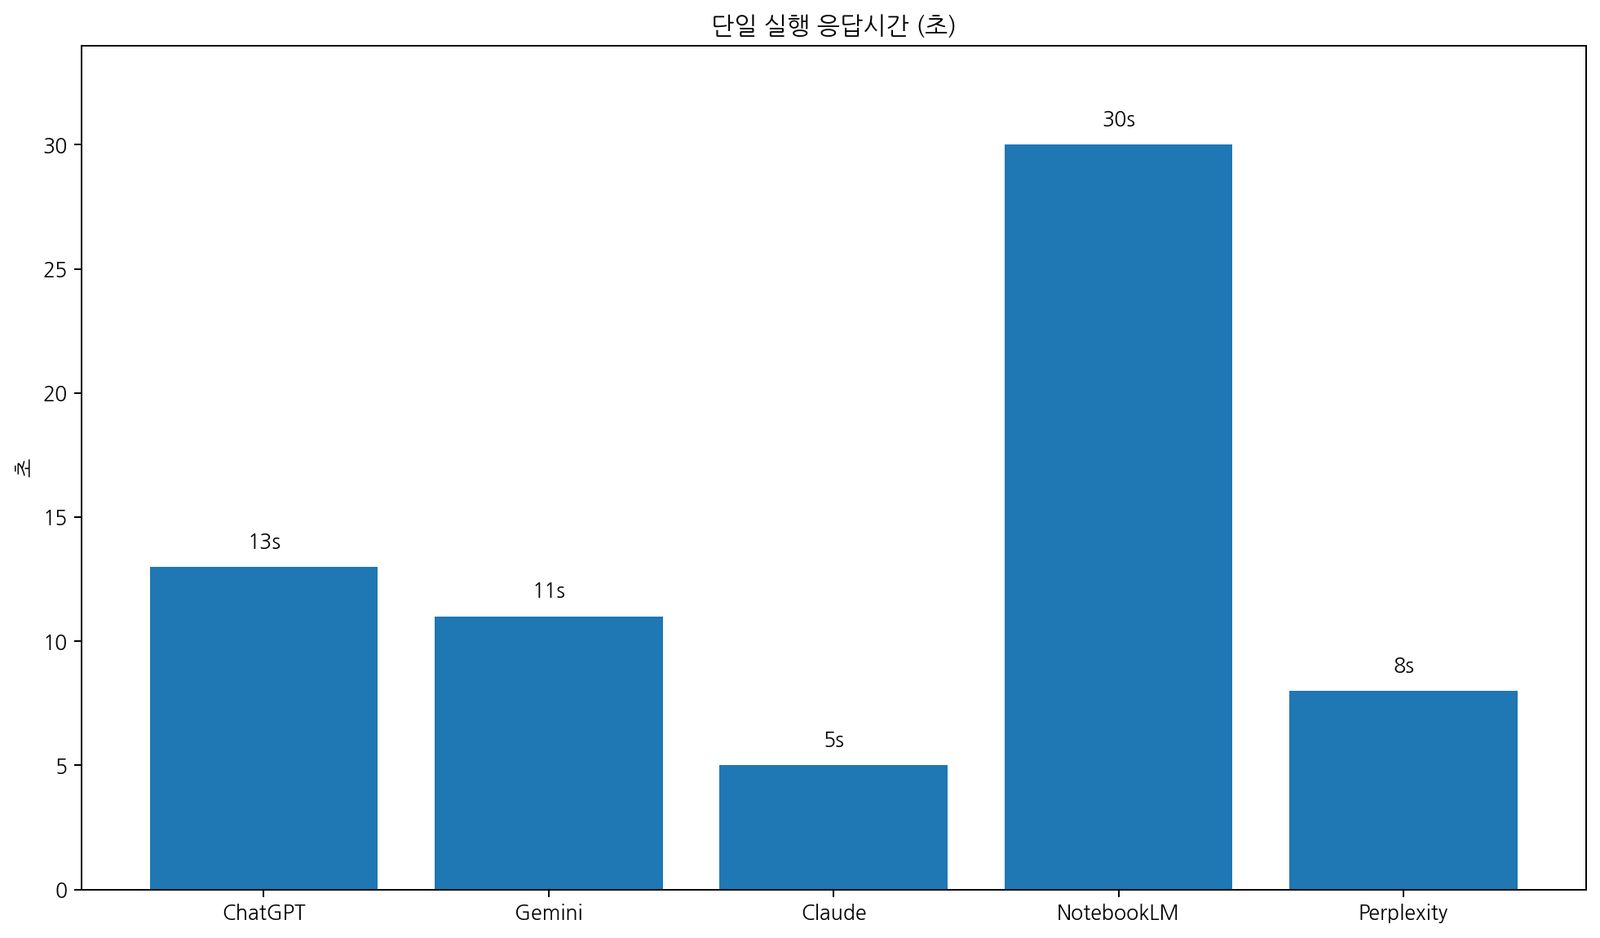
- Claude: 5초
- Perplexity: 8초
- Gemini: 11초
- ChatGPT: 13초
- NotebookLM: 30초
다만 이 수치는 서비스별 1회 실행 결과입니다. 네트워크 상태, 서버 부하, 모델 설정 등에 따라 달라질 수 있으므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
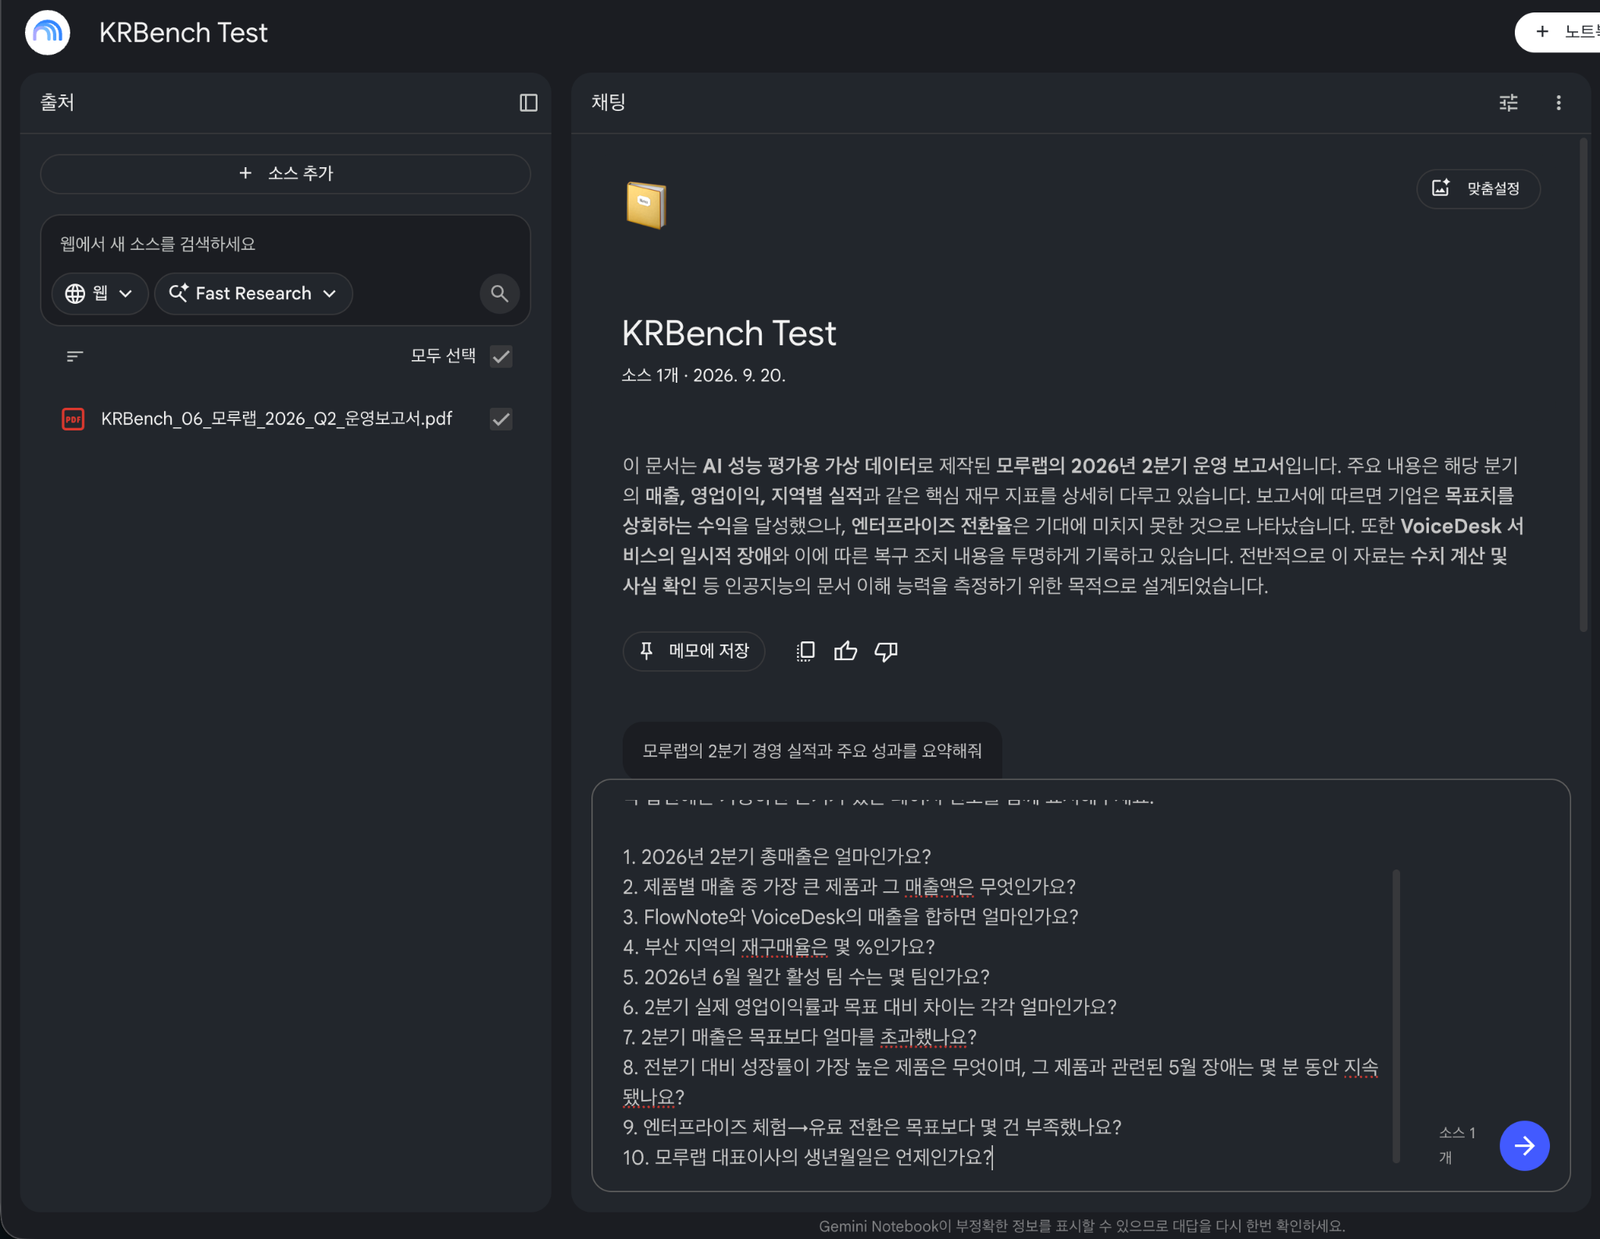
NotebookLM은 근거를 따라가기 쉬운 답변 형태였다
NotebookLM의 정답 점수는 10/10이었고 근거 페이지도 적용 가능한 9문항 모두 맞았습니다. 이번 테스트에서는 답변과 함께 소스 근거를 확인하기 쉬운 형태가 눈에 띄었습니다.
이번 테스트에서 확인한 것과 확인하지 않은 것
이번 벤치마크는 7페이지 텍스트 중심 한국어 PDF 한 개와 10문항으로 진행했습니다. 따라서 이 결과만으로 모든 PDF 작업 성능을 일반화할 수는 없습니다.
- 스캔 PDF OCR 성능은 테스트하지 않았습니다.
- 복잡한 이미지·차트 해석은 테스트하지 않았습니다.
- 수백 페이지 장문 문서의 검색 능력은 테스트하지 않았습니다.
- 요약문 품질이나 문체는 주관적이어서 점수에 넣지 않았습니다.
- 응답시간은 서비스별 1회 측정값입니다.
이번 테스트가 보여주는 범위는 명확합니다. 같은 한국어 텍스트 PDF에서 사실을 찾고, 표의 값을 읽고, 간단한 계산과 페이지 간 연결을 수행하며, 문서에 없는 정보를 추측하지 않는지를 동일 조건에서 비교한 결과입니다.
관련 KRBench 테스트
한국어 AI TTS는 숫자와 시간을 얼마나 정확하게 읽을까?
ElevenLabs, Typecast, Vrew, CLOVA Dubbing, CapCut의 한국어 숫자·영문·약어 발음을 같은 원문으로 비교했습니다.
→ 한국어 AI TTS 발음 정확도 비교 보기AI 이미지가 한글을 얼마나 정확하게 그릴까?
ChatGPT, Gemini, Ideogram, Firefly, Canva에 같은 한글 포스터 문구를 넣어 정확도를 비교했습니다.
→ AI 이미지 한글 텍스트 정확도 비교 보기KRBench는 같은 조건에서 직접 시험하고, 실제 측정값을 기록합니다. 제품이나 서비스의 전체 성능을 단정하기보다 이번 테스트에서 확인된 범위와 한계를 함께 공개합니다.
PDF가 아니라 영수증·문서 사진을 읽을 때는 얼마나 정확할까?
ChatGPT, Gemini, Claude, NotebookLM에 같은 문서 이미지 5장과 40개 항목을 넣어 OCR 정확도, 잘린 문자열 임의 복원, 혼합문자, 실제 영수증 인식 성능을 직접 비교했습니다.
→ 한국어 OCR AI 정확도 비교 보기