KRBench AI 코딩 정확도 3편은 기존 멀티파일 코드베이스의 회귀 버그를 32줄 이하 패치로 고치는 테스트입니다. 28호는 Python 모듈 전체 수정, 29호는 SQLite 쿼리 수정이었고, 이번에는 전체 파일을 다시 쓰지 못하게 한 뒤 기존 코드에서 여러 버그를 찾아 최소한의 unified diff만 제출하게 했습니다.
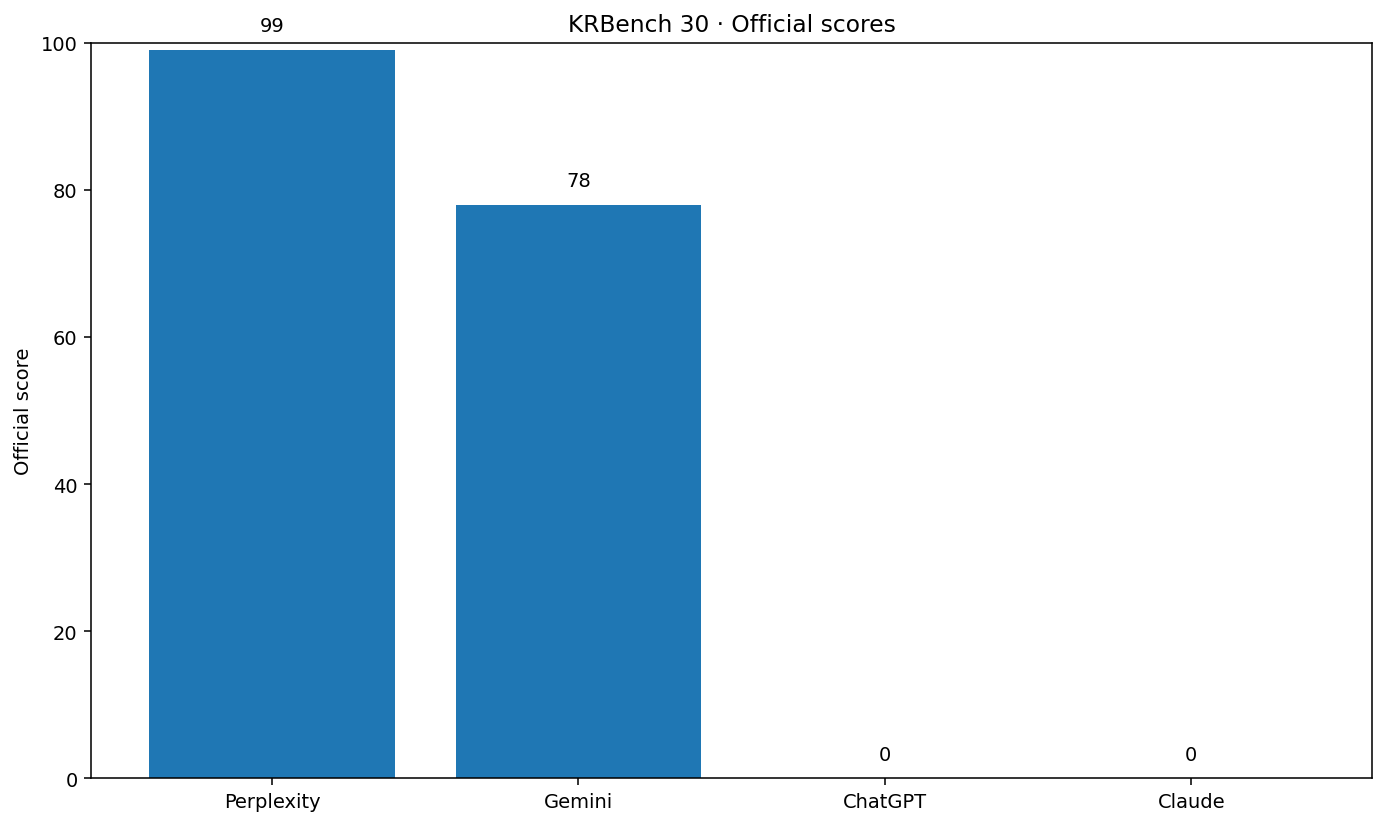
이 테스트는 앞선 후보 테스트 여러 개에서 천장 효과가 반복된 뒤 다시 설계했습니다. 최종 결과는 Perplexity 99점, Gemini 78점, ChatGPT 0점, Claude 0점이었습니다. 이번에는 네 서비스 모두 100점인 결과가 나오지 않았고, 실패 형태도 분명하게 갈렸습니다.
공식 결과
- Perplexity: 99/100 · Directed 59/60 · Scenario 20/20 · 40초 · 32/32 changed lines
- Gemini Flash: 78/100 · Directed 54/60 · Scenario 12/20 · 5초 · 19/32 changed lines
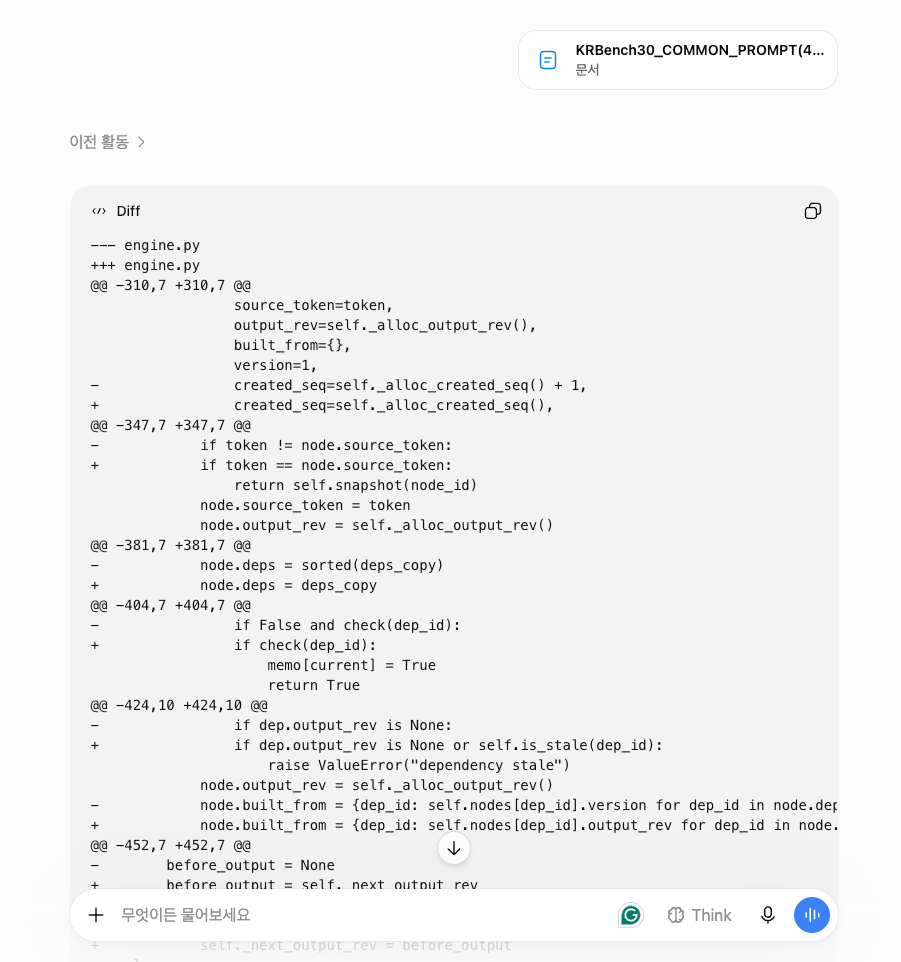
- ChatGPT: 0/100 · patch 적용 실패 · 5초 · 21/32 changed lines
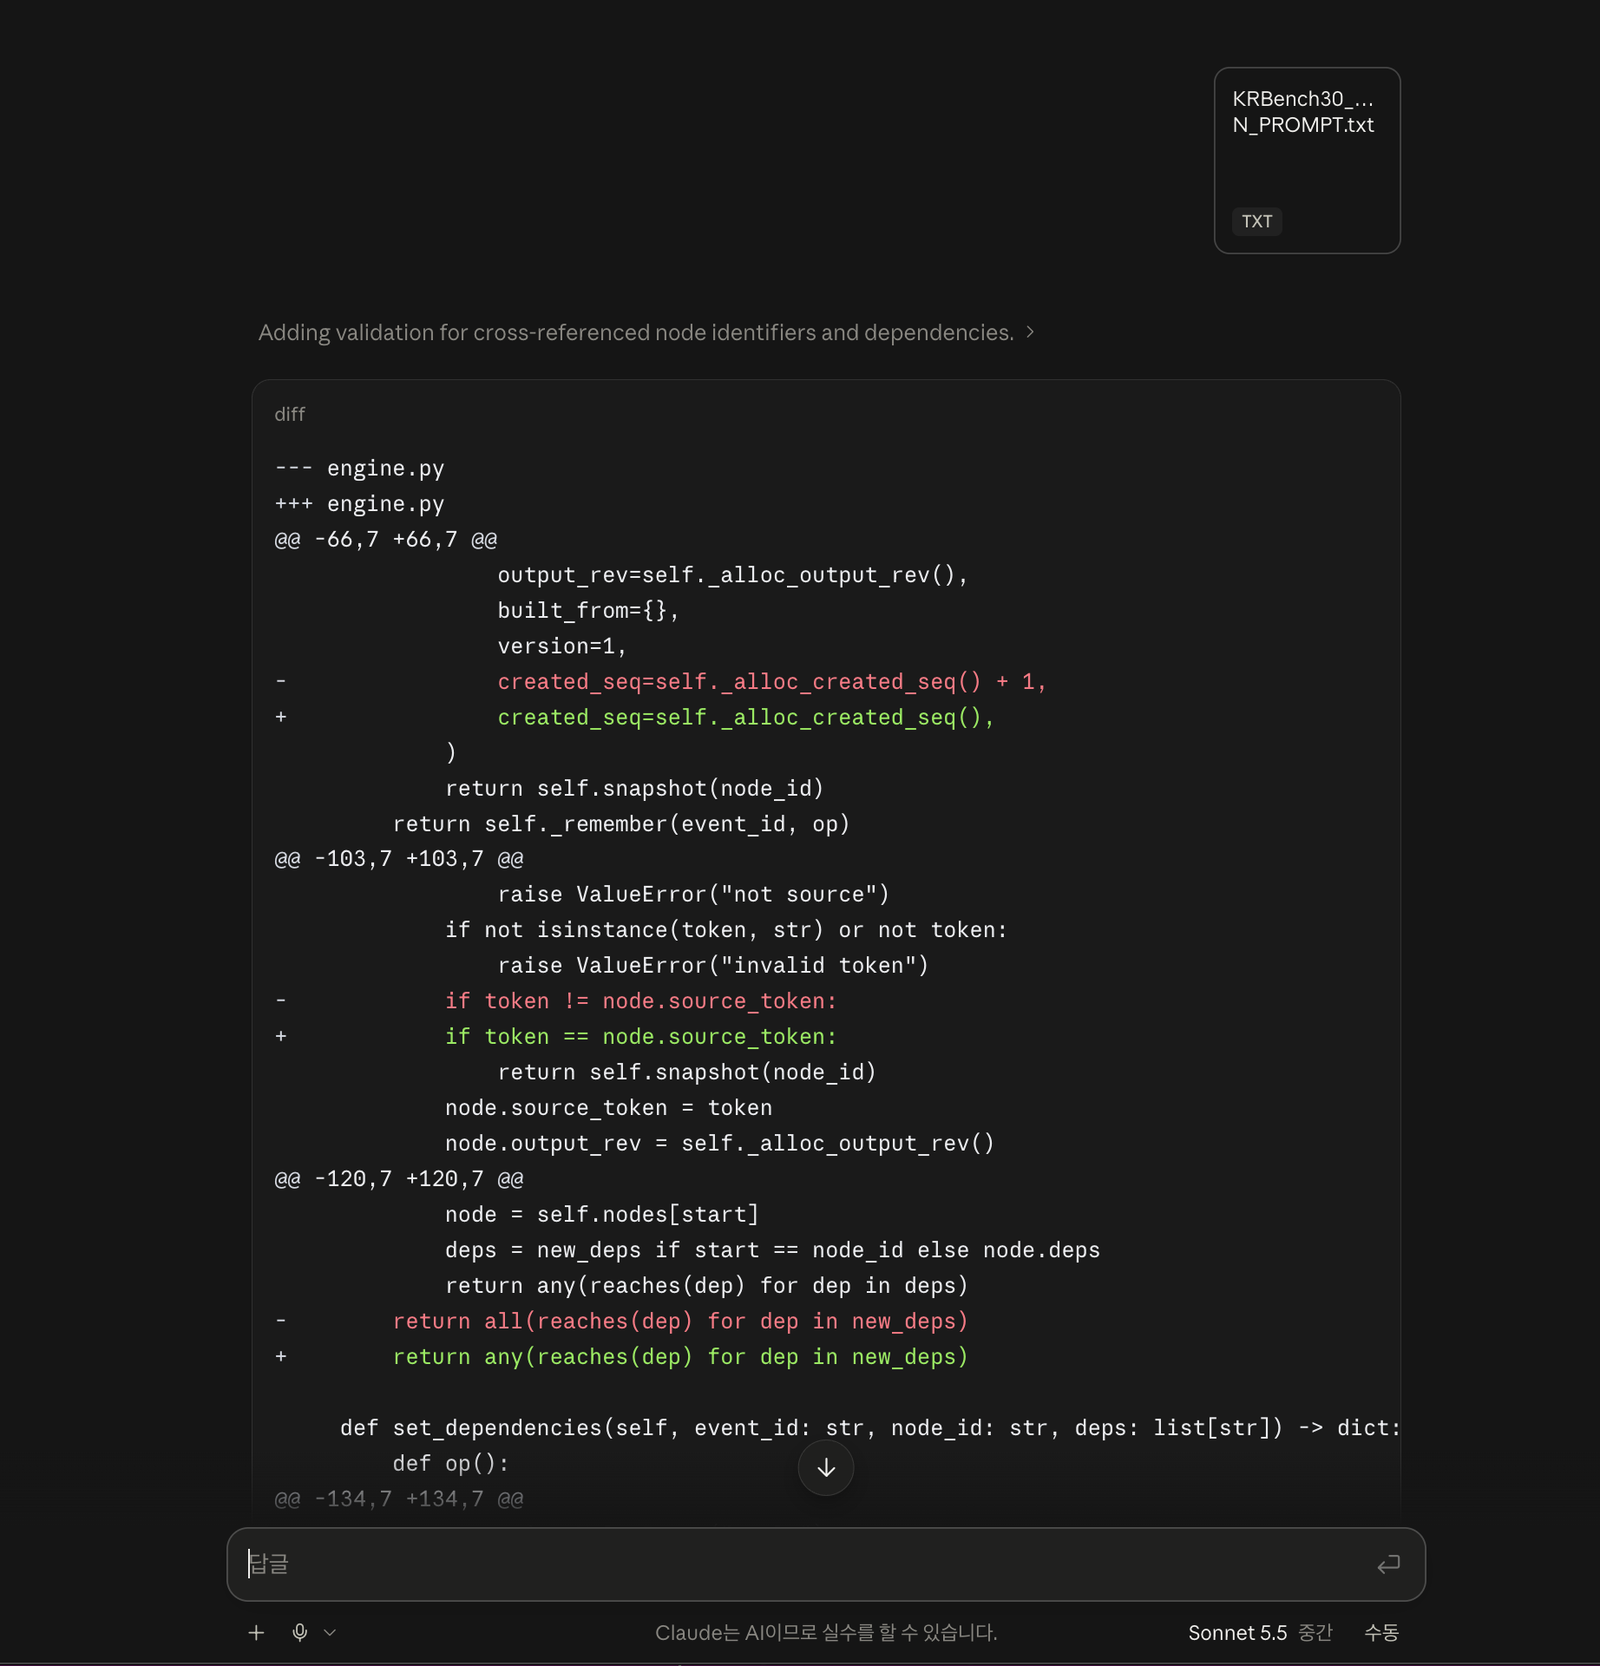
- Claude Sonnet 5.5 · 중간: 0/100 · patch 적용 실패 · 29초 · 25/32 changed lines
테스트 방법: 전체 재작성 대신 32줄 이내 최소 패치
모든 서비스에 동일한 KRBench30_COMMON_PROMPT.txt 파일을 직접 첨부했습니다. 코드베이스에는 SPEC.md, models.py, engine.py, planner.py, checkpoint.py, public_tests.py가 들어 있습니다.
읽기 전용 파일과 수정 가능 파일을 분리했고, 실제 수정은 engine.py, planner.py, checkpoint.py 세 개만 허용했습니다. 출력은 설명 없이 unified diff 코드블록 하나로 제한했습니다.
가장 큰 제약은 패치 크기였습니다. 추가된 소스 줄과 삭제된 소스 줄을 합쳐 최대 32줄만 허용했습니다. 사전 reference의 정답 패치는 29줄이었습니다. 허용 파일을 건드리거나 32줄을 넘기거나 patch가 실제 저장소에 적용되지 않으면 0점이라는 규칙도 서비스 결과를 보기 전에 고정했습니다.
| 사전 검증 | 결과 | 의미 |
|---|---|---|
| Reference | 100/100 | 동일 공식 grader 통과 |
| Buggy baseline | 39/100 | 수정 전 저장소 |
| Golden patch | 29/32줄 | 패치 제한 안에 정답 존재 |
| Independent Oracle | 8,000 operations | generated state 교차검증 일치 |
| Mutation testing | 30/30 | 의도적 오류 구현 전부 검출 |
| Scored ambiguity | 0건 | 채점 의존 모호성 사전 제거 |
채점: 숨은 테스트 60점 + 상태 시나리오 40점
공식 점수는 Directed hidden checks 60개를 각각 1점으로 계산하고, fixed-seed differential scenario 20개를 각각 2점으로 계산해 총 100점으로 만들었습니다.
Directed 구간은 생성 순서, 전역 idempotency, source update, dependency 편집, cycle 검증, transitive freshness, build, planner, batch rollback, checkpoint continuation을 세분화해 확인했습니다. Scenario 구간은 여러 상태 변경을 연속 실행한 뒤 reference Oracle과 결과·예외·전체 상태가 계속 같은지 비교했습니다.
사전 calibration에서는 공개 테스트에서 보이는 문제 위주로 수정한 가상 구현이 75점, 숨은 결함 3개를 남긴 거의 맞는 구현이 83점, 미묘한 핵심 결함 1개만 남긴 구현이 86점이었습니다. 이 값은 실제 서비스 점수 예측용이 아니라 숨은 결함이 있어도 쉽게 100점이 되지 않는지 확인하기 위한 내부 품질 게이트였습니다.
Perplexity 99점: 딱 한 가지 순서 의존성에서 실패
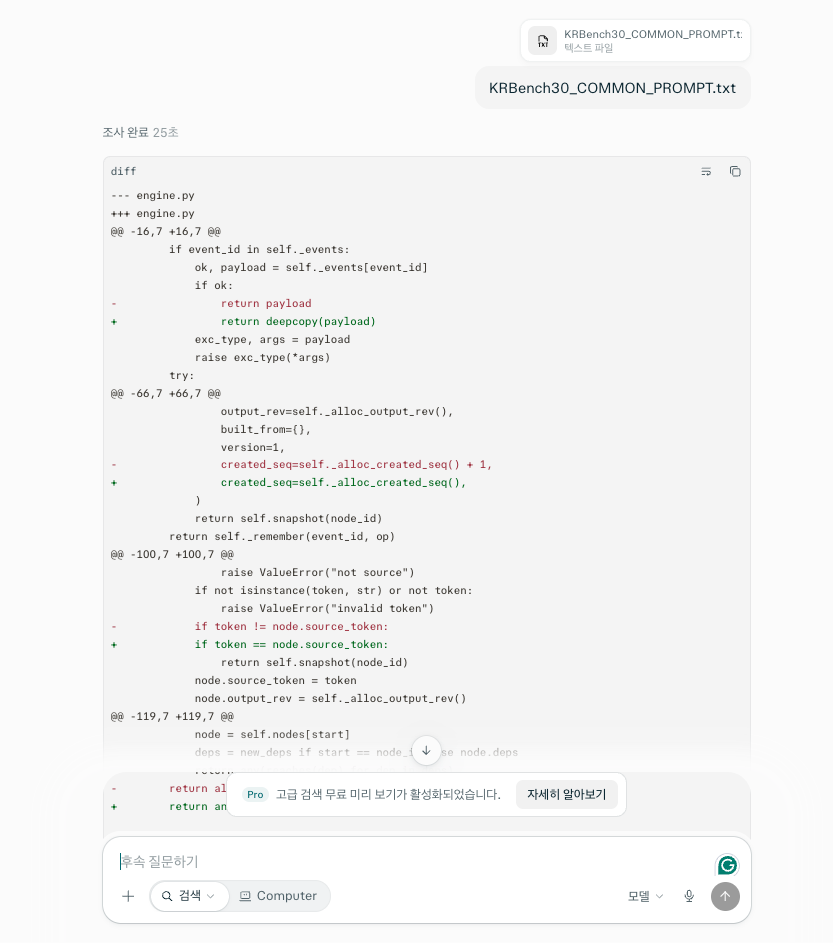
Perplexity는 changed lines를 정확히 32/32까지 사용했고, 제출한 patch도 실제 저장소에 정상 적용됐습니다. Directed 60개 중 59개, differential scenario 20개 전부를 통과해 99점을 기록했습니다.
유일한 실패는 D03-8이었습니다. derived node가 기존에 ["s1", "s2"] 순서의 dependency로 빌드된 뒤 dependency 순서만 ["s2", "s1"]로 바뀌면, 명세상 dependency order 자체가 의미를 가지므로 stale이 되어야 합니다.
Perplexity는 여러 핵심 버그를 거의 모두 수정했지만, freshness 판단에서 built_from의 키 순서와 현재 dependency 순서를 비교해야 하는 이 한 가지 조건을 남겼습니다. 결과적으로 최고점은 100이 아니라 99에서 멈췄습니다.
Gemini 78점: patch는 적용됐지만 세 가지 축에서 오류
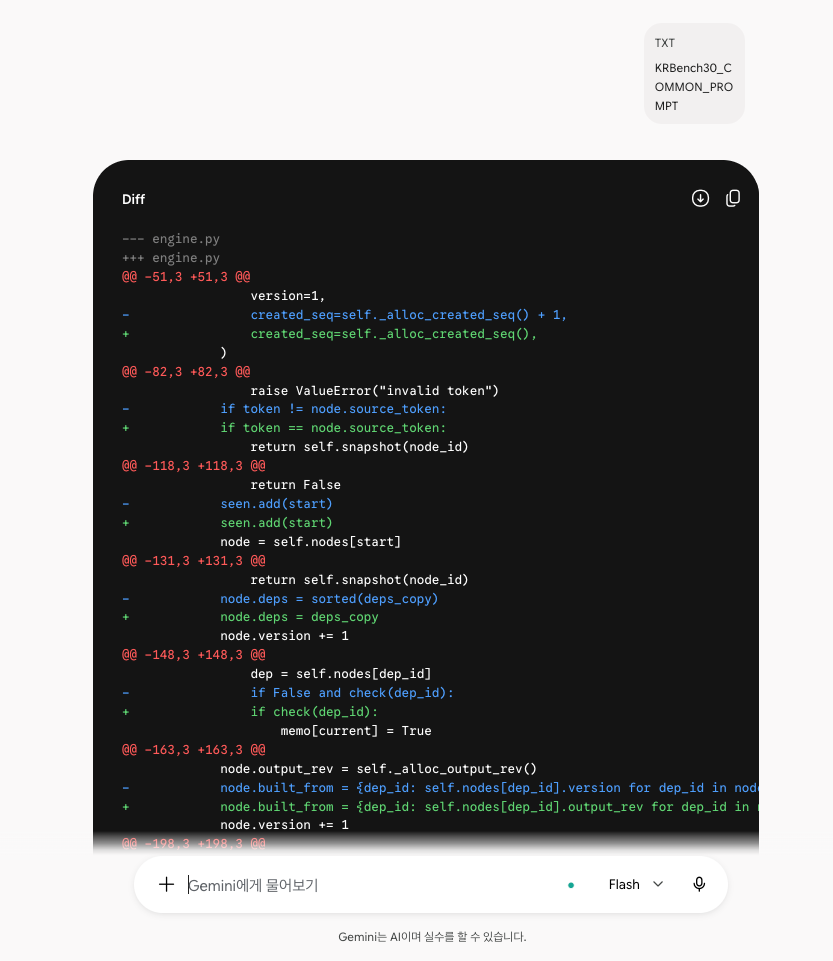
Gemini는 19/32줄로 제한을 지켰고 patch도 정상 적용됐습니다. 따라서 78점은 제출 형식이 아니라 실제 동작 차이에서 나온 점수입니다.
Directed에서는 54/60을 통과했습니다. 가장 먼저 dependency 순서만 변경했을 때 stale이 되어야 하는 D03-8을 놓쳤습니다. 또 cycle 판정의 핵심 회귀를 완전히 고치지 않아 빈 dependency로 정상 변경할 때도 ValueError("cycle")을 내는 경우가 남았습니다.
batch rollback에서는 _next_output_rev를 되돌리는 대입문은 수정했지만, 그 전에 저장하는 before_output이 여전히 None인 버그를 남겼습니다. 이 때문에 rollback 이후 output revision 카운터가 깨지는 Directed 테스트가 여러 개 실패했습니다.
Fixed-seed scenario에서는 20개 중 12개를 통과했습니다. 특히 cycle 오판정이 여러 상태 시퀀스에서 반복적으로 드러났습니다.
ChatGPT 0점: 수정 방향과 별개로 patch 자체가 적용되지 않았다
ChatGPT는 21/32줄을 변경했고, 여러 핵심 버그의 수정 방향도 맞았습니다. 하지만 첫 제출 diff의 hunk header와 실제 포함 줄 수가 맞지 않아 patch 명령이 malformed patch로 중단됐습니다.
이번 테스트에서는 “실제 저장소에 적용 가능한 unified diff”가 제출물의 필수 조건이었습니다. 사전에 patch 적용 실패는 0점으로 고정했기 때문에, 내용을 수동으로 고쳐 다시 실행하지 않고 공식 점수를 0점으로 기록했습니다.
다만 오류 성격을 이해하기 위한 별도 진단에서는 ChatGPT가 의도한 수정만 정상적인 patch로 옮겼을 때 82/100이었습니다. 이 82점은 공식 점수가 아니며, 결과표에는 포함하지 않습니다. 진단상 dependency 순서 기반 freshness와 cycle 처리 등이 여전히 남았습니다.
Claude 0점: 로직은 거의 맞았지만 제출 형식에서 탈락
Claude도 25/32줄로 제한 자체는 지켰습니다. 그러나 제출 diff가 실제 저장소에 clean apply되지 않아 공식 grader가 hidden tests를 실행하지 못했고, 사전 규칙에 따라 0점이 됐습니다.
Claude 역시 진단용으로 의도한 변경을 정상 적용해 보면 99/100이었습니다. 남은 실패는 Perplexity와 같은 D03-8, 즉 dependency 순서 변경을 stale로 처리하는 조건 하나였습니다. 하지만 이 진단값 역시 공식 점수가 아닙니다.
이번 결과는 코딩 벤치마크에서 “어떤 코드를 의도했는가”와 “실제로 적용 가능한 제출물을 냈는가”가 다르다는 점을 보여줍니다. 실제 작업에서는 patch가 적용되지 않으면 수정 내용이 아무리 좋아도 그대로 배포할 수 없습니다.
응답시간: 5초부터 40초
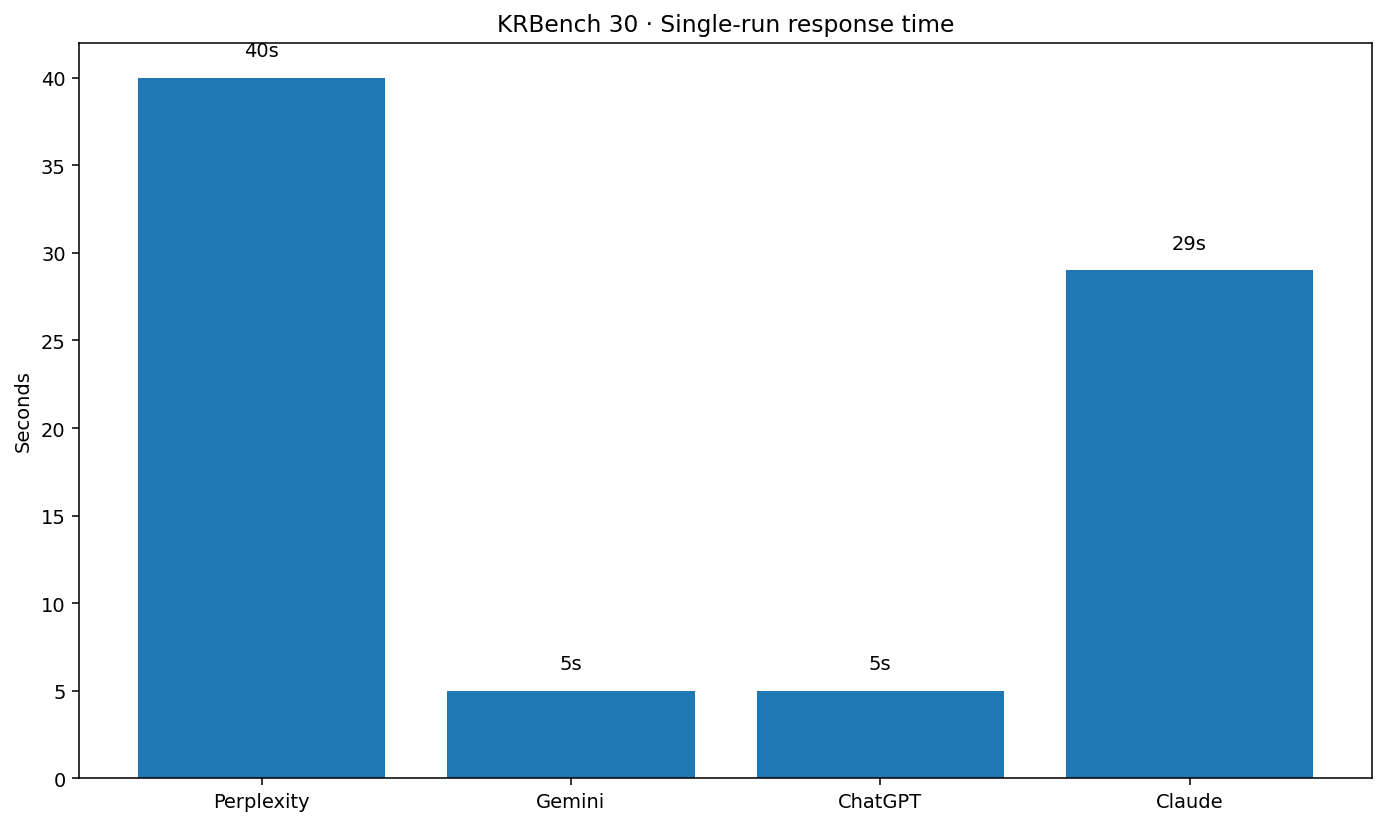
사용자가 직접 측정한 최종 출력 시간은 ChatGPT 5초, Gemini 5초, Claude 29초, Perplexity 40초였습니다.
다만 이 값은 서비스별 단일 실행 측정입니다. 서버 상태와 출력 길이의 영향을 받을 수 있으므로, 이번 1회 측정값을 일반적인 서비스 속도 순위로 확대하지 않습니다.
이번 테스트에서 처음으로 확인한 변별력
29호 SQL 테스트에서는 네 서비스가 모두 100점을 기록했습니다. 이후 내부 후보에서도 천장 효과가 반복돼 여러 테스트를 발행하지 않고 폐기했습니다.
이번에는 단순히 상태 수를 늘린 것이 아니라 기존 코드 분석 + 다중 파일 + 최소 패치 제약 + 실제 patch 적용성 + hidden state-machine 검증을 함께 묶었습니다. 그 결과 최고점도 100이 아닌 99였고, Gemini는 78점, ChatGPT와 Claude는 제출물 적용 단계에서 0점으로 갈렸습니다.
특히 Perplexity와 Claude의 비공식 진단이 99점까지 올라갔다는 점은 테스트가 무작정 불가능하게 설계된 것은 아니라는 점도 보여줍니다. reference는 같은 32줄 제한에서 29줄 패치로 100점을 통과했고, 사전 mutation test 30개도 모두 검출했습니다.
이번 테스트의 한계
- 실제 오픈소스 프로젝트가 아니라 KRBench가 만든 in-memory Incremental Build Graph 코드베이스입니다.
- 32 changed lines 제한은 실제 코드 리뷰의 최소 수정 원칙을 단순화한 인공 제약입니다.
- ChatGPT와 Claude의 0점은 로직 전체가 틀렸다는 의미가 아니라, 공식 제출 diff가 적용되지 않아 hidden grader를 실행할 수 없었다는 의미입니다.
- ChatGPT 82점·Claude 99점의 진단값은 제출 의도를 이해하기 위한 참고값이며 공식 순위나 점수에 사용하지 않습니다.
- hidden tests와 fixed-seed scenarios는 사전 Quality Gate를 통과했지만 모든 가능한 코드 동작을 수학적으로 증명하는 것은 아닙니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
이전 AI 코딩 정확도 테스트
29호 · SQLite 쿼리 버그 수정
JOIN, NULL, window function, recursive CTE 등 10개 SQL을 비공개 데이터셋 50개로 실행했고 네 서비스가 모두 100점을 기록해 천장 효과가 나타났습니다.
→ AI SQLite 쿼리 버그 수정 정확도 비교 보기KRBench는 서비스 결과를 본 뒤 숨은 테스트, 배점, 명세를 바꾸지 않습니다. 이번 30호도 사전에 고정한 grader와 첫 응답을 그대로 사용했습니다.