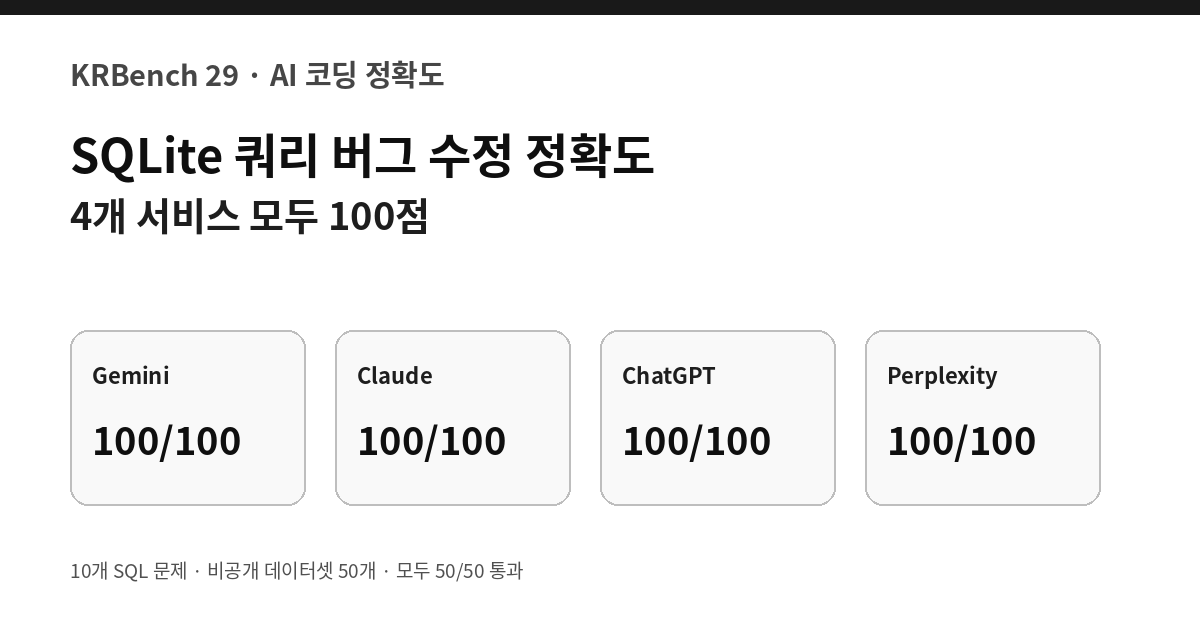
KRBench AI 코딩 정확도 2편은 SQLite 실무 쿼리 버그 수정입니다. 28호가 Python 모듈의 실제 실행 결과를 비교했다면, 이번에는 SQL의 JOIN, NULL, window function, recursive CTE, 세션 계산, cohort, 최신 이벤트 우선순위를 한 번에 테스트했습니다.
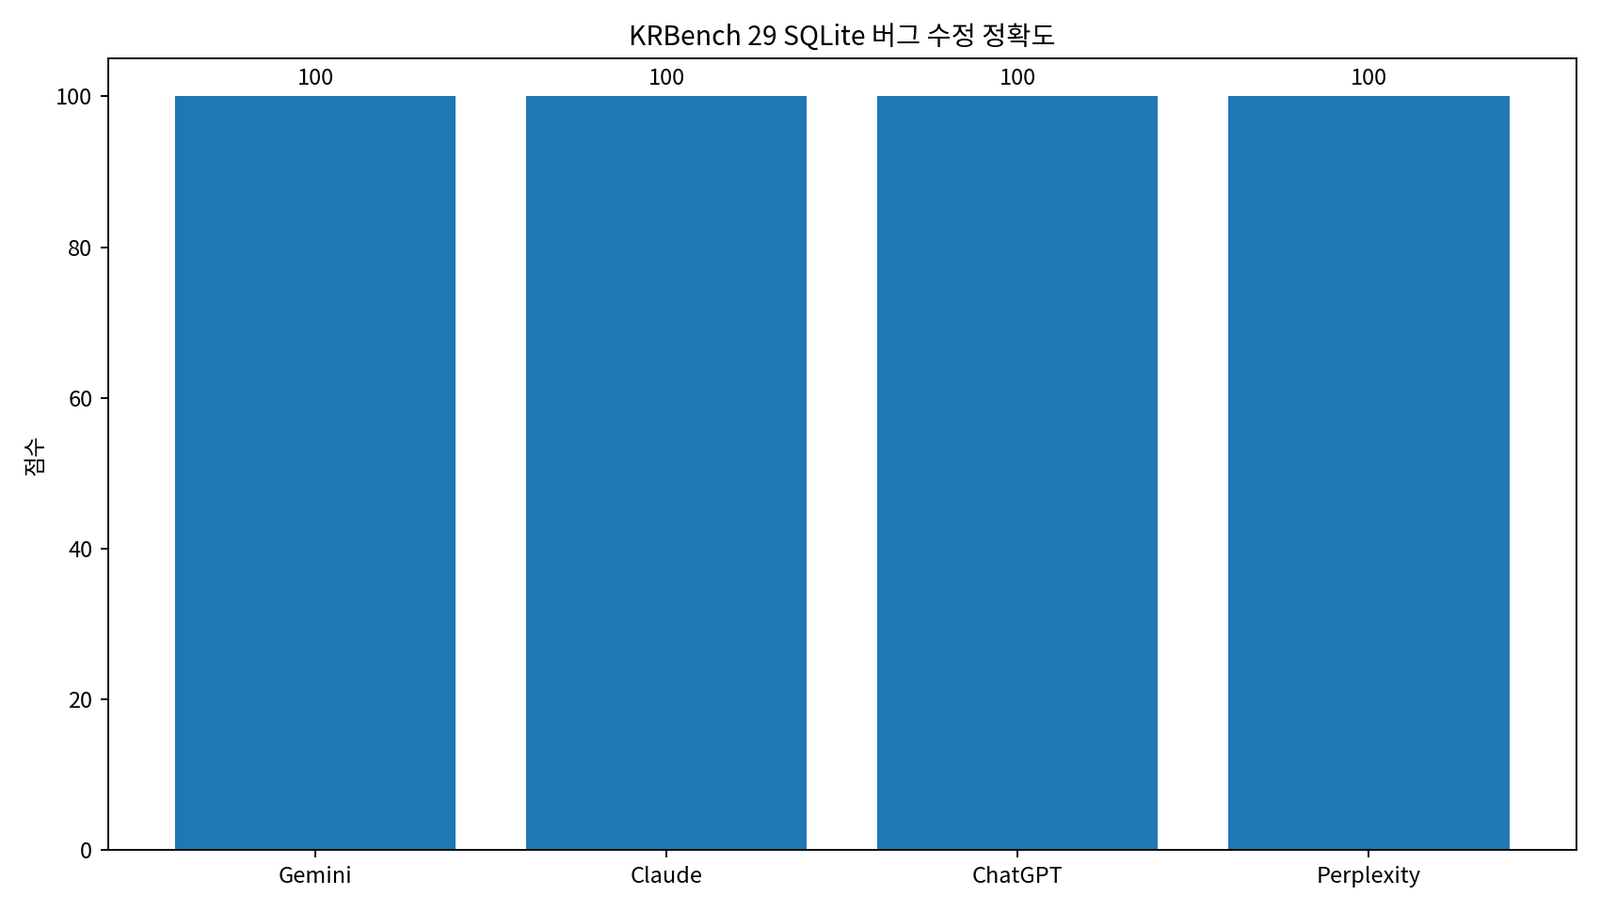
결과는 예상보다 단순했습니다. ChatGPT, Gemini, Claude, Perplexity 네 서비스가 모두 비공개 데이터셋 50개를 전부 통과해 100/100을 기록했습니다.
결과 요약
- Gemini Flash: 100/100 · 50/50 · 10초
- Claude Sonnet 5.5 · 중간: 100/100 · 50/50 · 12초
- ChatGPT: 100/100 · 50/50 · 21초
- Perplexity: 100/100 · 50/50 · 32초
테스트 방법: 결과값을 실제 SQLite에서 비교
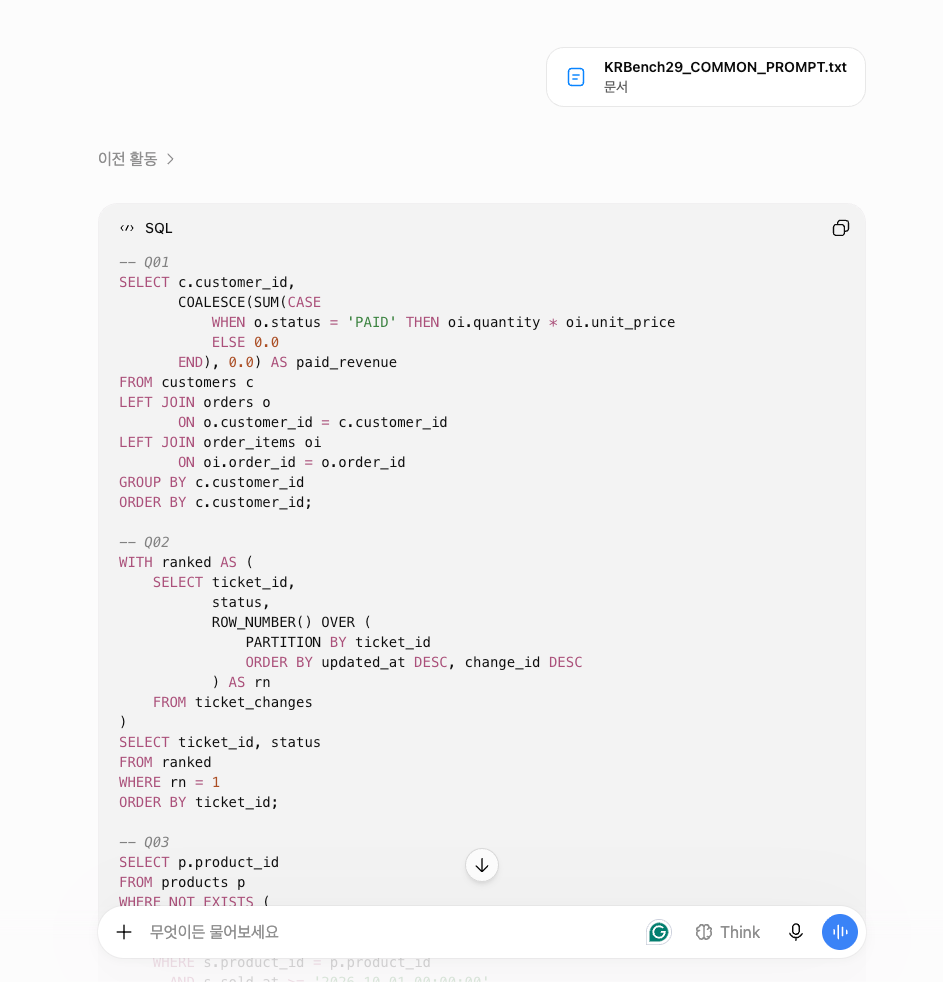
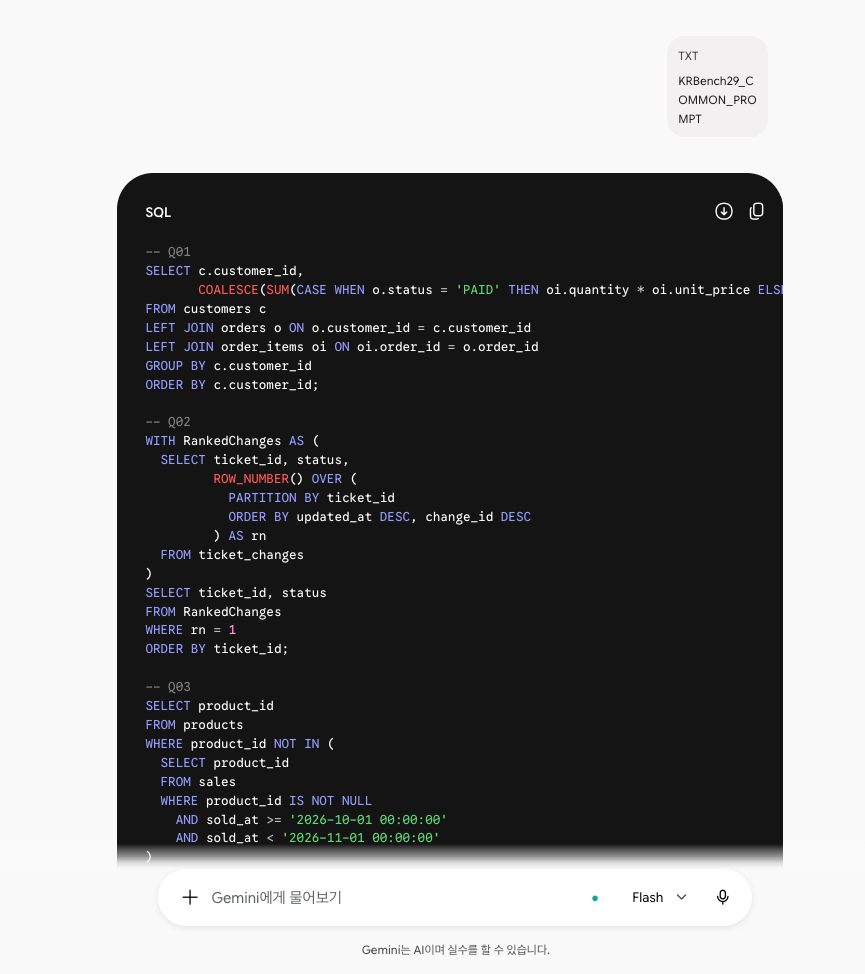
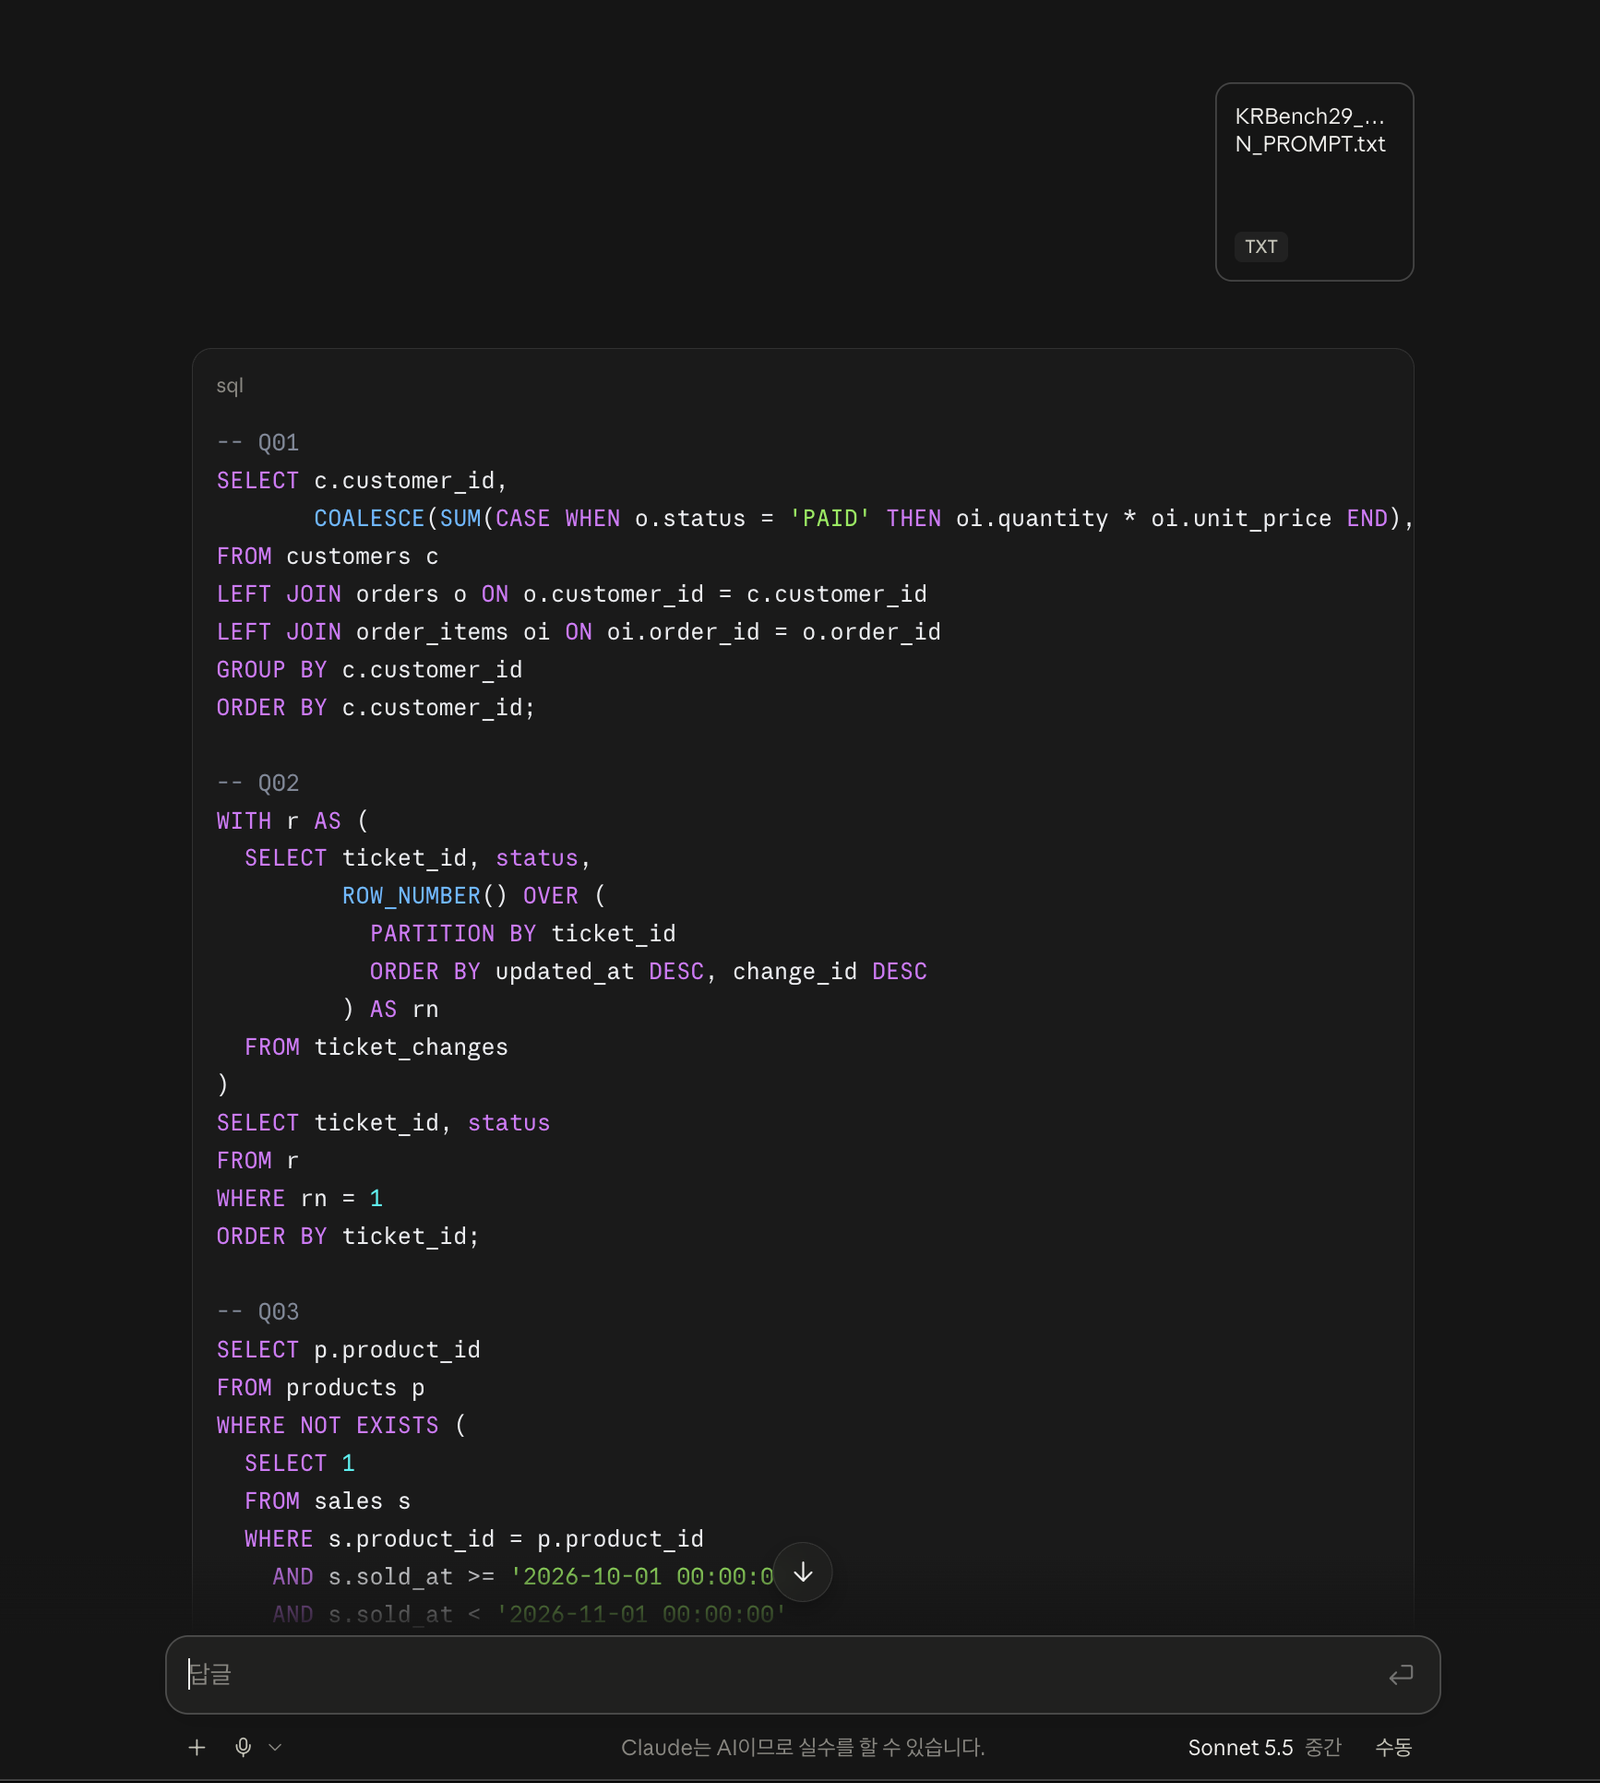
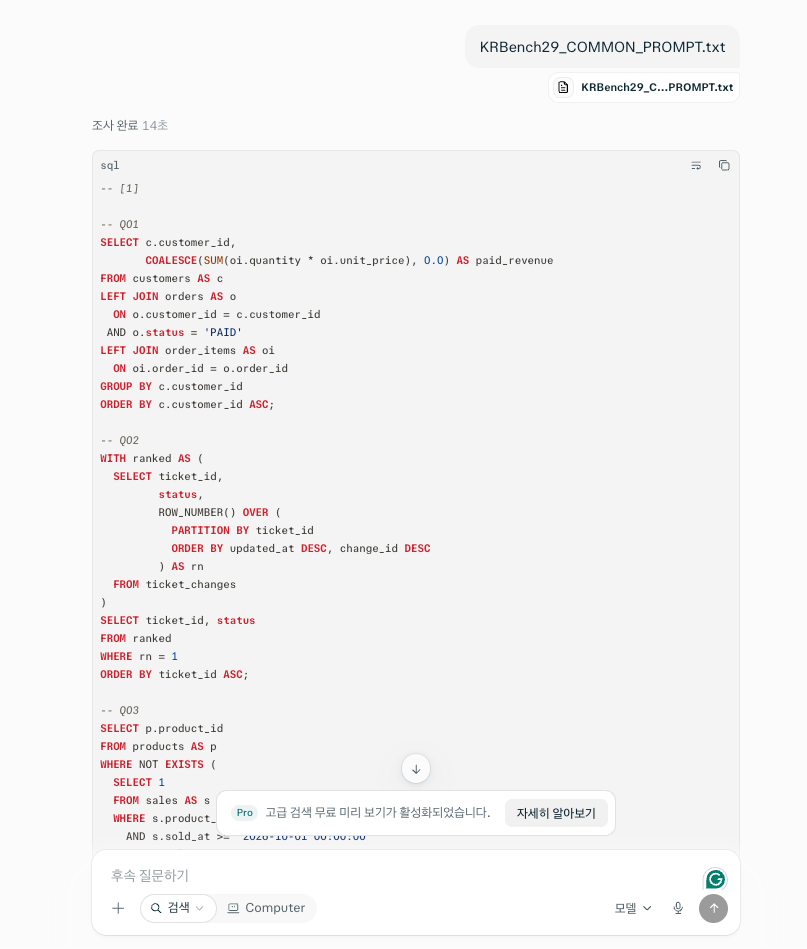
모든 서비스에 동일한 KRBench29_COMMON_PROMPT.txt 파일을 직접 첨부했습니다. 28호에서 긴 텍스트를 복사·붙여넣을 때 플랫폼이 입력을 자동 첨부파일로 바꾸는 사례가 있었기 때문에, 이번부터는 처음부터 파일 첨부 방식으로 통일했습니다.
문제는 서로 독립적인 SQL 10개입니다. 각 문제에는 스키마, 요구사항, 버그가 있는 현재 쿼리를 함께 제공했습니다. 서비스는 Q01~Q10의 수정 SQL만 하나의 코드블록으로 출력했습니다.
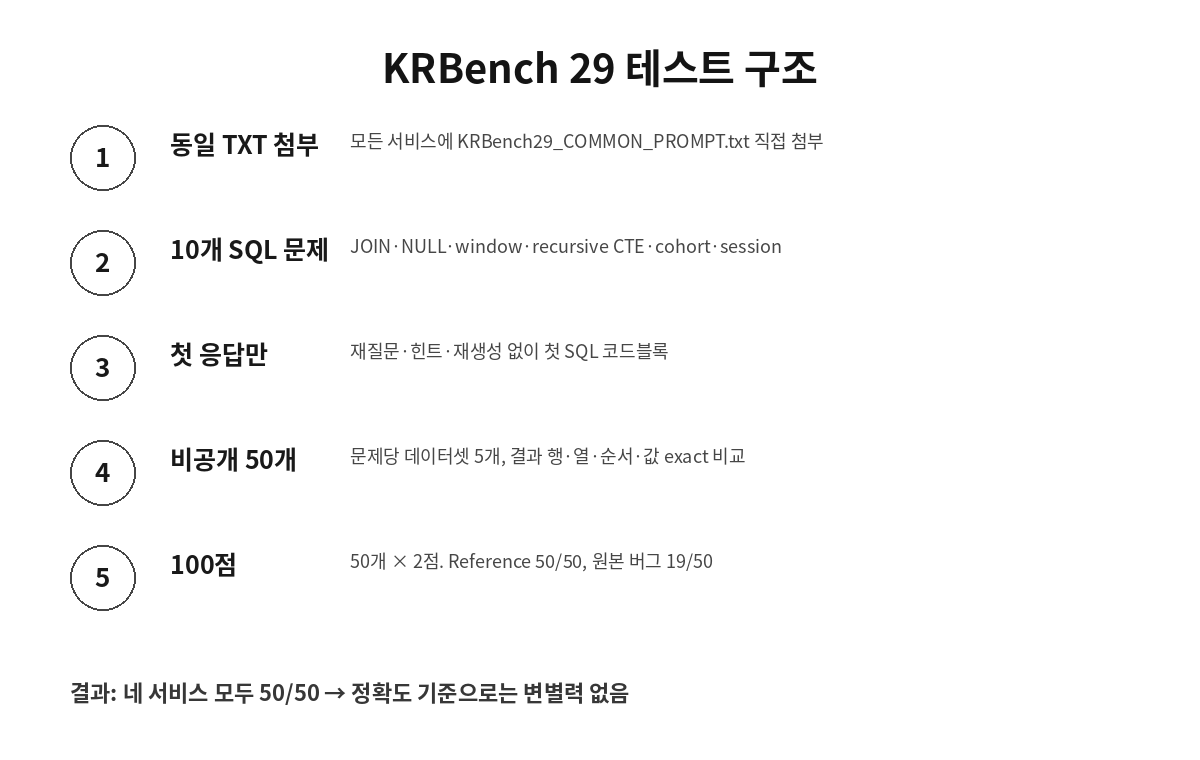
채점은 서비스 결과를 보기 전에 고정한 비공개 데이터셋 50개로 진행했습니다. 문제당 5개 데이터셋을 실제 SQLite에서 실행하고, 결과의 행·열·순서·값이 사전 reference 결과와 같을 때만 2점을 부여했습니다.
Reference 쿼리는 50/50, 수정 전 버그 쿼리는 19/50, 즉 38/100으로 사전 검증했습니다.
10개 SQL 문제에 무엇을 넣었나
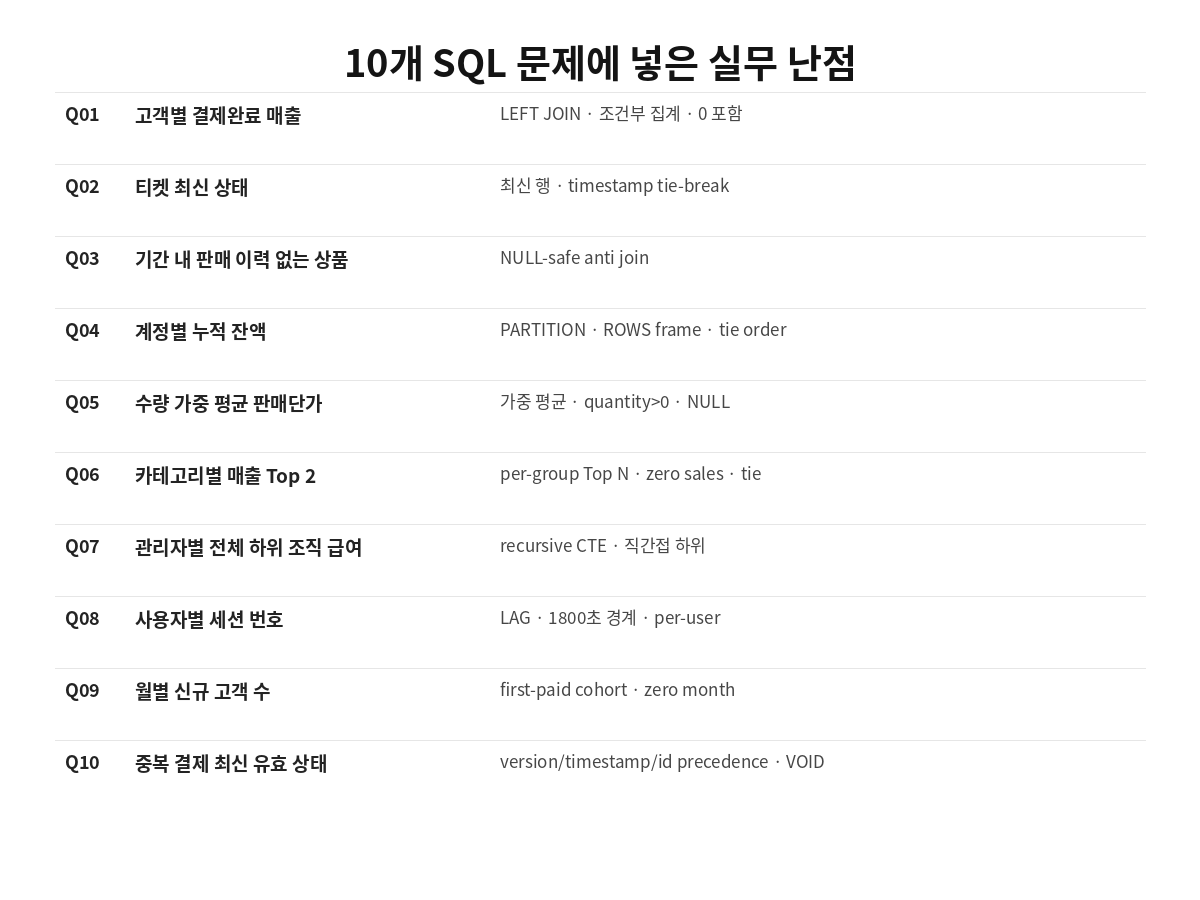
Q01은 결제완료 주문만 집계하면서 주문이 없는 고객도 0으로 남기는 LEFT JOIN 문제였습니다. Q02는 timestamp가 같을 때 change_id까지 사용해 최신 티켓 상태를 고르는 문제, Q03은 NULL이 있는 상태에서 안전한 anti join을 요구했습니다.
Q04~Q06에서는 계정별 window 누적합, 수량 가중 평균, 카테고리별 Top 2를 다뤘습니다. Q07은 recursive CTE로 모든 직·간접 하위 직원의 급여를 합산했고, Q08은 사용자별 30분 세션에서 정확히 1800초면 같은 세션이라는 경계를 넣었습니다.
Q09는 각 고객의 최초 PAID 주문 월만 신규 고객으로 계산하면서 주문이 없는 달도 0으로 출력하게 했고, Q10은 version·updated_at·event_row_id 우선순위로 최신 결제 이벤트를 고른 뒤 최신 상태가 VOID라면 과거 APPROVED를 되살리지 않게 했습니다.
네 서비스 모두 50/50
ChatGPT, Gemini, Claude, Perplexity는 구현 방식은 일부 달랐지만 비공개 데이터셋에서는 모두 같은 결과를 냈습니다.
예를 들어 Q03에서 ChatGPT·Claude·Perplexity는 NOT EXISTS를 사용했고 Gemini는 NOT IN을 유지하면서 서브쿼리에서 product_id IS NOT NULL을 추가했습니다. 구현은 달랐지만 숨은 데이터셋에서 요구한 NULL-safe 동작은 동일했습니다.
Q05 역시 Gemini는 CASE 기반으로 유효 수량만 합산했고 Claude·Perplexity는 LEFT JOIN 조건에 quantity > 0을 넣는 방식이었습니다. 결과는 모두 사전 reference와 일치했습니다.
응답시간은 달랐지만 속도로 승자를 정하지 않았다
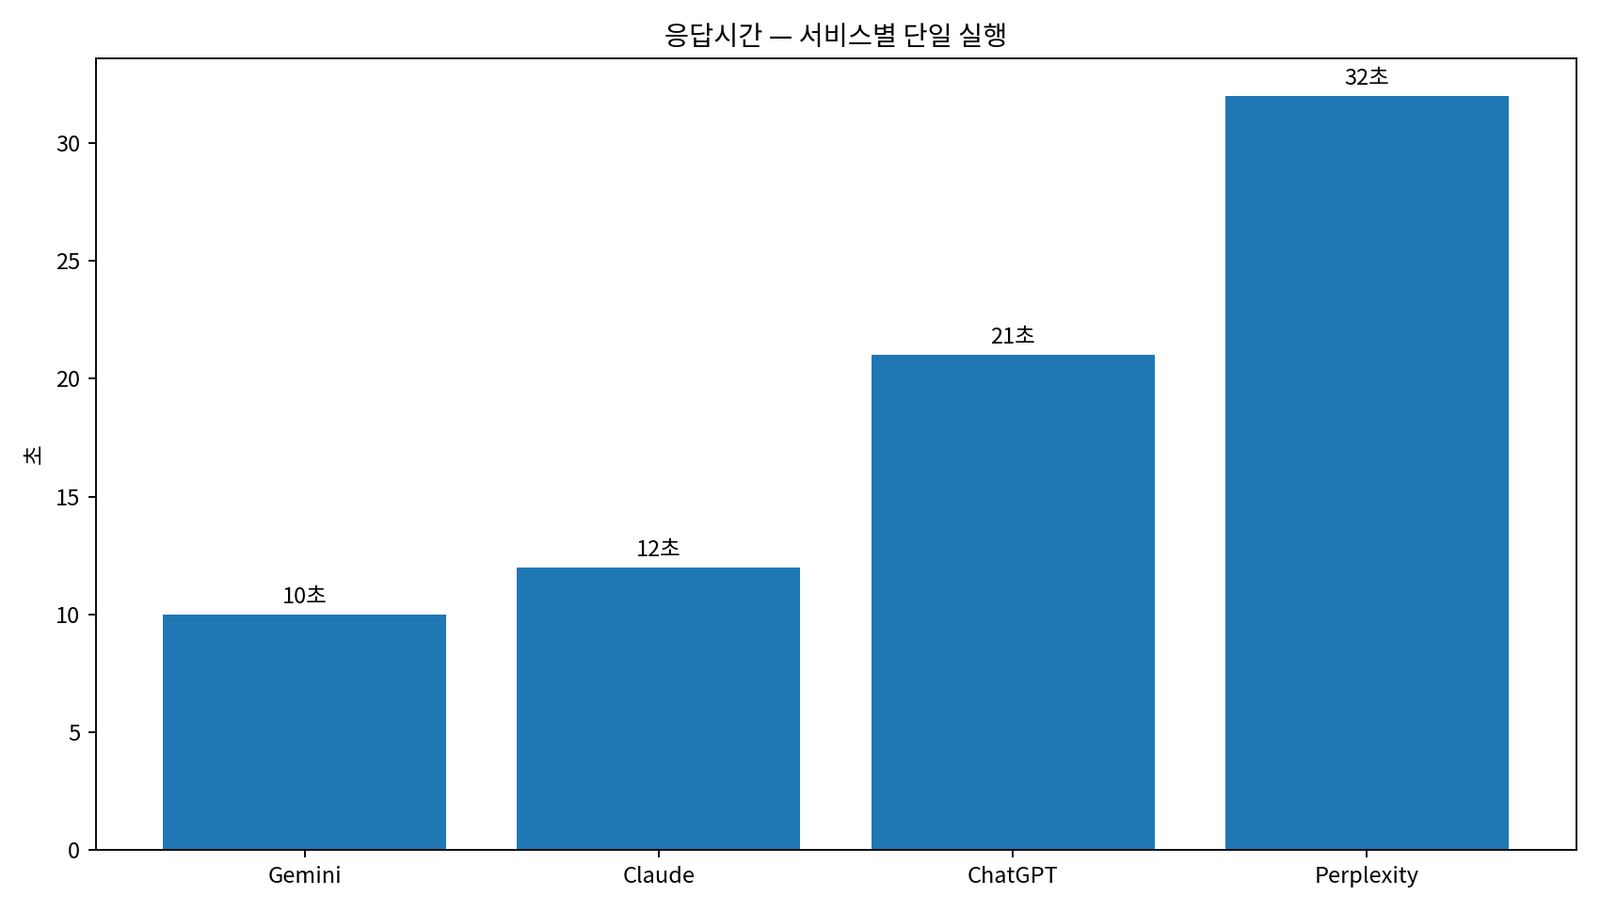
사용자가 직접 측정한 최종 응답시간은 Gemini 10초, Claude 12초, ChatGPT 21초, Perplexity 32초였습니다.
하지만 각 서비스에서 한 번만 측정한 값입니다. 서버 상태나 출력 속도 영향을 받을 수 있기 때문에 정확도가 모두 같다고 해서 이 시간을 근거로 일반적인 SQL 성능 순위를 만들지는 않았습니다.
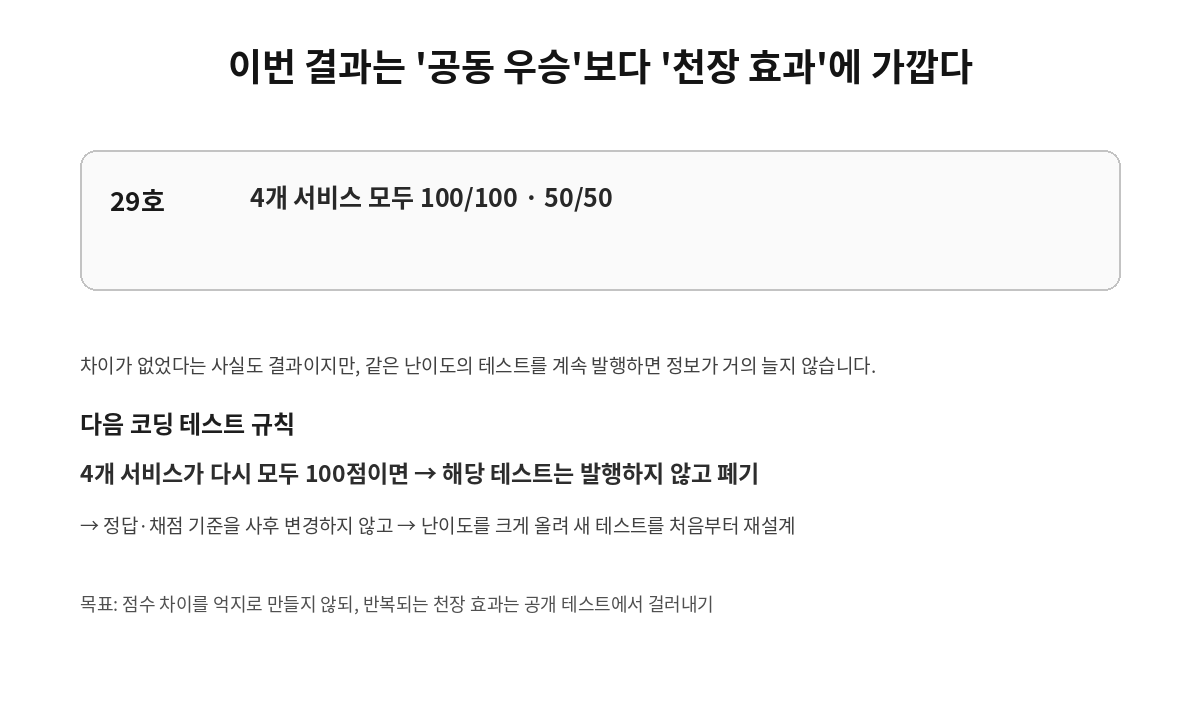
이번 결과의 핵심은 ‘공동 우승’보다 천장 효과
네 서비스가 모두 100점을 기록한 사실 자체는 공개할 가치가 있습니다. 같은 입력과 사전 고정 테스트에서 현재 서비스들이 이 정도의 SQLite 문제를 모두 해결했다는 실제 결과이기 때문입니다.
다만 KRBench의 목적은 점수표를 늘리는 것이 아니라 서비스 간 실제 차이가 어디에서 발생하는지 확인하는 것입니다. 이번 29호는 정확도 기준에서 차이가 전혀 없었으므로, 현재 모델을 구분하기에는 난이도가 부족했다고 보는 것이 맞습니다.
다음 테스트부터 적용할 폐기 규칙
29호는 첫 SQL 테스트이므로 천장 효과 자체를 결과로 공개합니다. 하지만 같은 일이 반복되면 정보 가치가 낮습니다.
다음 AI 코딩 정확도 테스트에서 ChatGPT·Gemini·Claude·Perplexity 네 서비스가 다시 모두 100점을 기록하면 해당 테스트는 블로그에 발행하지 않고 폐기합니다.
이때 점수 차이를 만들기 위해 이미 고정한 숨은 테스트나 배점을 바꾸지는 않습니다. 해당 테스트는 내부 기록으로만 남기고, 더 복잡한 상태·다중 파일·실행 환경·오류 전파처럼 난이도를 크게 올린 새 테스트를 처음부터 다시 설계합니다.
이번 테스트의 한계
- SQLite 단일 쿼리 문제이며 실제 애플리케이션의 ORM, migration, transaction, 동시성은 포함하지 않았습니다.
- 비공개 데이터셋 50개가 요구사항의 주요 경계를 검증했지만 모든 가능한 입력을 증명하는 것은 아닙니다.
- 네 서비스 모두 만점이므로 이번 테스트만으로 SQL 능력 차이를 판단할 수 없습니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
- 이번 결과를 반영해 다음 코딩 테스트는 난이도를 크게 높일 예정입니다.
이전 AI 코딩 정확도 테스트
28호 · Python 실무 유틸리티 버그 수정
10개 Python 기능과 비공개 테스트 50개로 실제 실행 정확도를 비교했습니다. Claude 100, Gemini 98, ChatGPT 90, Perplexity 0점이었습니다.
→ Python 버그 수정 정확도 비교 보기KRBench는 결과 차이를 만들기 위해 정답이나 숨은 테스트를 사후 변경하지 않습니다. 차이가 없으면 없는 그대로 기록하고, 반복되는 천장 효과는 다음 테스트 설계에서 해결합니다.