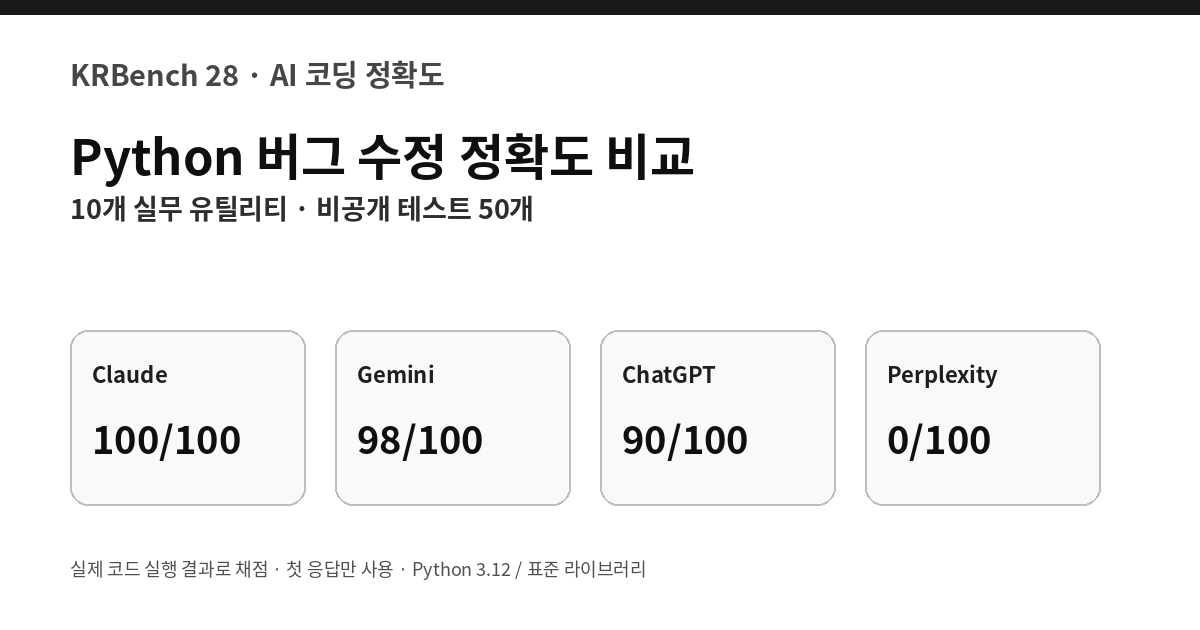
KRBench 28호부터는 새로운 AI 코딩 정확도 시리즈를 시작합니다. 이번에는 자연어 답을 사람이 읽어 채점하는 대신, AI가 수정한 Python 코드를 실제로 실행하고 사전에 고정한 비공개 테스트 결과로 점수를 계산했습니다.
테스트 대상은 interval merge, 최신 레코드 dedupe, JSON 스타일 merge patch, topological sort, rolling window, FIFO 재고 할당, 날짜 그룹, UTF-8 byte chunking, TTL+LRU cache, 사용자 sessionization까지 총 10개 실무형 유틸리티입니다.
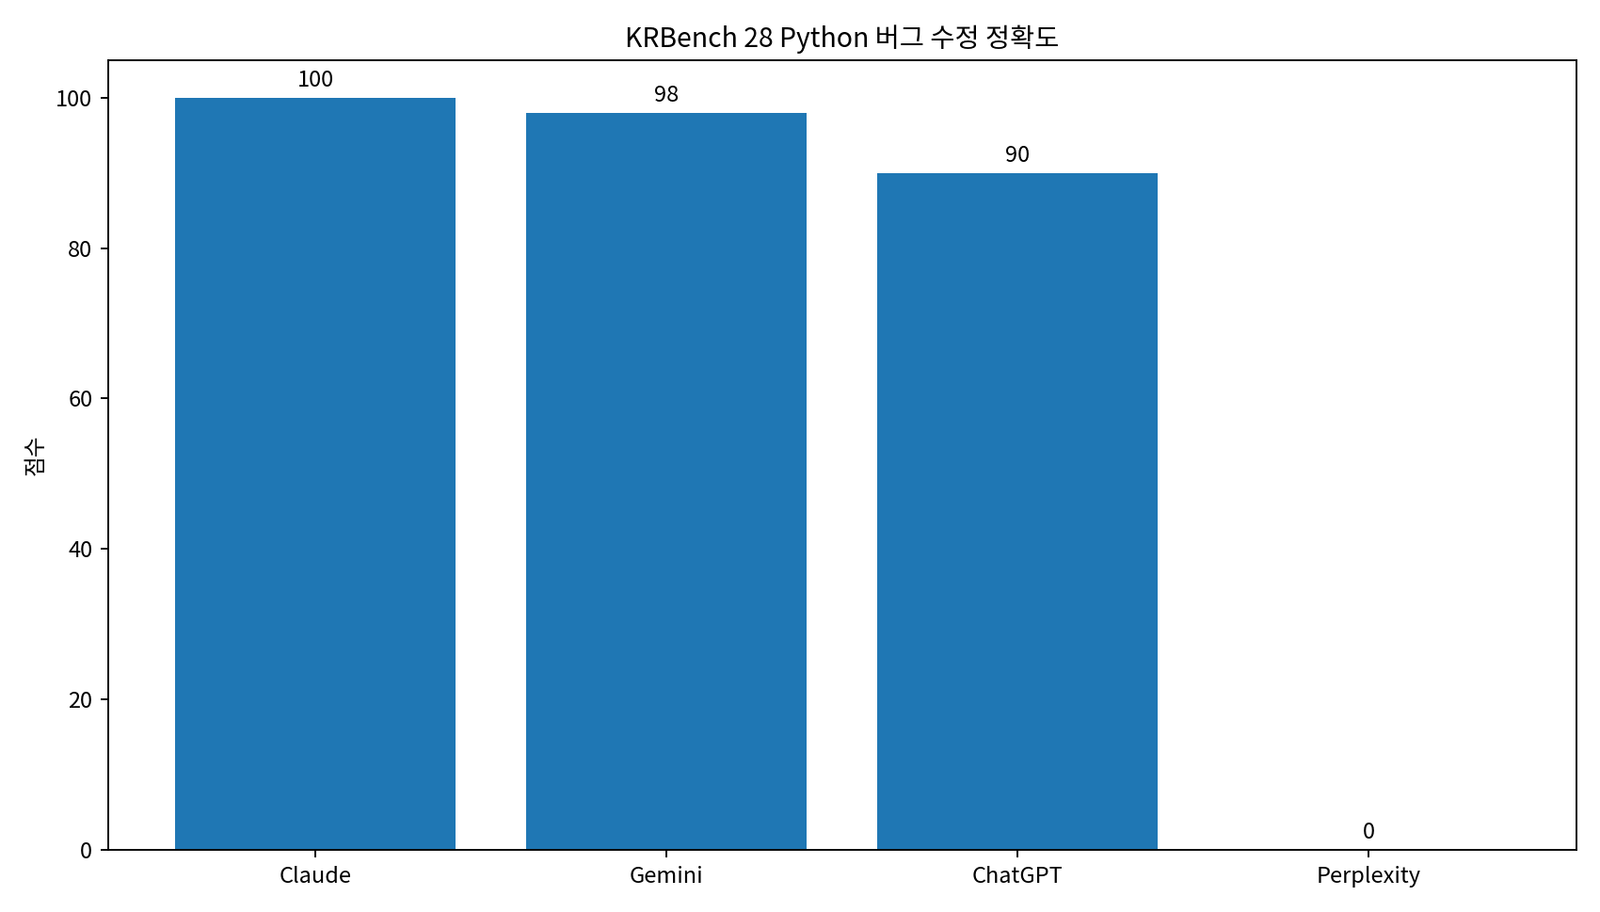
각 기능마다 숨은 테스트 5개를 만들었고, 1개 통과당 2점으로 총 100점입니다. 결과는 Claude 100점, Gemini 98점, ChatGPT 90점, Perplexity 0점이었습니다.
결과 요약
- Claude Sonnet 5.5 · 중간: 100/100 · 50/50 통과 · 26초
- Gemini Flash: 98/100 · 49/50 통과 · 15초
- ChatGPT: 90/100 · 45/50 통과 · 26초
- Perplexity: 0/100 · 모듈 import 실패 · 16초
테스트 방법: 10개 기능 × 숨은 테스트 5개
AI에게 제공한 것은 버그가 있는 Python 모듈과 각 함수·클래스의 docstring입니다. docstring에는 요구사항과 경계조건을 모두 적었고, 함수명·클래스명·공개 메서드명·매개변수 시그니처를 바꾸지 말도록 했습니다.
외부 패키지 설치와 네트워크 사용은 금지했고 Python 3.12 표준 라이브러리만 허용했습니다. 각 서비스는 수정된 전체 모듈을 코드블록 하나로 제출해야 했습니다.
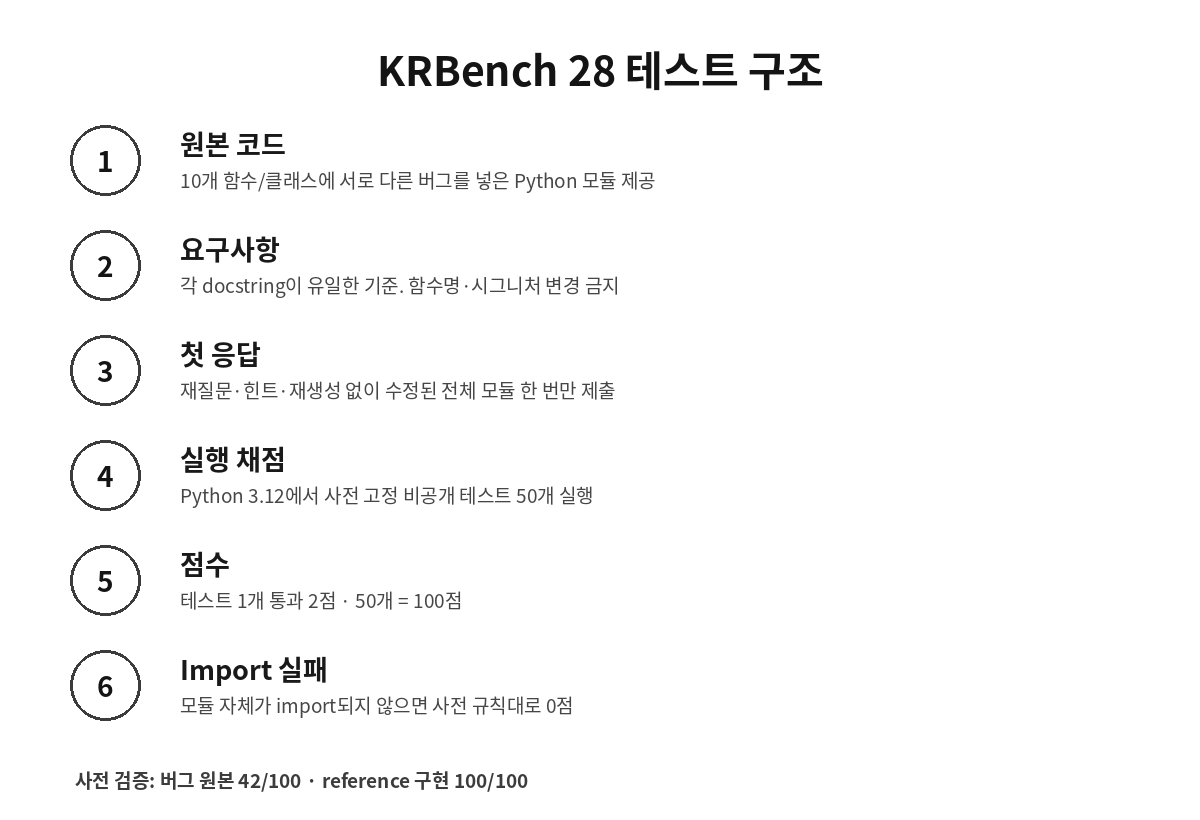
비공개 테스트는 서비스 결과를 보기 전에 50개로 고정했습니다. 테스트 1개 통과당 2점이고, 모듈 자체가 import되지 않으면 실행 가능한 테스트가 없으므로 0점이라는 규칙도 사전에 정했습니다.
사전 검증에서는 버그 원본 그대로가 42/100, reference 구현이 100/100이었습니다. 즉 기본 코드가 일부 평범한 입력은 처리하지만, 경계·상태·순서·비변형성·Unicode 조건에서는 충분히 차이가 나도록 구성했습니다.
긴 프롬프트는 TXT 파일로 통일
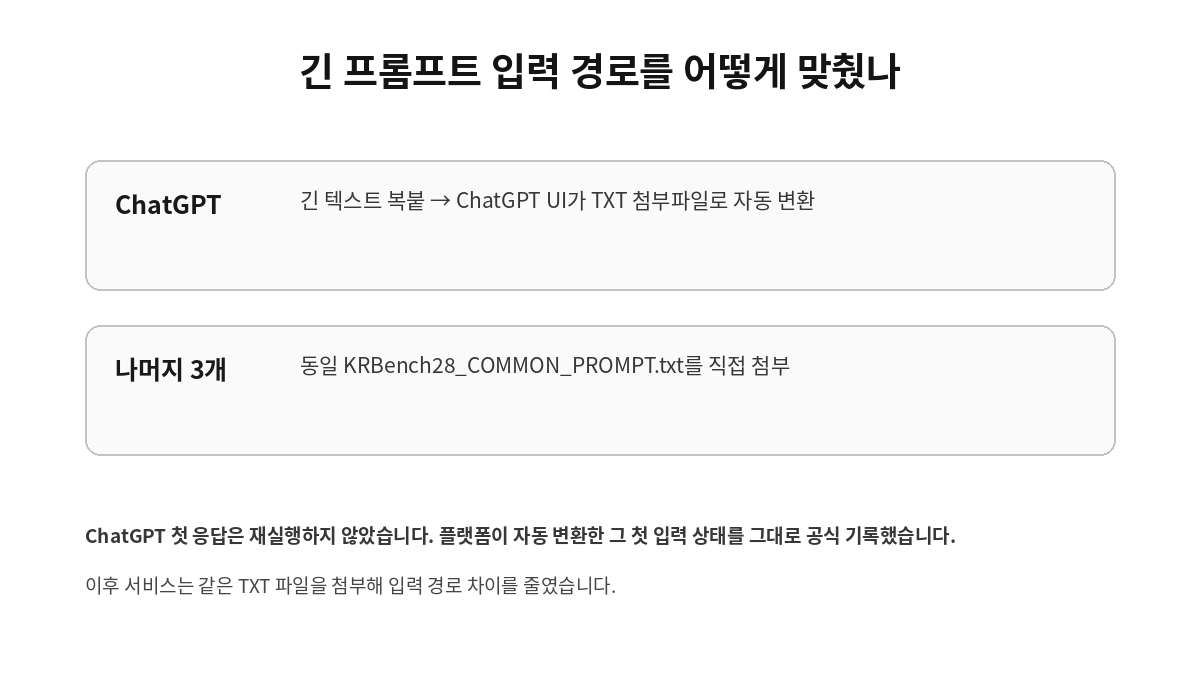
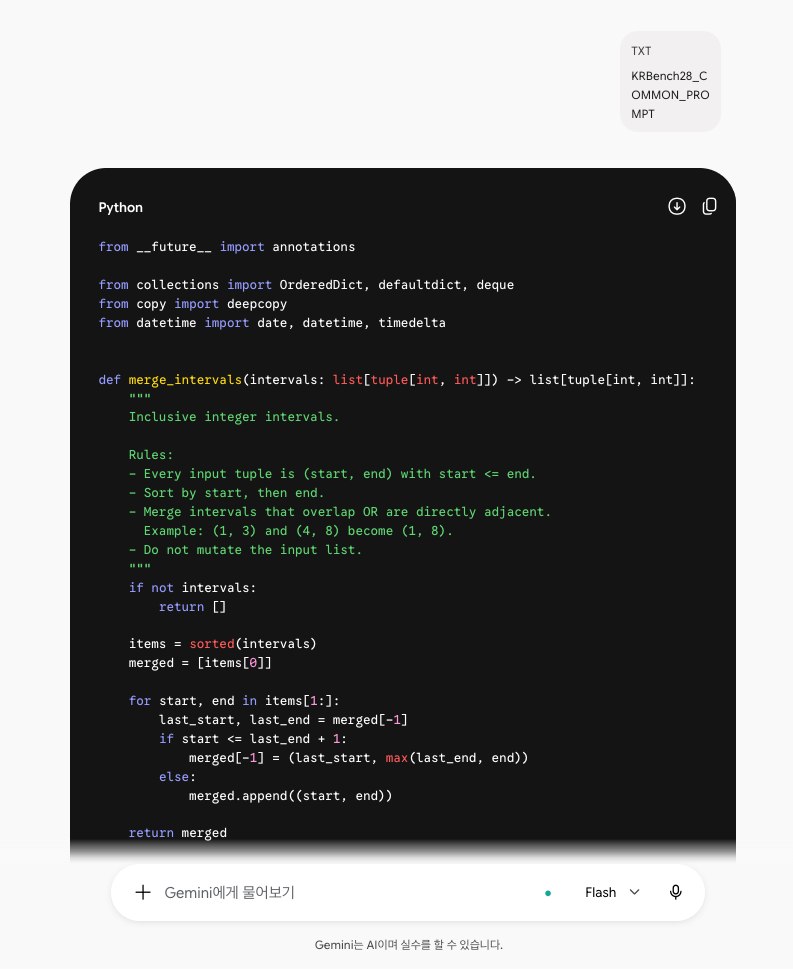
이번 테스트에는 입력 방식과 관련된 기록이 하나 있습니다. ChatGPT에 긴 공통 프롬프트를 텍스트로 붙여넣자, ChatGPT 웹 UI가 해당 내용을 자동으로 TXT 첨부파일로 전환했습니다.
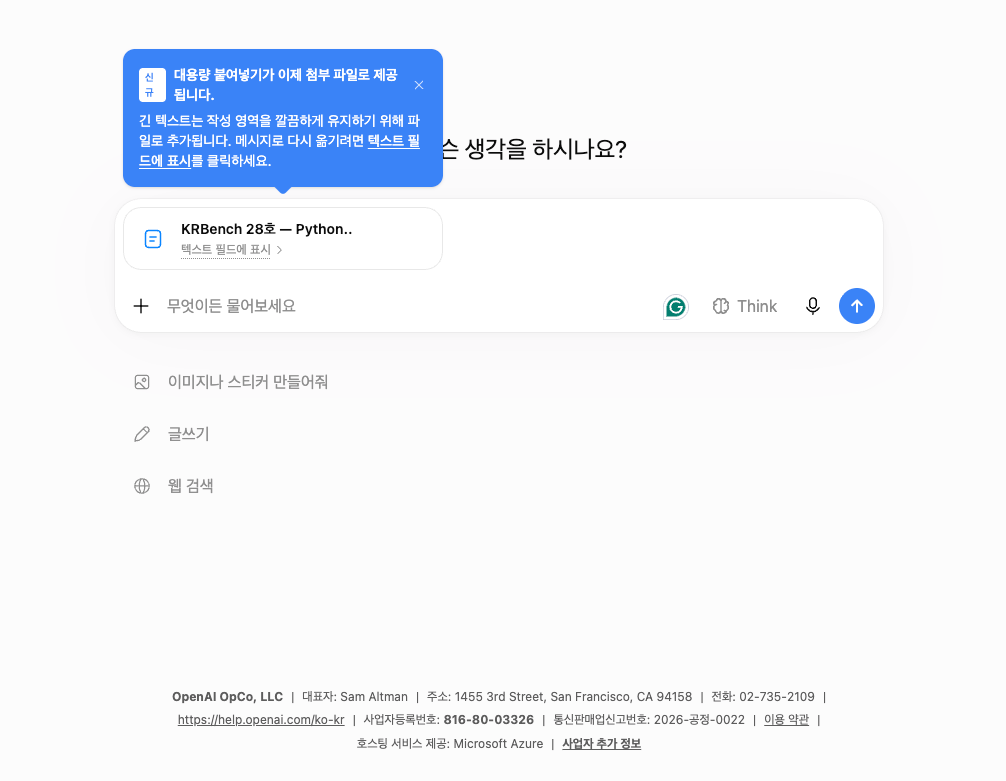
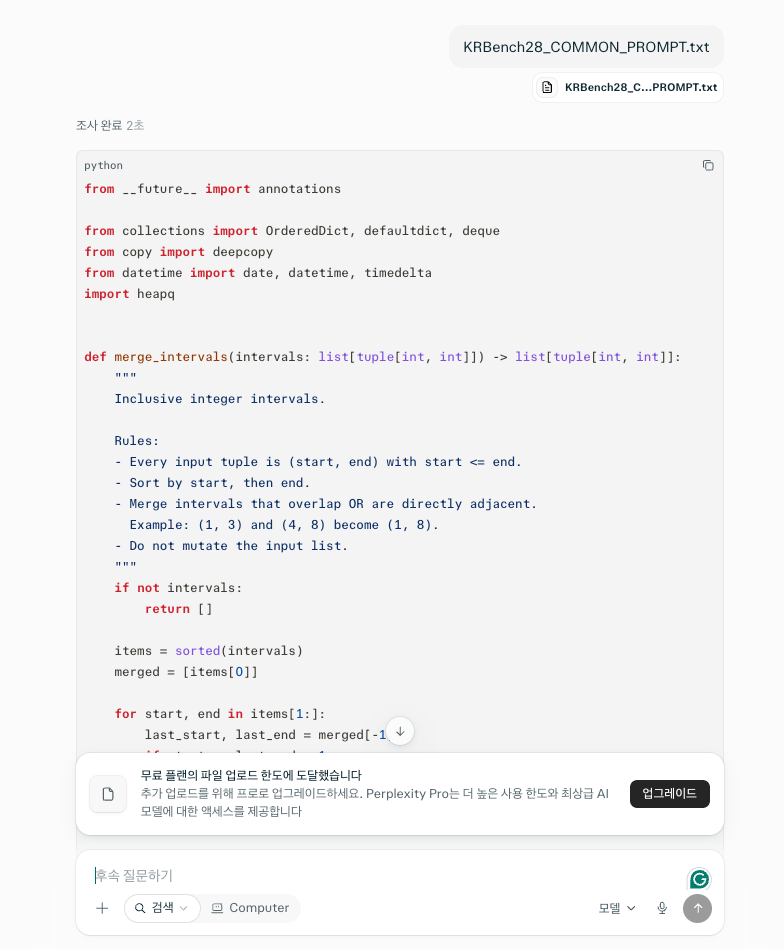
KRBench는 이 상태에서 ChatGPT를 재실행하지 않고 첫 응답을 그대로 공식 결과로 사용했습니다. 이후 입력 경로 차이를 줄이기 위해 Gemini, Claude, Perplexity에는 같은 KRBench28_COMMON_PROMPT.txt 파일을 직접 첨부했습니다.
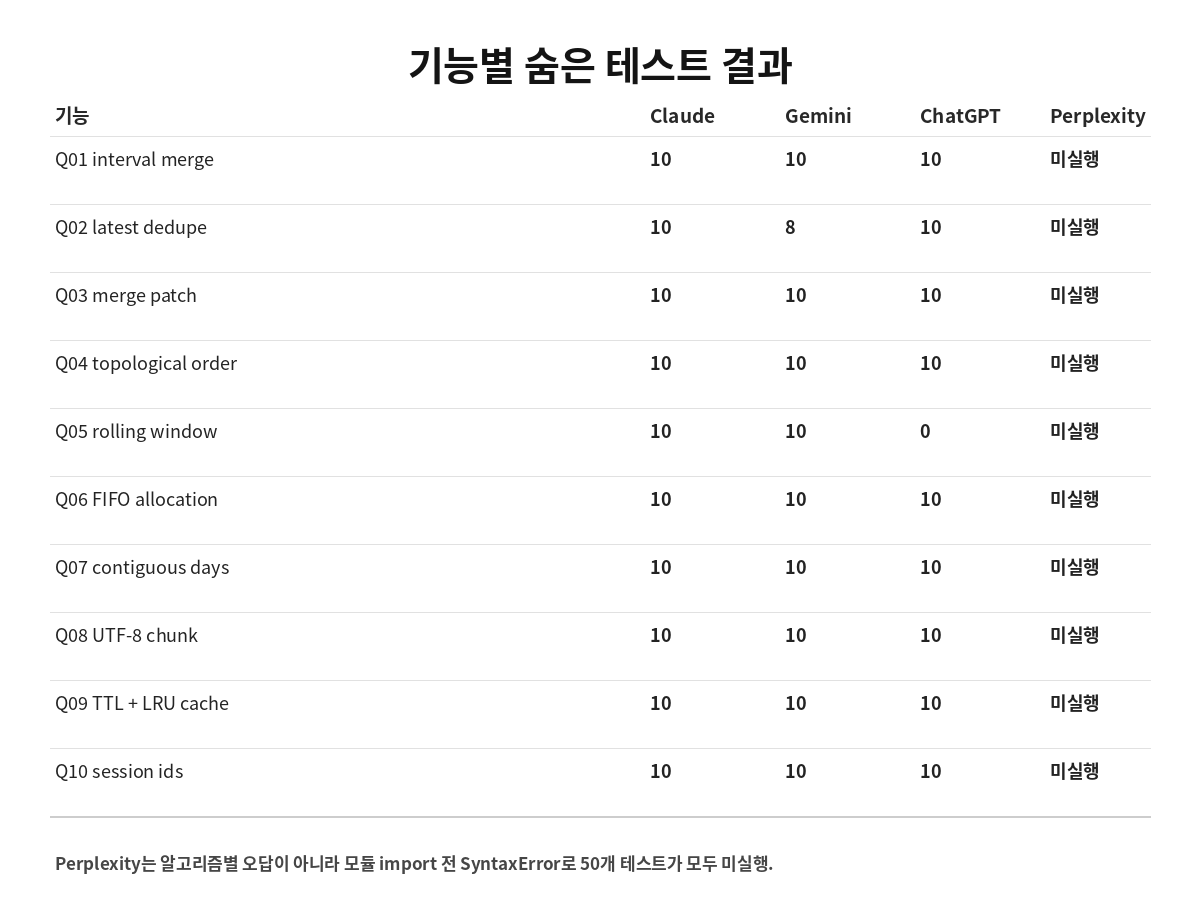
기능별 결과
| 기능 | Claude | Gemini | ChatGPT | Perplexity |
|---|---|---|---|---|
| Q01 merge_intervals | 10/10 | 10/10 | 10/10 | 미실행 |
| Q02 dedupe_latest | 10/10 | 8/10 | 10/10 | 미실행 |
| Q03 apply_merge_patch | 10/10 | 10/10 | 10/10 | 미실행 |
| Q04 stable_topological_order | 10/10 | 10/10 | 10/10 | 미실행 |
| Q05 rolling_window_counts | 10/10 | 10/10 | 0/10 | 미실행 |
| Q06 allocate_fifo | 10/10 | 10/10 | 10/10 | 미실행 |
| Q07 group_contiguous_days | 10/10 | 10/10 | 10/10 | 미실행 |
| Q08 chunk_utf8 | 10/10 | 10/10 | 10/10 | 미실행 |
| Q09 TTLCache | 10/10 | 10/10 | 10/10 | 미실행 |
| Q10 session_ids | 10/10 | 10/10 | 10/10 | 미실행 |
Claude 100점: 50개 테스트 전부 통과
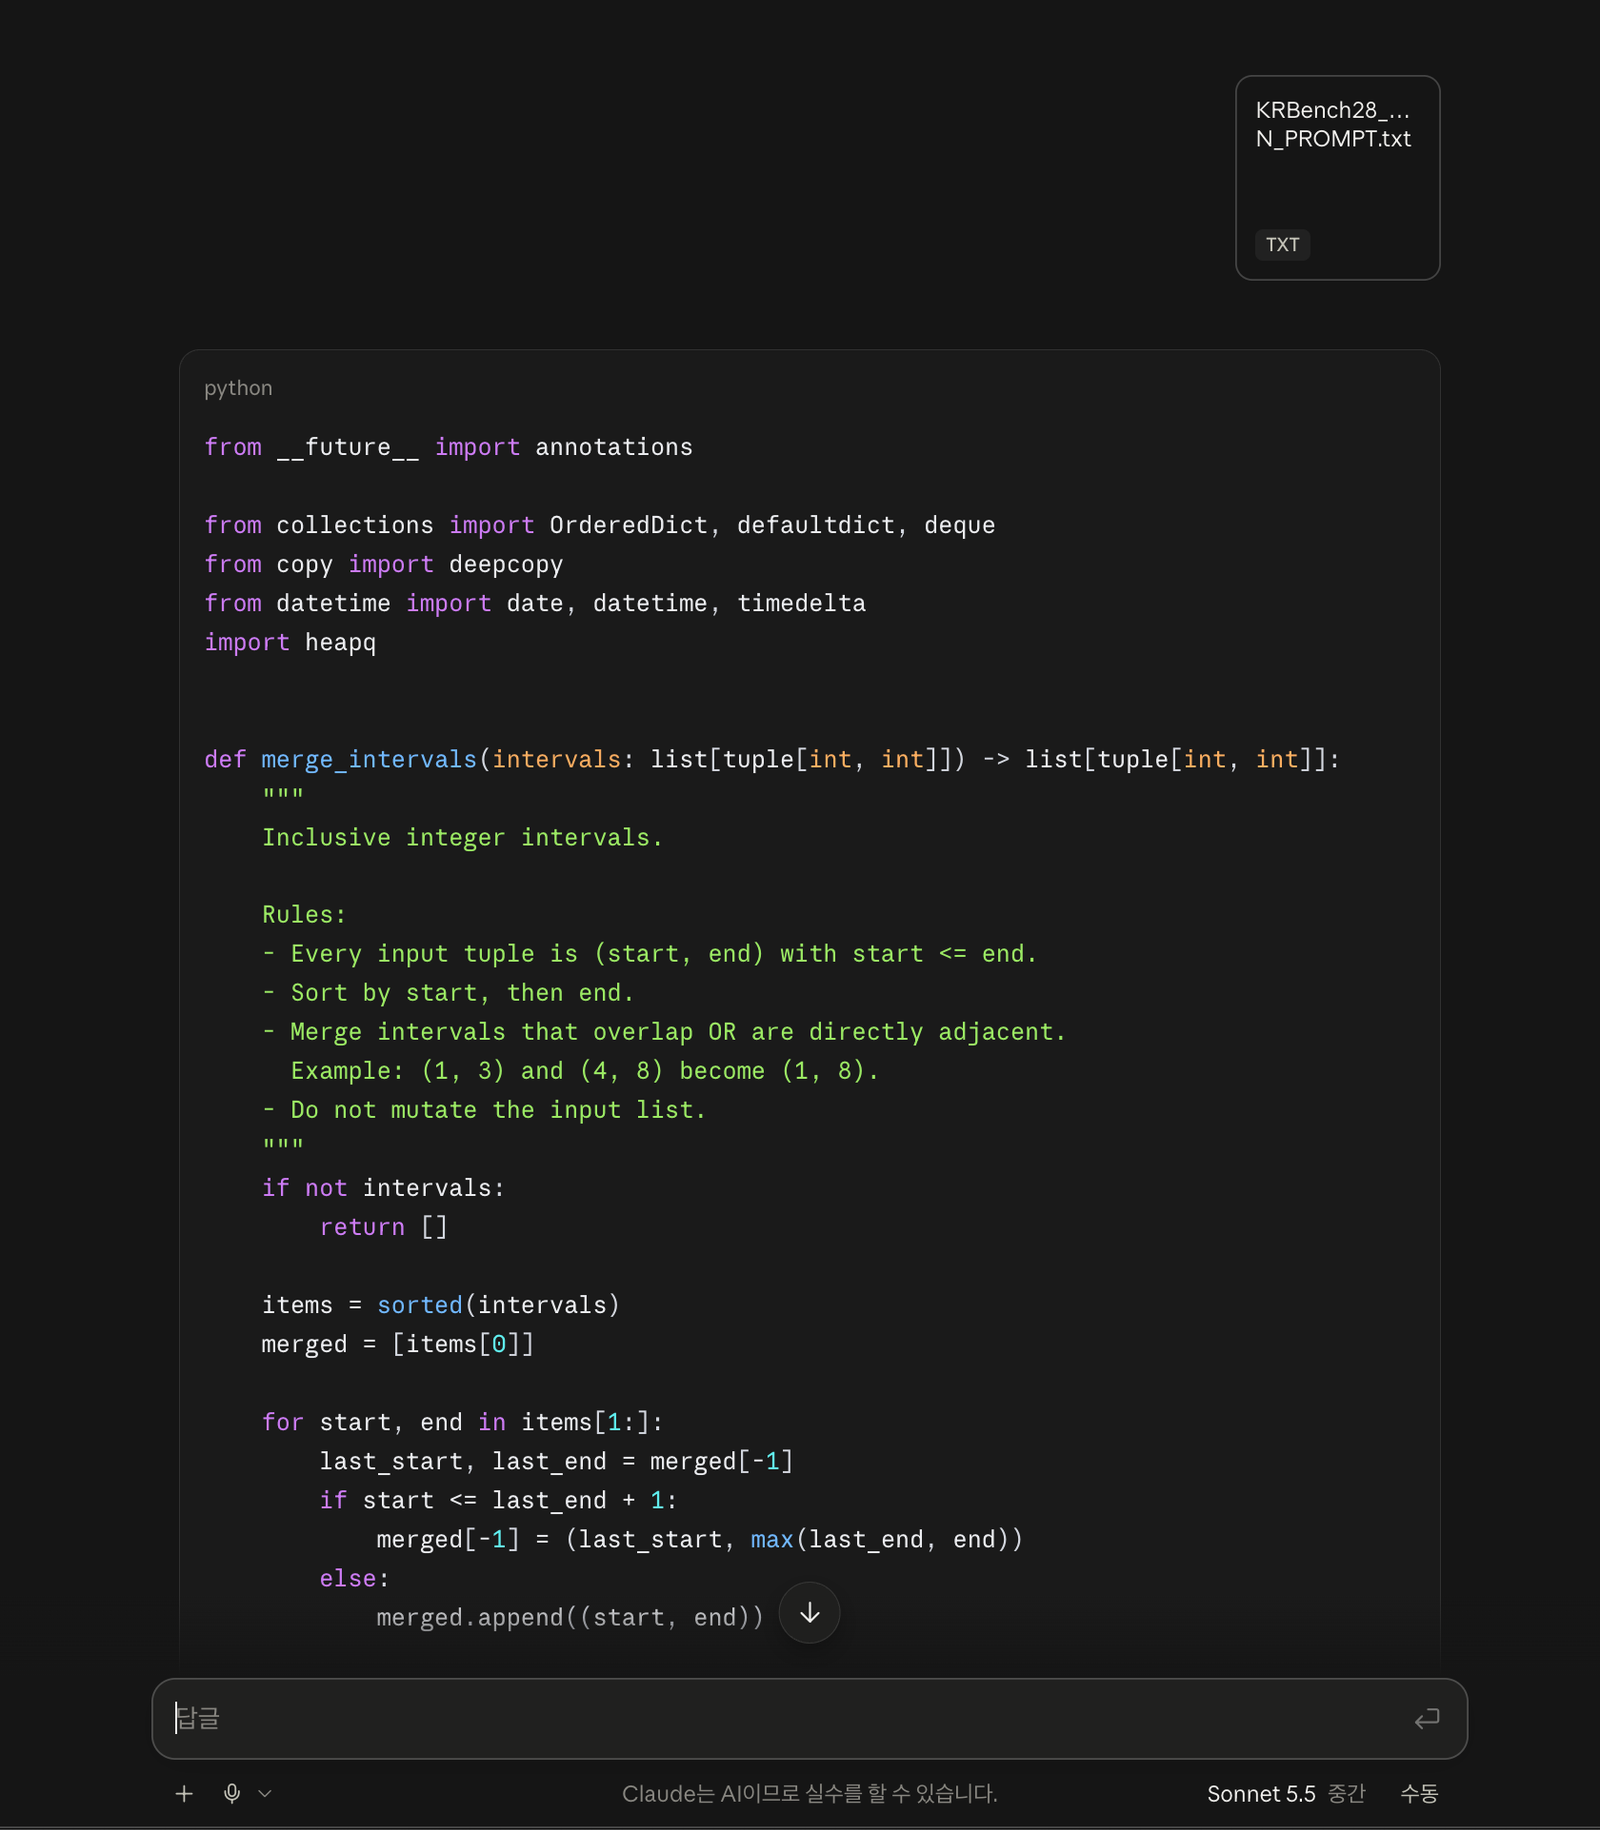
Claude Sonnet 5.5 · 중간은 10개 기능에서 비공개 테스트 50개를 모두 통과했습니다.
직접 인접 interval 병합, 동일 timestamp에서 뒤 레코드 우선, duplicate edge 제거, key별 rolling window, 여러 요청이 공유하는 FIFO lot 잔량, Unicode byte 경계, TTL과 LRU의 상호작용, 원래 입력 순서를 복원하는 sessionization까지 사전 테스트와 모두 일치했습니다.
Gemini 98점: shallow copy 한 건
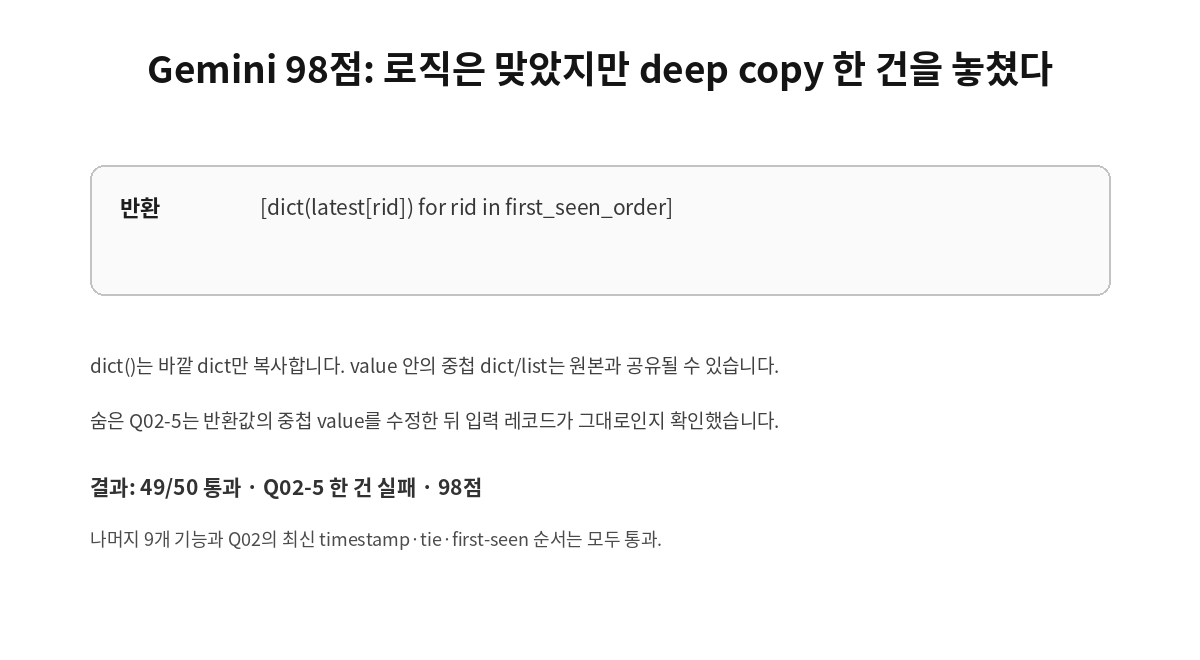
Gemini Flash는 50개 중 49개를 통과했습니다. 유일한 실패는 Q02 dedupe_latest의 입력 비변형성 테스트였습니다.
Gemini는 최신 timestamp 선택, 동일 timestamp 시 나중 occurrence 우선, ID의 first-seen 출력 순서를 모두 맞혔습니다. 하지만 반환 레코드를 dict(...)로 얕게 복사했습니다.
따라서 value 안에 중첩 dict나 list가 있을 때 반환값의 중첩 객체를 수정하면 입력 레코드 내부 객체까지 함께 바뀔 수 있습니다. 숨은 Q02-5는 이 조건을 검사했고 한 건이 실패했습니다.
ChatGPT 90점: deque import 누락
ChatGPT는 10개 기능 가운데 9개를 전부 통과했지만 Q05 rolling_window_counts에서 5개 테스트가 모두 실패했습니다.
원인은 알고리즘보다 단순했습니다. 함수 내부에서는 defaultdict(deque)를 사용했지만 상단 import에는 deque가 없었습니다. 그 결과 Q05가 호출될 때마다 NameError가 발생했습니다.
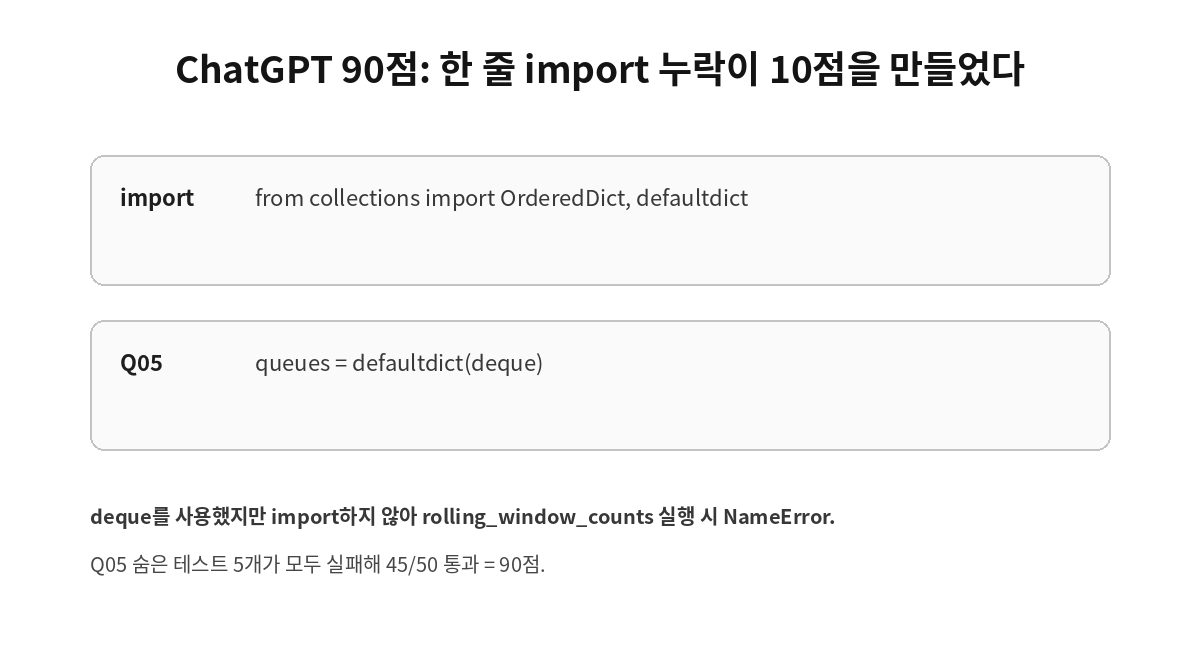
이 사례는 코드 생성에서 작은 import 한 줄이 전체 기능의 실행 가능성을 바꿀 수 있다는 점을 보여줍니다. Q05 5개가 모두 실패해 10점이 빠졌지만 다른 45개 테스트는 통과했습니다.
Perplexity 0점: 알고리즘 오답이 아니라 첫 제출물이 실행되지 않았다
Perplexity 결과는 점수만 보면 오해하기 쉽습니다. 50개 알고리즘 테스트를 하나씩 실행해서 모두 틀린 것이 아닙니다.
KRBench가 보관한 첫 응답 전체 텍스트의 후반부에서 session_ids 정렬 코드 안에 첨부파일 URL이 포함되어 있었습니다. 이 저장본을 수정하지 않고 Python 모듈로 import했을 때 SyntaxError: invalid decimal literal이 발생했습니다.
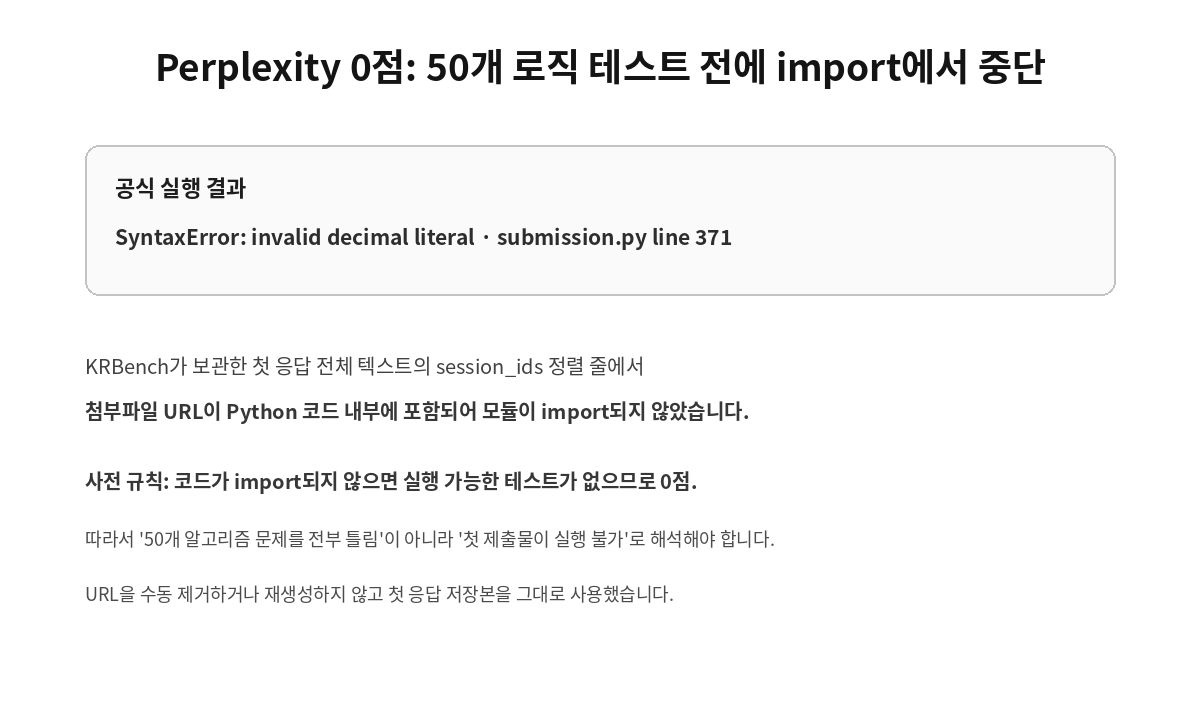
사전에 정한 규칙은 “코드가 import되지 않으면 실행 가능한 테스트가 없으므로 0점”이었습니다. 따라서 URL을 수동으로 지우거나 다시 생성하지 않고 첫 응답 저장본을 그대로 0점 처리했습니다.
즉 이번 0점은 Python 로직 10개를 모두 틀렸다는 의미가 아니라, 제출한 전체 모듈이 실행 가능한 코드가 아니었다는 의미입니다.
응답시간: 15초부터 26초
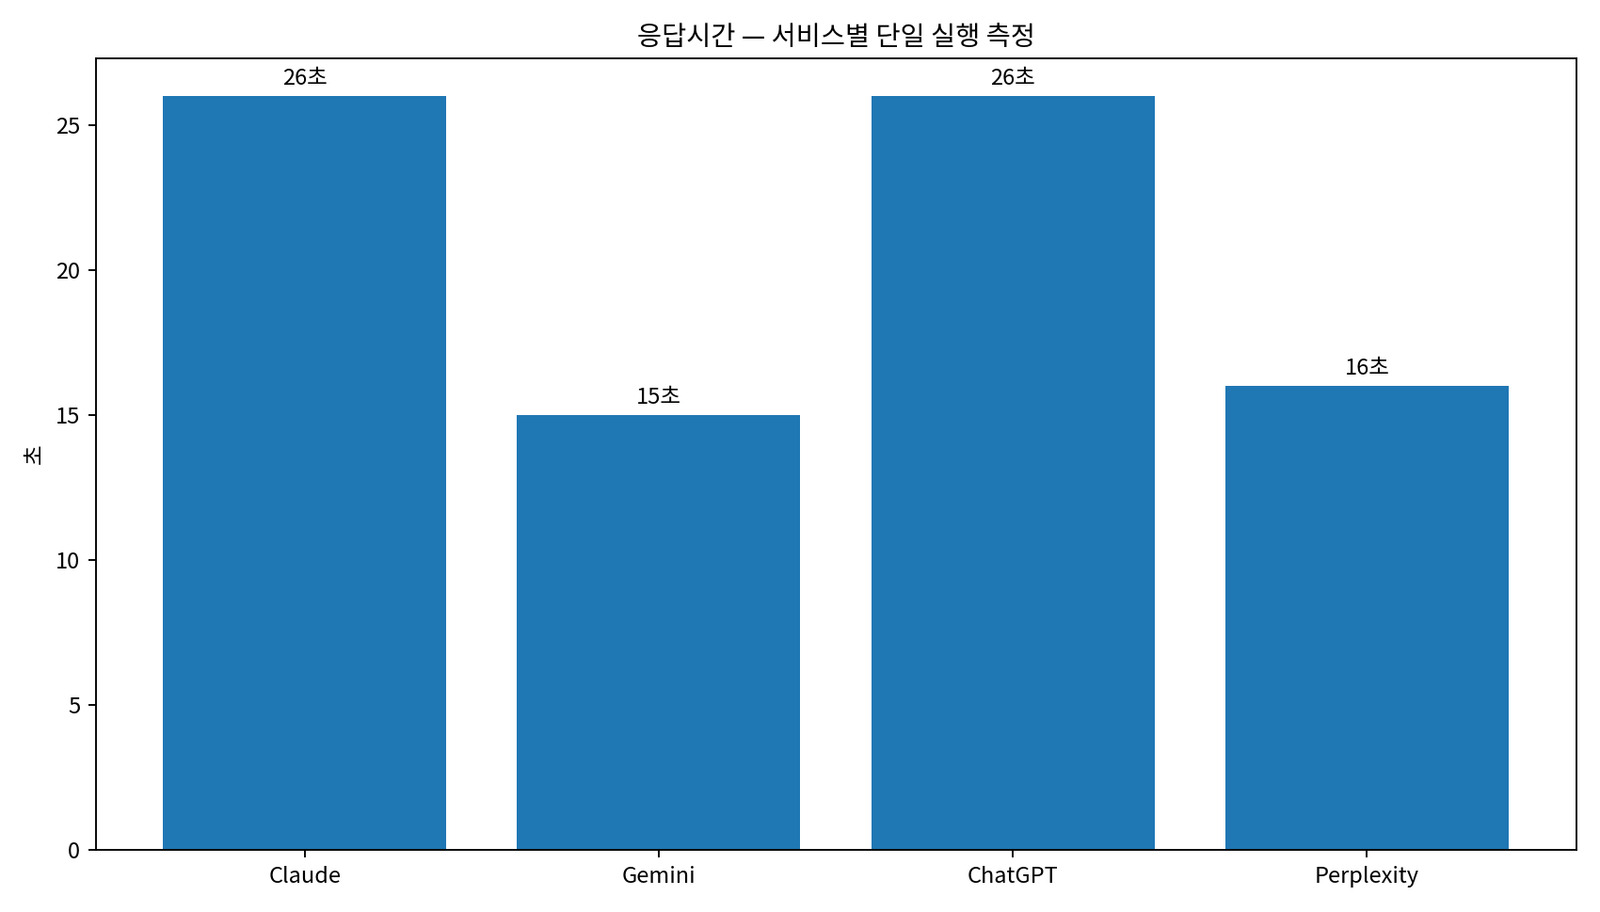
사용자가 직접 측정한 최종 코드 출력 시간은 Gemini 15초, Perplexity 16초, Claude 26초, ChatGPT 26초였습니다. 각 서비스에서 한 번만 측정한 값이므로 일반적인 속도 순위로 확대하지 않습니다.
이번 테스트에서 확인된 점
첫째, 코딩 정확도는 자연어 설명보다 실행 결과로 평가했을 때 오류가 더 명확해졌습니다. Gemini의 shallow copy나 ChatGPT의 import 누락은 코드만 훑어보면 지나칠 수 있지만 숨은 테스트에서는 즉시 드러났습니다.
둘째, 경계조건뿐 아니라 입력 비변형성과 상태 유지도 중요했습니다. TTL cache, FIFO lot 소진, 사용자별 session 정렬처럼 한 번의 상태 변경이 뒤 결과에 영향을 주는 기능은 자연어 업무 벤치마크의 HARD 구간과 비슷한 난점을 가졌습니다.
셋째, 실제 코딩 업무에서는 알고리즘 정답뿐 아니라 모듈 전체가 실행 가능한지도 정확도의 일부입니다. 이번에는 Perplexity에서 그 차이가 가장 극단적으로 나타났습니다.
이번 테스트의 한계
- 실제 오픈소스 프로젝트가 아니라 KRBench가 만든 단일 Python 모듈입니다.
- 10개 기능은 모두 표준 라이브러리 수준의 유틸리티이며 웹 프레임워크, DB, 비동기 I/O, 패키지 의존성은 포함하지 않았습니다.
- 50개 숨은 테스트는 경계조건을 다양하게 넣었지만 모든 가능한 입력을 검증하지는 않습니다.
- ChatGPT의 긴 프롬프트는 플랫폼 UI가 자동으로 TXT 첨부로 변환했고, 나머지 서비스는 동일 파일을 직접 첨부했습니다.
- Perplexity 0점은 보관한 첫 응답 전체 텍스트를 그대로 실행한 결과이며, URL을 제거했을 때의 잠재적 알고리즘 성능은 공식 점수에 포함하지 않았습니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
이전 KRBench 시리즈
AI 업무 정확도 15개 테스트 최종결산
복수 문서 근거 추적부터 급여·데이터 Lineage까지 11~25호 업무 테스트 전체 결과와 반복 오류를 정리했습니다.
→ 업무 정확도 시리즈 최종결산 보기Python 다음은 SQLite 실무 쿼리 10개를 실제 데이터로 실행했습니다.
JOIN, NULL, window function, recursive CTE, 세션·cohort·최신 이벤트를 비공개 데이터셋 50개로 채점했고 네 서비스가 모두 100점을 기록했습니다.
→ AI SQLite 쿼리 버그 수정 정확도 비교 보기KRBench는 결과를 본 뒤 정답이나 숨은 테스트를 바꾸지 않습니다. 같은 입력, 첫 응답, 사전 고정 테스트를 기준으로 실제 실행 결과를 기록합니다.