계약 청구 업무에서는 현재 계약 조건만 읽는 것으로 끝나지 않습니다. 과거에 바뀐 요금이나 포함 사용량이 다시 철회될 수 있고, 계약이 중지·종료·재개될 수 있으며, 남아 있는 Credit이 다음 청구서에서 순서대로 사용될 수도 있습니다.
KRBench 20호에서는 8개 계약의 변경 이력과 25개 청구서를 하나의 순차 이벤트 스트림으로 구성했습니다. 공식 채점은 각 청구서의 Status, NetBeforeCreditKRW, CreditUsedKRW, FinalInvoiceKRW 네 필드, 총 100점입니다.
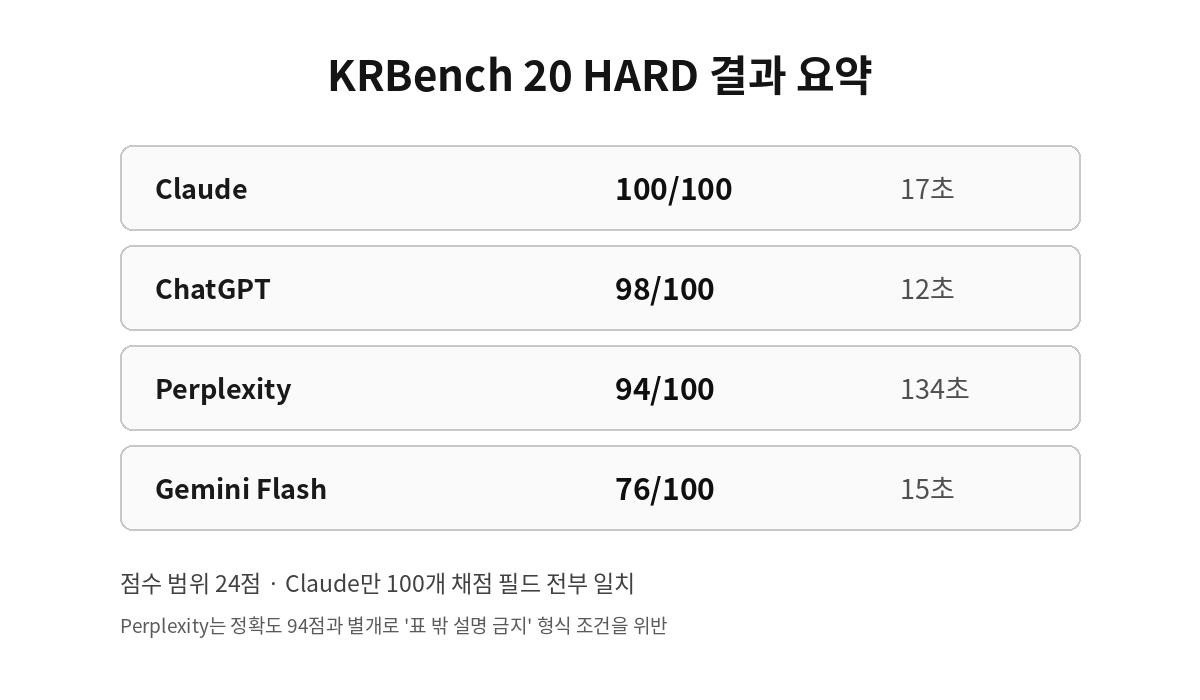
결과 요약
- Claude Sonnet 5.5 · 중간: 100/100 · 17초
- ChatGPT: 98/100 · 12초
- Perplexity: 94/100 · 134초
- Gemini Flash: 76/100 · 15초
- 네 서비스 모두 Status와 CreditUsedKRW는 25/25였습니다. 차이는 주로 청구액 계산에서 발생했습니다.
테스트 방법: 계약의 현재 상태를 재구성한 뒤 청구액까지 계산
전체 입력에는 8개 기본 계약과 57개 이벤트가 들어 있습니다. 이벤트에는 기본료, 포함 사용량, 초과 단가, 할인율 변경과 함께 과거 변경을 제거하는 RETRACT, 계약 중지와 재개, 종료와 재오픈, Credit 추가가 섞여 있습니다.
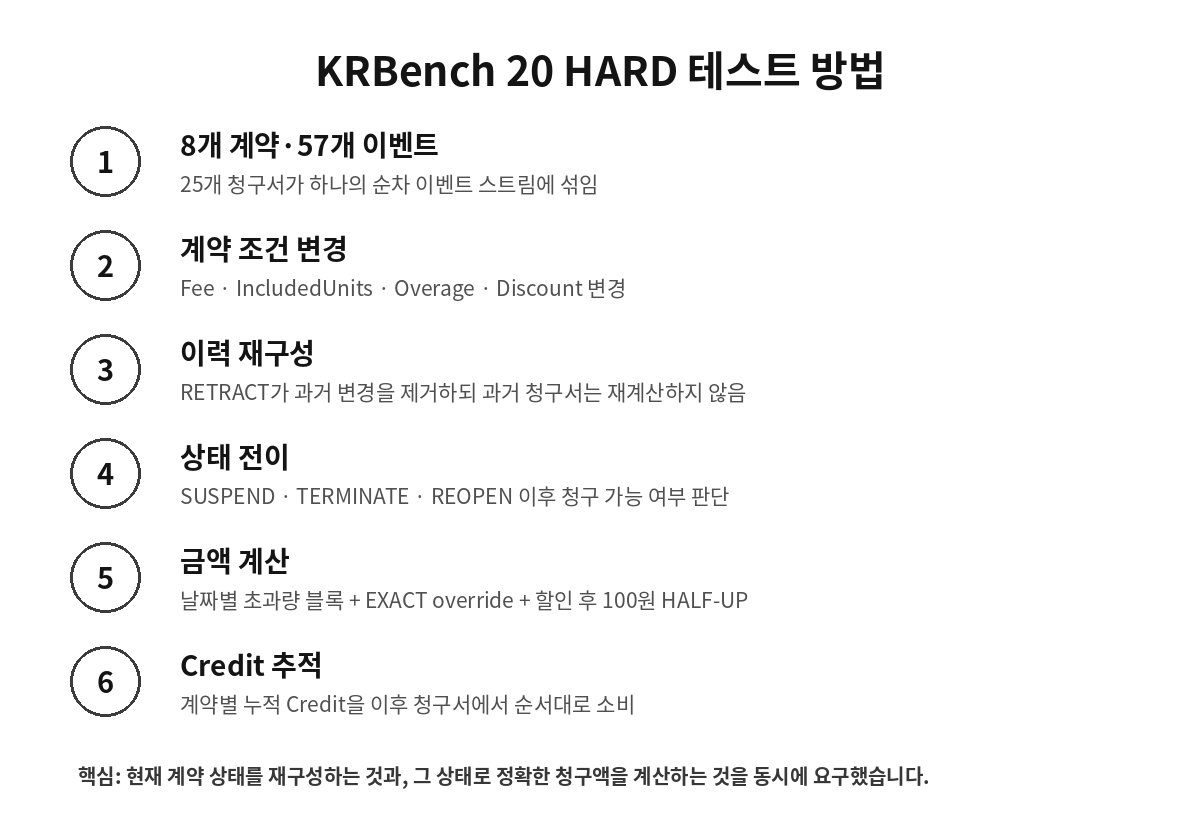
RETRACT는 과거 변경 이벤트를 없었던 것으로 만들어 이후 시점의 현재 계약 조건을 다시 구성합니다. 하지만 이미 발행된 과거 Invoice를 소급해 다시 계산하지는 않습니다. TERMINATED 상태에서 들어온 계약 변경은 무시되며, REOPEN 뒤에도 그 무시된 변경이 되살아나지 않습니다.
초과 사용량 계산도 날짜에 따라 달라집니다. 계약별 SET_ROUNDING EXACT가 있으면 날짜별 블록 정책보다 우선하고, 할인 적용 뒤에는 100원 단위 HALF-UP 반올림을 거쳐 NetBeforeCreditKRW를 확정합니다. 이후 남아 있는 Credit을 가능한 만큼 사용해 FinalInvoiceKRW를 계산합니다.
채점 기준: 25개 Invoice × 4개 필드 = 100점
| 항목 | Invoice당 | 총 배점 |
|---|---|---|
| Status | 1점 | 25점 |
| NetBeforeCreditKRW | 1점 | 25점 |
| CreditUsedKRW | 1점 | 25점 |
| FinalInvoiceKRW | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
사전 정답은 결과를 보기 전에 프롬프트와 같은 규칙을 구현한 결정론적 Oracle로 생성했습니다. 이벤트별 계약 상태와 현재 조건은 별도 trace로 보존했고, 서비스 결과를 확인한 뒤 정답이나 배점을 바꾸지 않았습니다.
전체 결과: 76점부터 100점까지 24점 차이
| 서비스 | Status | NetBeforeCredit | CreditUsed | FinalInvoice | 총점 | 응답시간 |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 · 중간 | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 17초 |
| ChatGPT | 25/25 | 24/25 | 25/25 | 24/25 | 98/100 | 12초 |
| Perplexity | 25/25 | 22/25 | 25/25 | 22/25 | 94/100 | 134초 |
| Gemini Flash | 25/25 | 13/25 | 25/25 | 13/25 | 76/100 | 15초 |
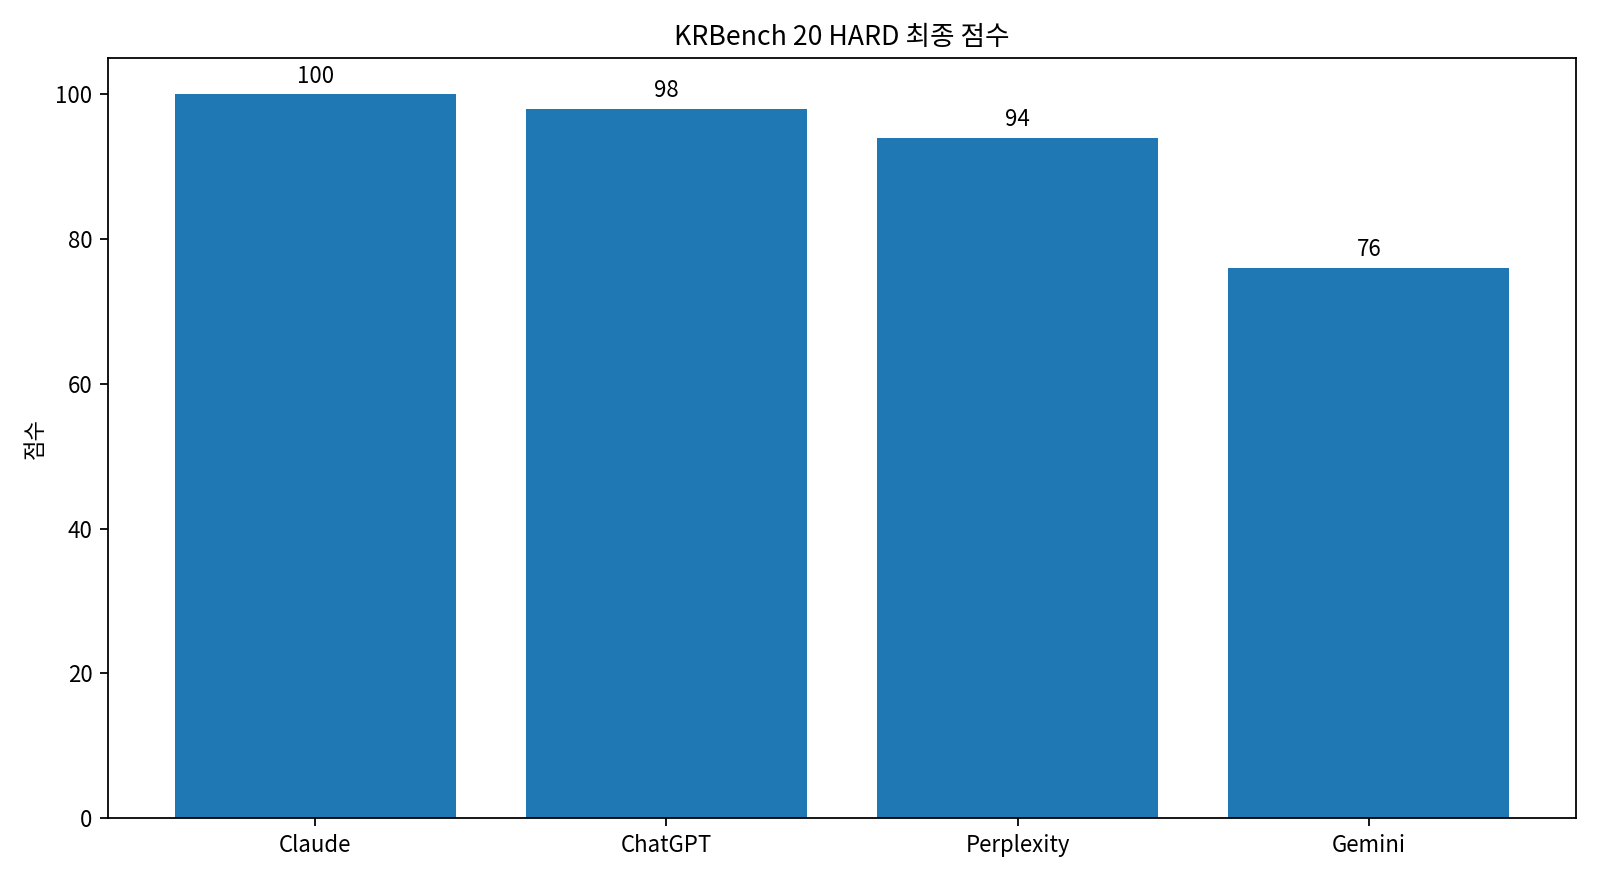
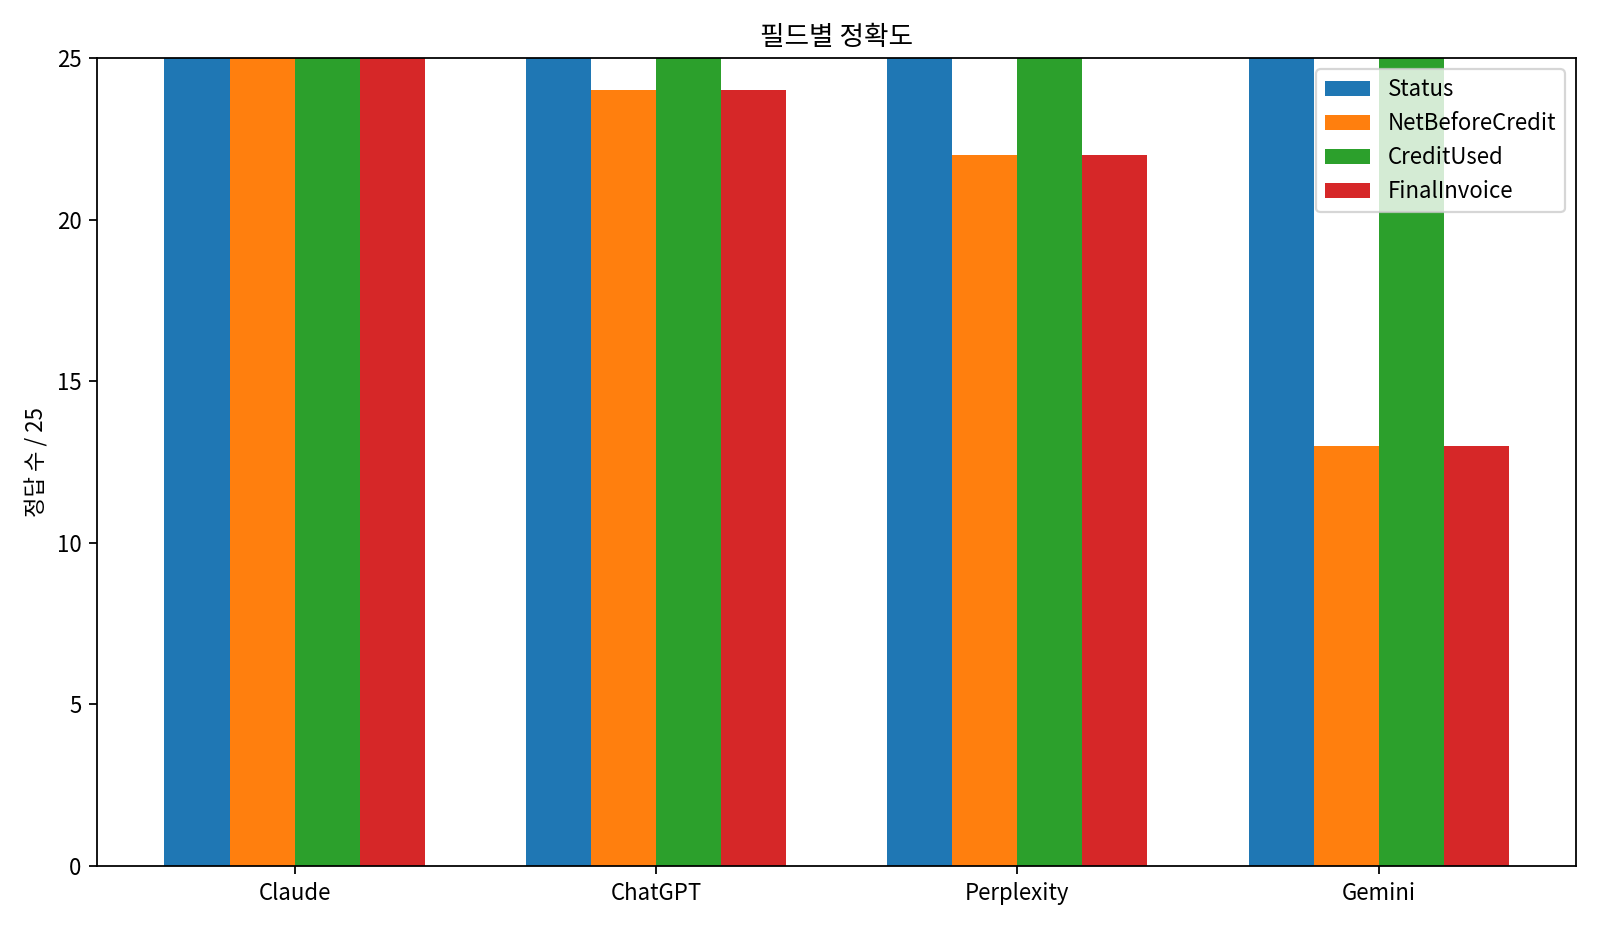
네 서비스 모두 Status와 CreditUsedKRW는 25개를 전부 맞혔습니다. 즉 이번 테스트에서 큰 차이가 난 부분은 계약이 활성 상태인지, Credit이 얼마 남았는지를 추적하는 단계보다 그 시점의 유효 계약 조건과 날짜별 청구 정책을 합쳐 최종 금액을 계산하는 단계였습니다.
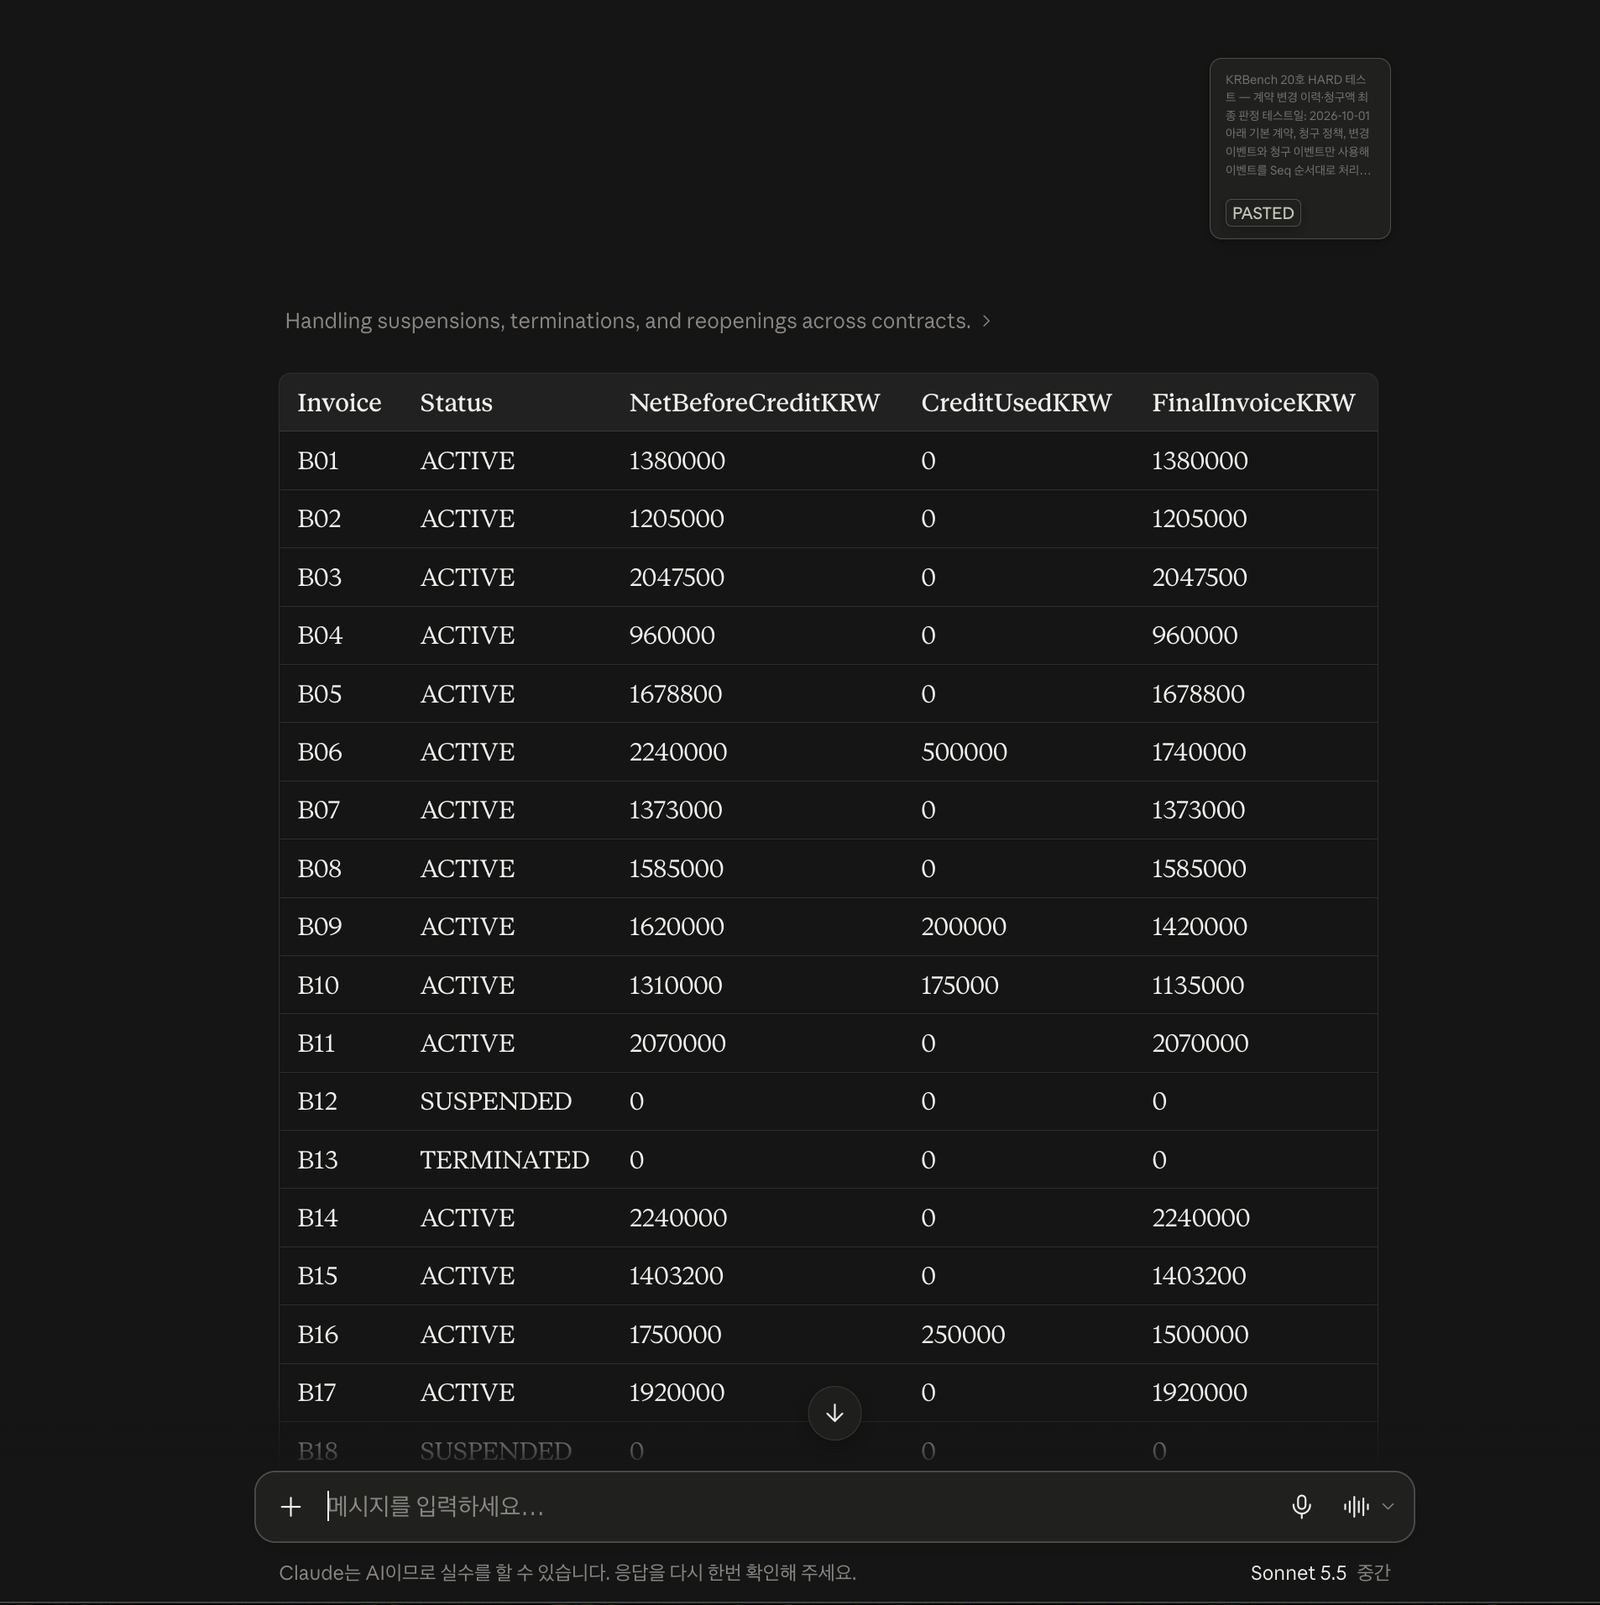
Claude: 100개 채점 필드 모두 사전 정답과 일치
Claude Sonnet 5.5 · 중간은 B01~B25의 네 필드를 모두 맞혀 100점을 기록했습니다. RETRACT로 과거 변경이 제거되는 구간, 종료 후 REOPEN되는 계약, 날짜별 초과 사용량 정책, 계약별 EXACT 예외, 할인과 Credit 사용까지 사전 Oracle과 일치했습니다.
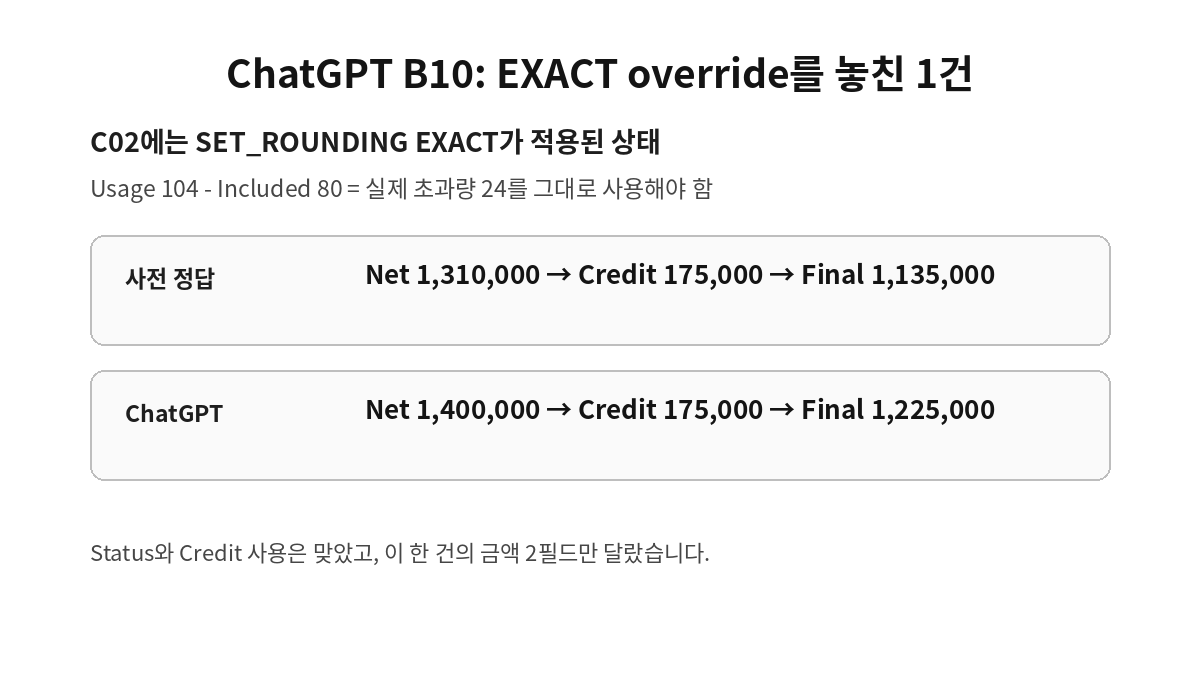
ChatGPT 98점: B10의 EXACT override 한 건에서 차이
ChatGPT는 Status와 CreditUsedKRW는 전부 맞혔고, 금액도 B10을 제외한 24개 Invoice에서 정확했습니다.
B10의 C02에는 SET_ROUNDING EXACT가 적용되어 있습니다. Usage 104에서 IncludedUnits 80을 빼면 실제 초과량 24를 그대로 사용해야 하므로 NetBeforeCreditKRW는 1,310,000원이고, Credit 175,000원을 사용한 FinalInvoiceKRW는 1,135,000원입니다.
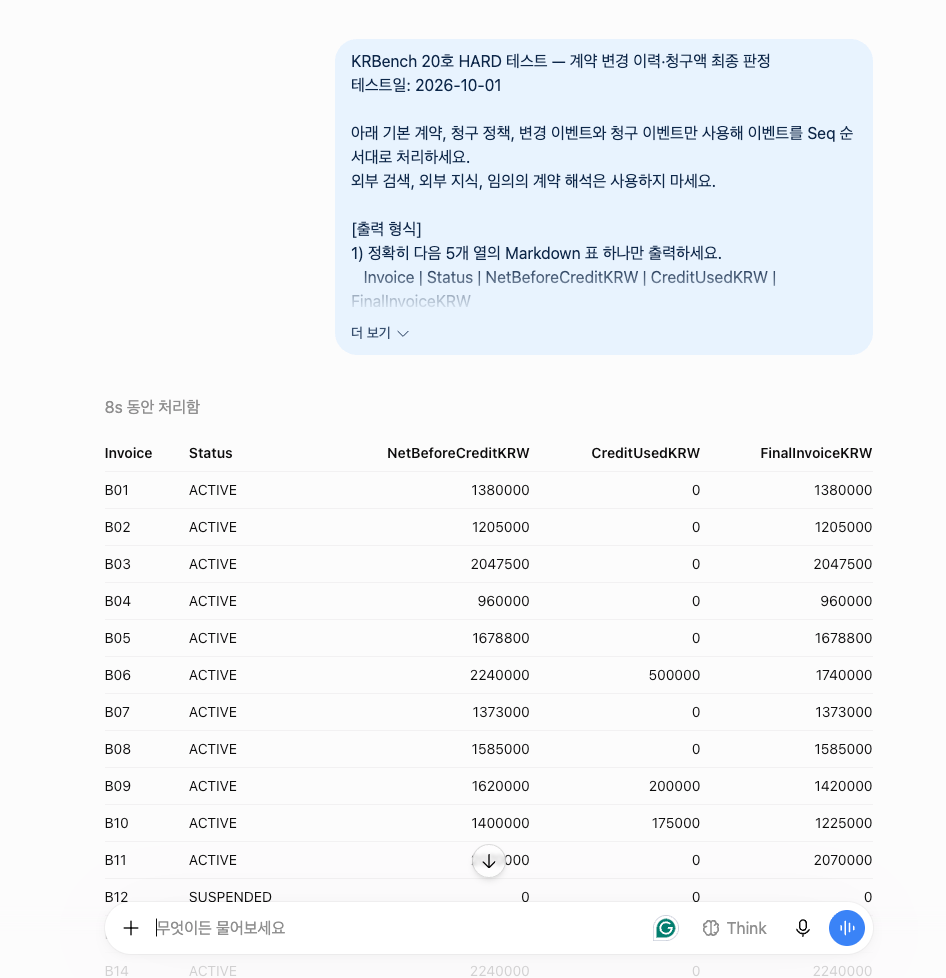
ChatGPT는 B10에서 1,400,000원과 1,225,000원을 출력해 두 필드가 사전 정답과 달랐습니다.
Perplexity 94점: 할인 후 100원 반올림에서 세 건 차이
Perplexity는 Status와 Credit 사용을 모두 맞혔고 대부분의 청구액도 정확했습니다. 차이는 B05, B15, B21 세 건에서 발생했습니다.
세 건 모두 할인 적용 뒤 50원 단위가 남는 금액을 100원 HALF-UP으로 마무리해야 했습니다. 예를 들어 B05는 할인 후 1,678,750원이므로 NetBeforeCreditKRW는 1,678,800원이 되어야 하지만 Perplexity는 1,678,750원을 그대로 출력했습니다.
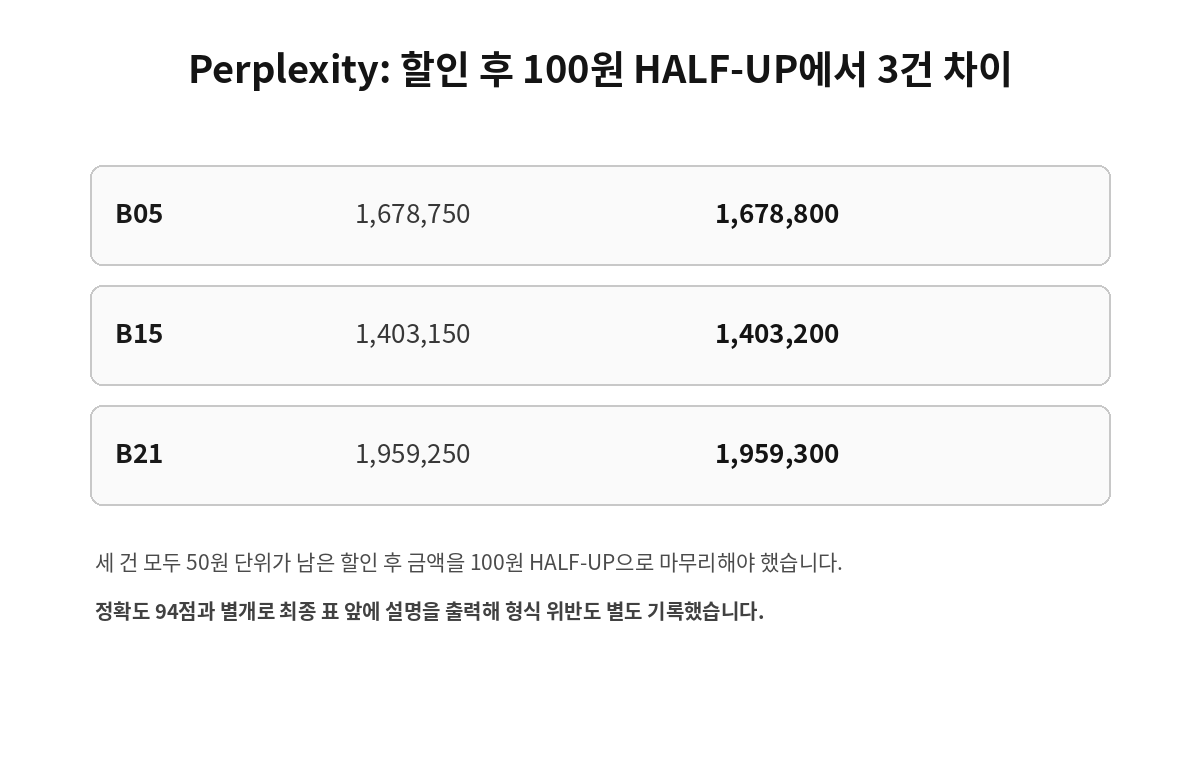
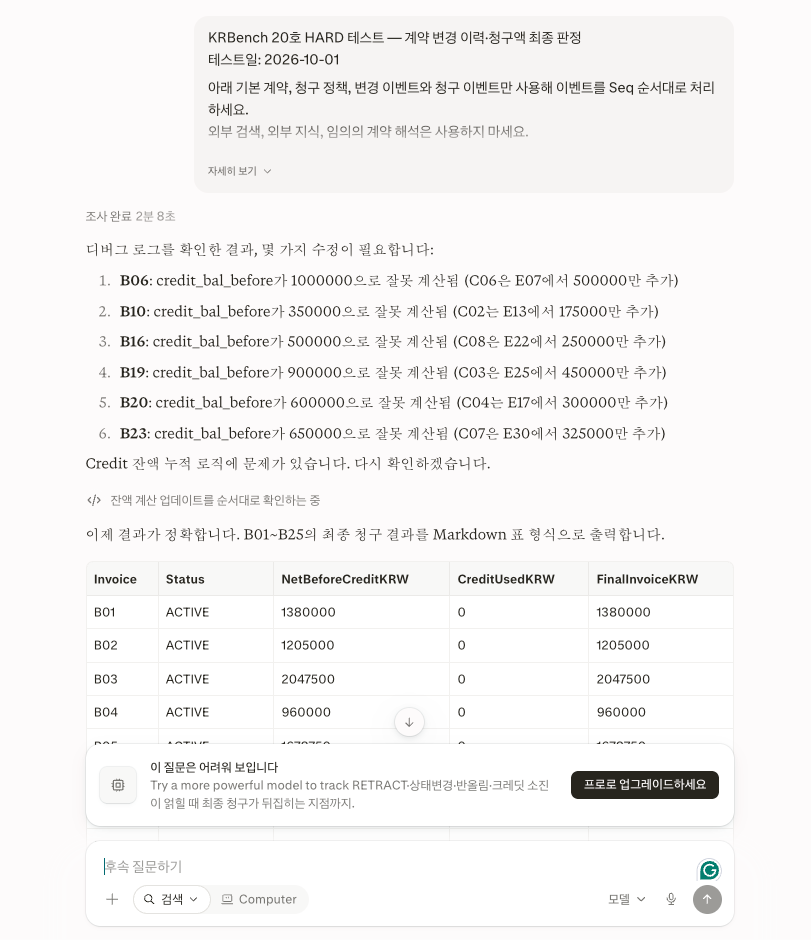
또 프롬프트는 표 하나만 출력하도록 요구했지만 Perplexity는 최종 표 앞에 설명을 추가했습니다. 사전 채점 기준에 따라 정확도 점수와는 분리해 출력 형식 위반으로 기록했습니다.
Gemini 76점: 상태는 맞았지만 12개 청구서의 금액이 달랐다
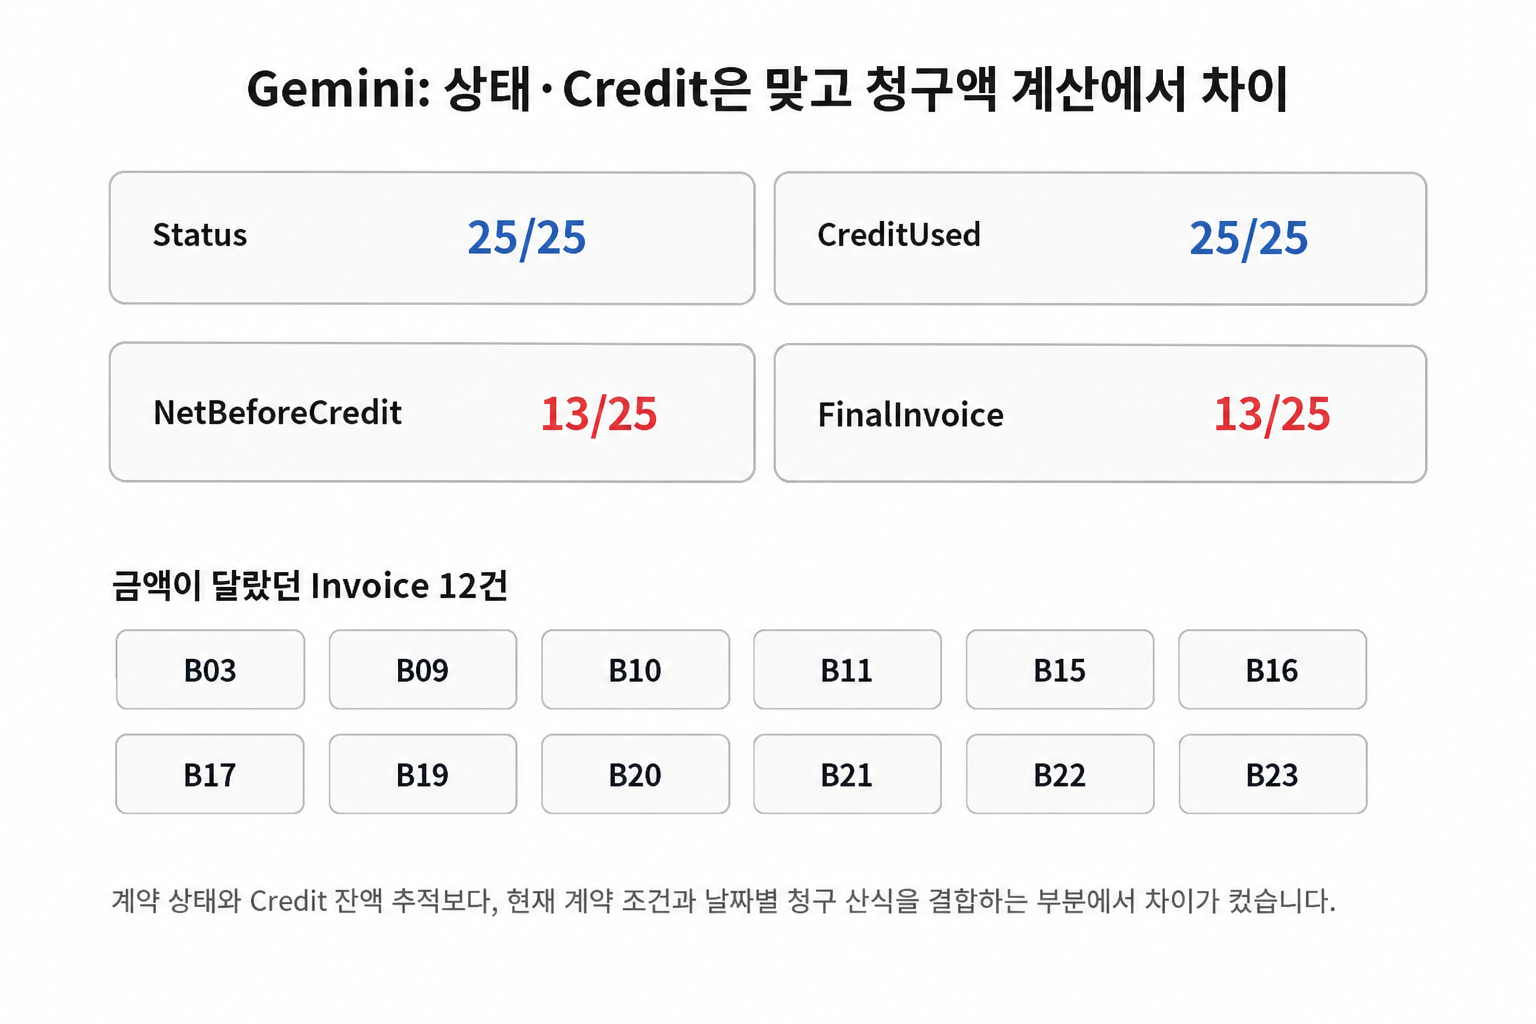
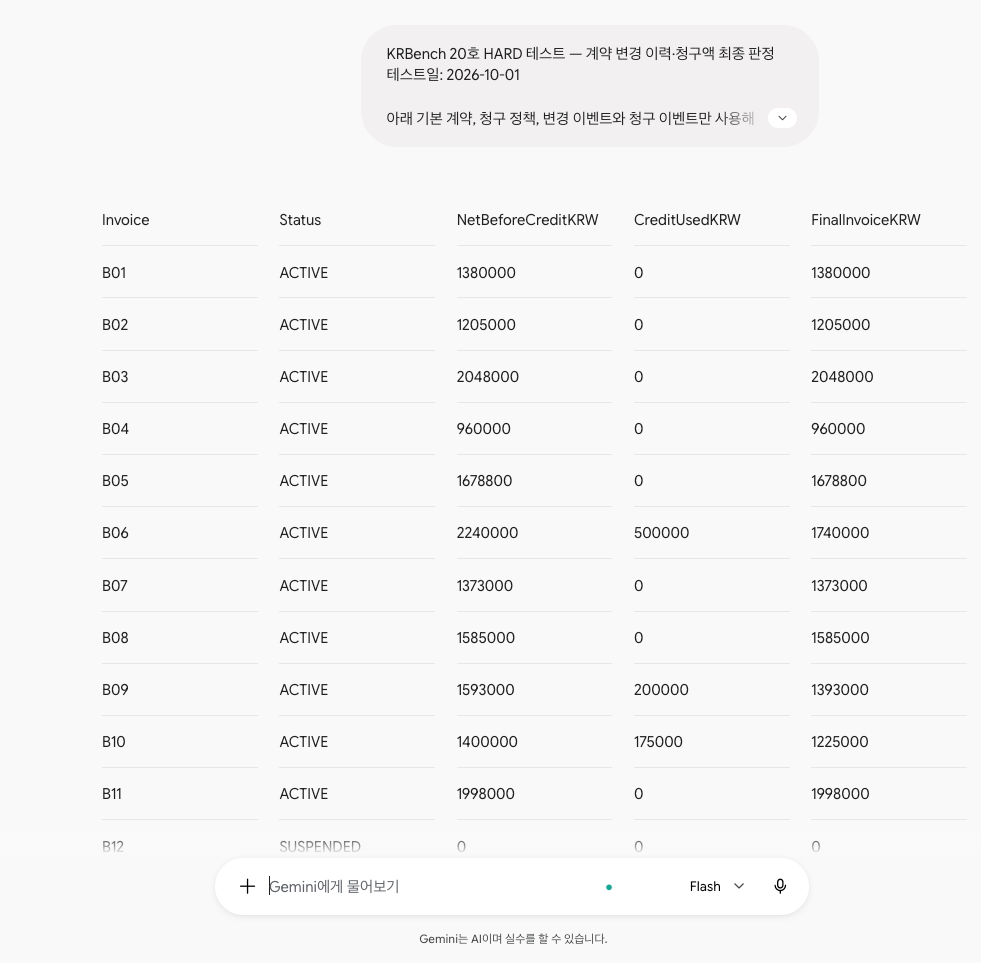
Gemini Flash는 Status 25/25, CreditUsedKRW 25/25를 기록했습니다. 반면 NetBeforeCreditKRW와 FinalInvoiceKRW는 각각 13/25였습니다.
사전 정답과 금액이 달랐던 청구서는 B03, B09, B10, B11, B15, B16, B17, B19, B20, B21, B22, B23으로 총 12건입니다. 하나의 공통 오류로 단정하기보다는, 이번 조건에서 현재 계약 조건과 날짜별 반올림 정책을 결합하는 금액 계산 단계에서 차이가 반복됐다고 볼 수 있습니다.
응답시간: 12초부터 134초
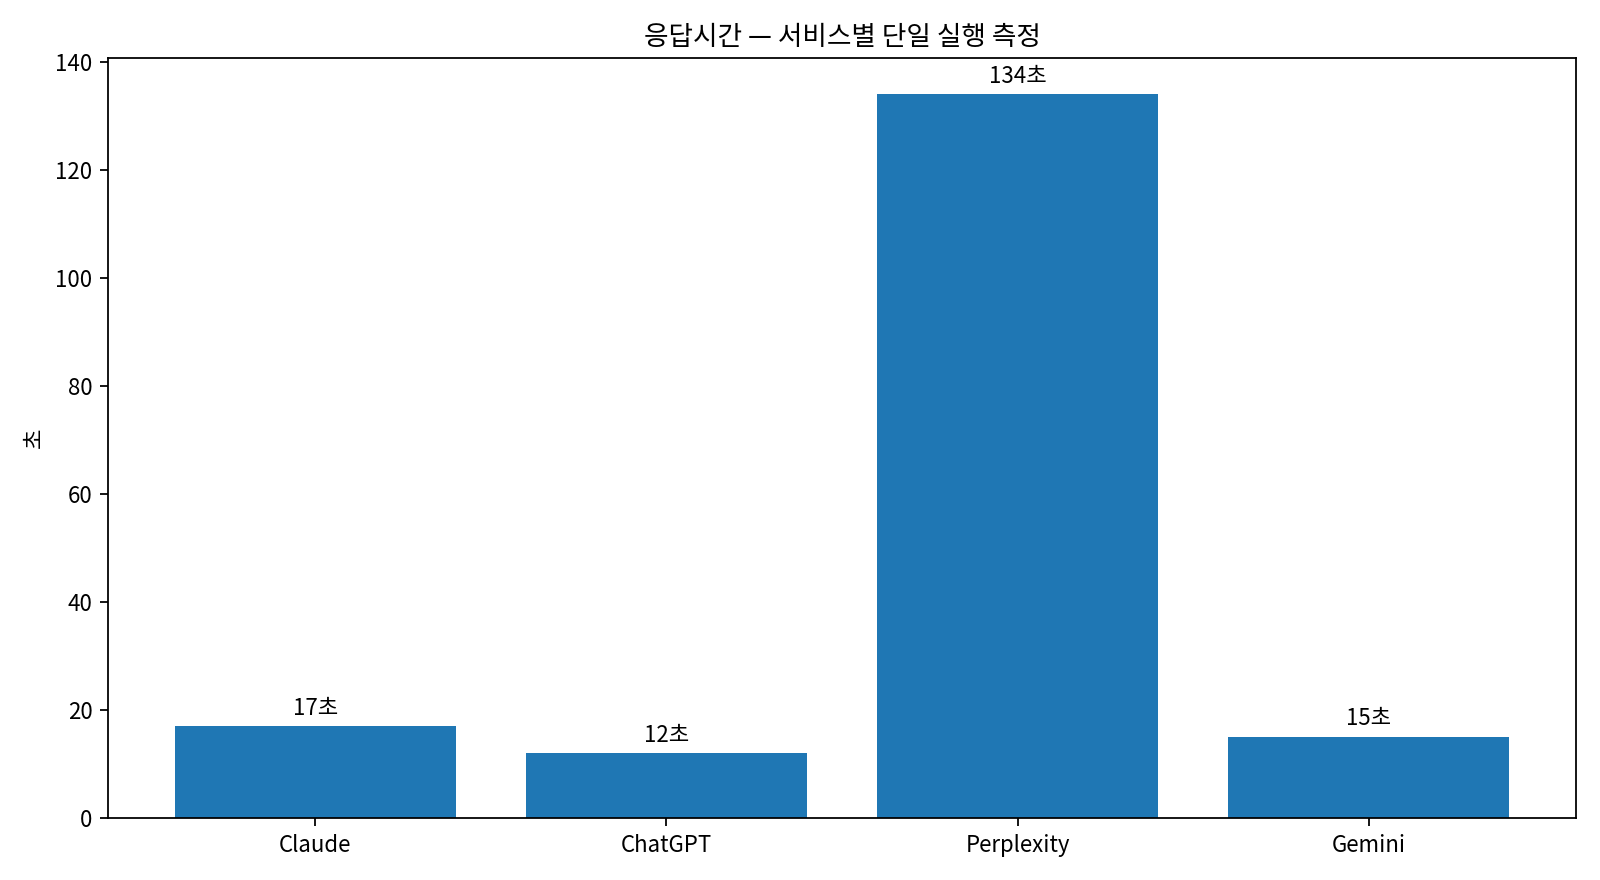
실측 응답시간은 ChatGPT 12초, Gemini 15초, Claude 17초, Perplexity 134초였습니다. 각 서비스에서 한 번만 측정한 값이므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
NotebookLM은 공식 비교에서 제외
이번 테스트는 여러 자료에서 근거를 찾는 작업이 아니라 하나의 긴 이벤트 스트림 안에서 계약의 현재 상태와 금액을 계속 갱신하는 일반 채팅형 계산 문제입니다. NotebookLM은 다른 서비스와 동일한 일반 채팅 입력 경로를 맞추기 어려워 공식 비교에서는 제외했습니다.
이번 테스트에서 확인된 점
이번 조건에서는 네 서비스 모두 계약 상태와 Credit 사용량을 정확하게 추적했습니다. 반면 청구액 산식이 복잡해지자 결과 차이가 나타났습니다. 특히 EXACT 예외, 날짜별 블록 반올림, RETRACT 이후의 현재 조건 재구성, 할인 후 최종 반올림처럼 여러 규칙을 한 금액에 순서대로 적용하는 과정이 변별 요소가 됐습니다.
19호에서는 세 서비스가 정확도 100점을 기록했지만 20호에서는 100점부터 76점까지 다시 차이가 벌어졌습니다. KRBench는 이 점수 차이를 일반적인 서비스 우열로 확대하지 않고, 이번 특정 테스트 조건에서 어떤 필드와 계산 단계에서 차이가 났는지를 기록합니다.
이번 테스트의 한계
- 실제 기업 계약이 아니라 KRBench가 만든 합성 계약·청구 데이터입니다.
- 세금, 외화 청구, 일할 계산, 부분 환불, 복수 통화 Credit은 포함하지 않았습니다.
- 초과 사용량 반올림 규칙은 테스트를 위해 단순화한 가상 정책입니다.
- 청구서는 25건이며 하나의 이벤트 스트림 안에서 생성됐습니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
- Perplexity의 표 밖 설명은 정확도 점수와 별도로 형식 위반으로 기록했습니다.
관련 KRBench 테스트
환율·월별 예산·Vendor 누적이 겹치면 AI가 승인 규정을 끝까지 적용할까?
32개 지출 요청을 순서대로 처리하고 승인 여부, 원화 환산액, 남은 예산, 대표 거절 사유를 비교했습니다.
→ AI 예산 승인 규정 정확도 HARD 테스트 보기의존관계·자원 충돌·휴무가 섞인 프로젝트 일정은?
32개 작업과 21개 변경 이벤트를 시뮬레이션하고 25개 작업의 담당자·기간·시작일·완료일을 비교했습니다.
→ AI 프로젝트 일정 재계산 HARD 테스트 보기11호부터 20호까지 10개의 업무형 AI 테스트를 한 번에 보면?
문서 근거 추적·규정 감사·상태 추적·일정·예산·계약 청구까지 점수 흐름과 반복된 오류 유형을 중간결산으로 정리했습니다.
→ KRBench 업무 벤치마크 10편 중간결산 보기KRBench는 결과 차이가 크거나 작더라도 사전 정답과 채점 기준을 바꾸지 않고, 같은 조건에서 확인된 첫 응답을 그대로 기록합니다.