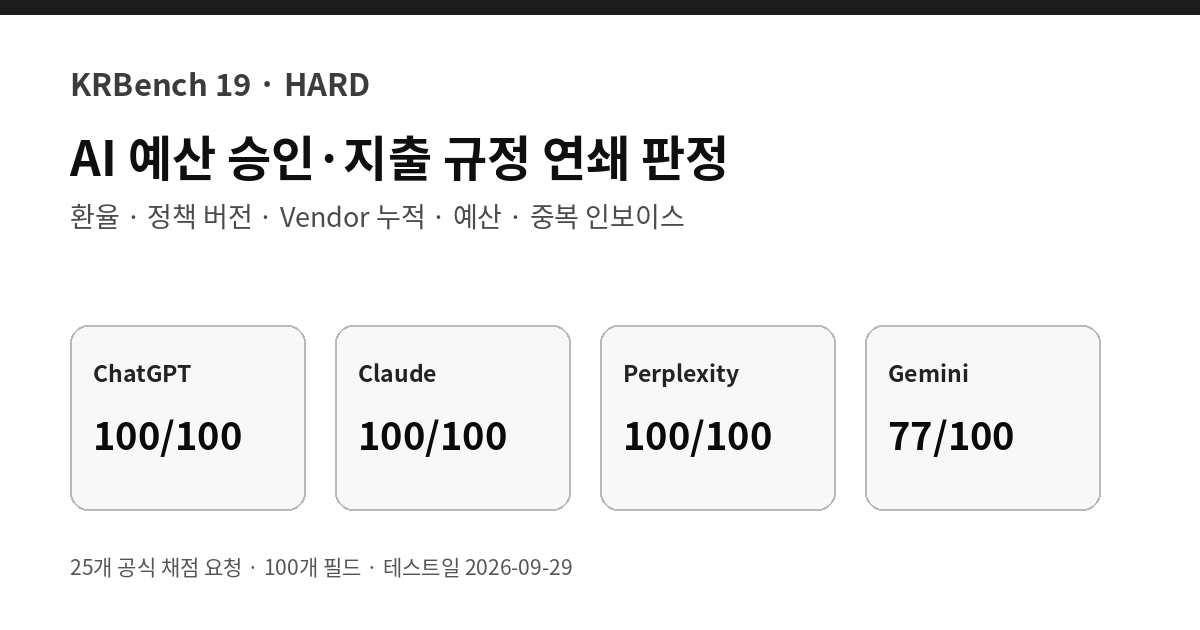
이번 KRBench 19호는 예산 승인과 지출 규정을 한 건씩 따로 판단하는 문제가 아닙니다. 앞선 요청이 승인되면 부서 예산과 공급업체 월 누적액이 바뀌고, 그 상태가 다음 요청의 승인 여부와 남은 예산에 계속 영향을 주도록 만들었습니다.
전체 요청은 32건이며 공식 채점은 R08부터 R32까지 25건입니다. 각 요청에서 Decision, ChargeKRW, RemainingDeptBudgetKRW, PrimaryReason 네 필드를 채점해 총 100점으로 비교했습니다.
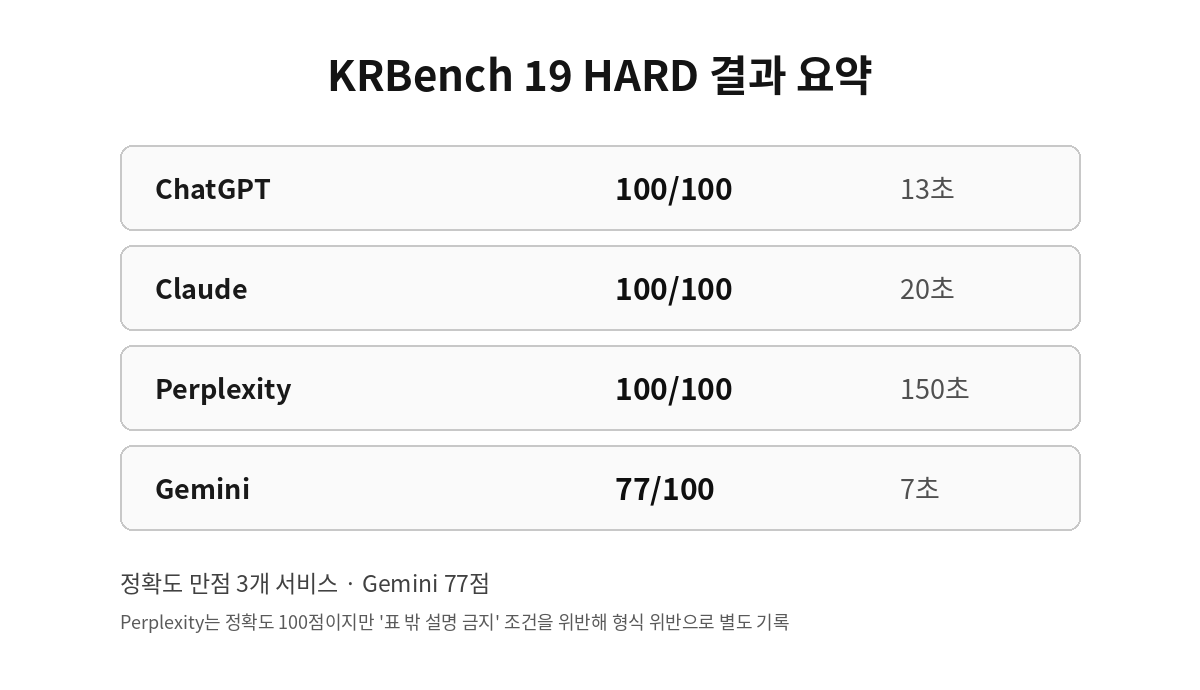
결과 요약
- ChatGPT: 100/100 · 13초
- Claude Sonnet 5.5 · 중간: 100/100 · 20초
- Perplexity: 100/100 · 150초
- Gemini: 77/100 · 7초
- Perplexity는 정확도는 만점이었지만 표 밖 설명 금지 출력 형식 조건을 지키지 않았습니다.
테스트 방법: 앞 요청의 결과가 뒤 요청의 상태를 바꾼다
요청은 표의 위에서 아래 순서대로 한 번씩 처리합니다. APPROVED 요청만 해당 부서 예산과 공급업체 월 누적액을 소비하고, 승인된 인보이스 기록에 추가됩니다. REJECTED 요청은 이 상태를 바꾸지 않습니다.
여기에 KRW·USD·EUR·JPY 고정환율, 100원 단위 HALF-UP 반올림, 9월과 10월의 서로 다른 정책, 카테고리별 한도, 공급업체 월 누적 한도, 승인 단계, 차단 조합, 중복 인보이스 규칙을 함께 넣었습니다.
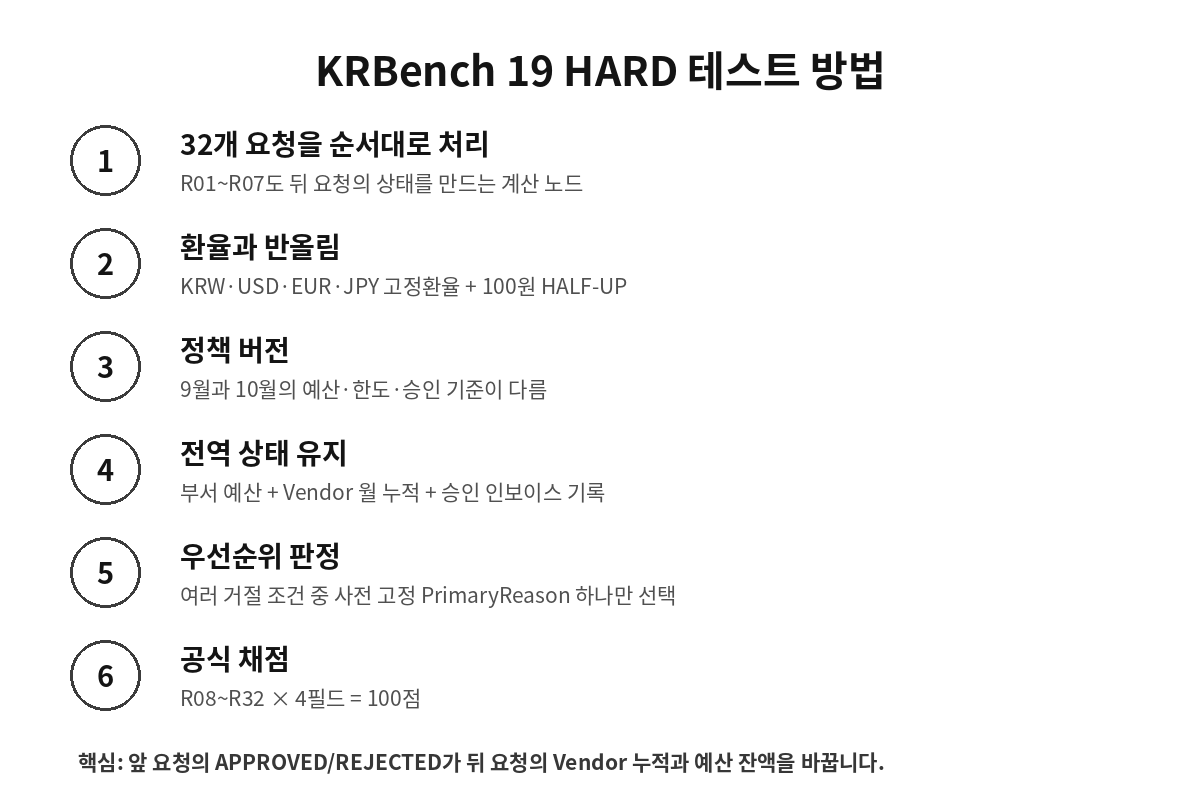
월이 바뀌면 부서 예산과 공급업체 월 누적액은 새 월 기준으로 리셋되지만, 이미 승인된 인보이스의 중복 기록은 월을 넘어 유지됩니다. 또한 한 요청이 여러 거절 조건에 동시에 걸릴 때는 미리 정한 PrimaryReason 우선순위 하나만 적용했습니다.
채점 기준: 25개 요청 × 4개 필드 = 100점
| 항목 | Request당 | 총 배점 |
|---|---|---|
| Decision | 1점 | 25점 |
| ChargeKRW | 1점 | 25점 |
| RemainingDeptBudgetKRW | 1점 | 25점 |
| PrimaryReason | 1점 | 25점 |
| 합계 | 4점 × 25 | 100점 |
사전 정답은 결과를 보기 전에 프롬프트와 같은 규칙을 구현한 결정론적 계산으로 생성했습니다. 요청별 환산 금액, 예산 전후 값, Vendor 누적액 전후 값, 승인 단계와 최종 사유를 Oracle trace로 보존했습니다.
전체 결과: 세 서비스 100점, Gemini 77점
| 서비스 | Decision | ChargeKRW | RemainingBudget | PrimaryReason | 총점 | 응답시간 |
|---|---|---|---|---|---|---|
| ChatGPT | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 13초 |
| Claude Sonnet 5.5 · 중간 | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 20초 |
| Perplexity | 25/25 | 25/25 | 25/25 | 25/25 | 100/100 | 150초 |
| Gemini | 20/25 | 25/25 | 12/25 | 20/25 | 77/100 | 7초 |
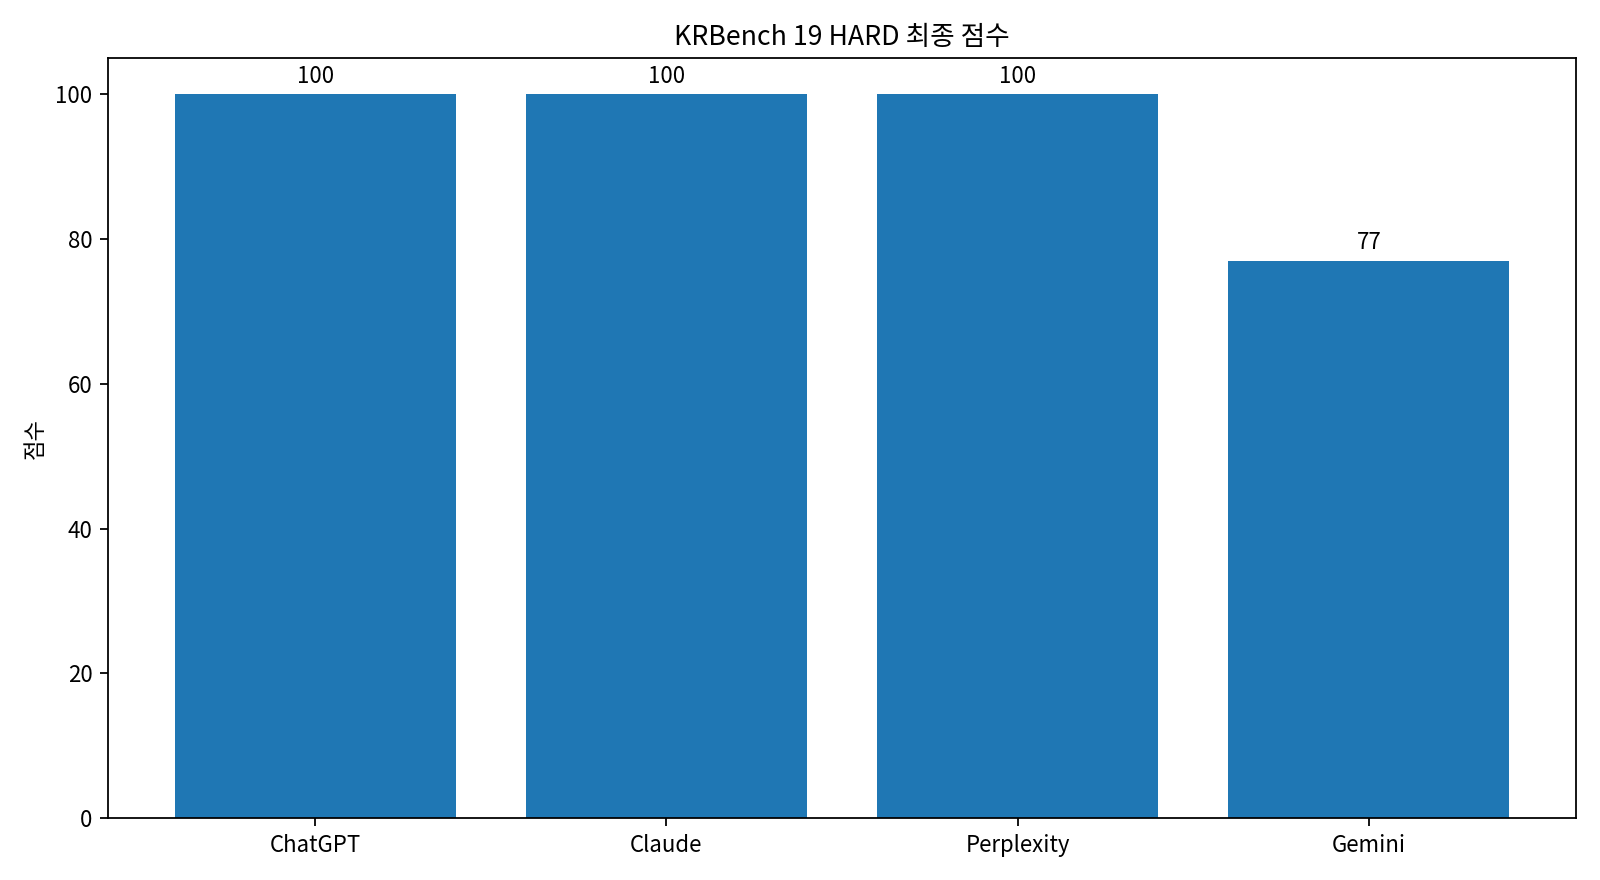
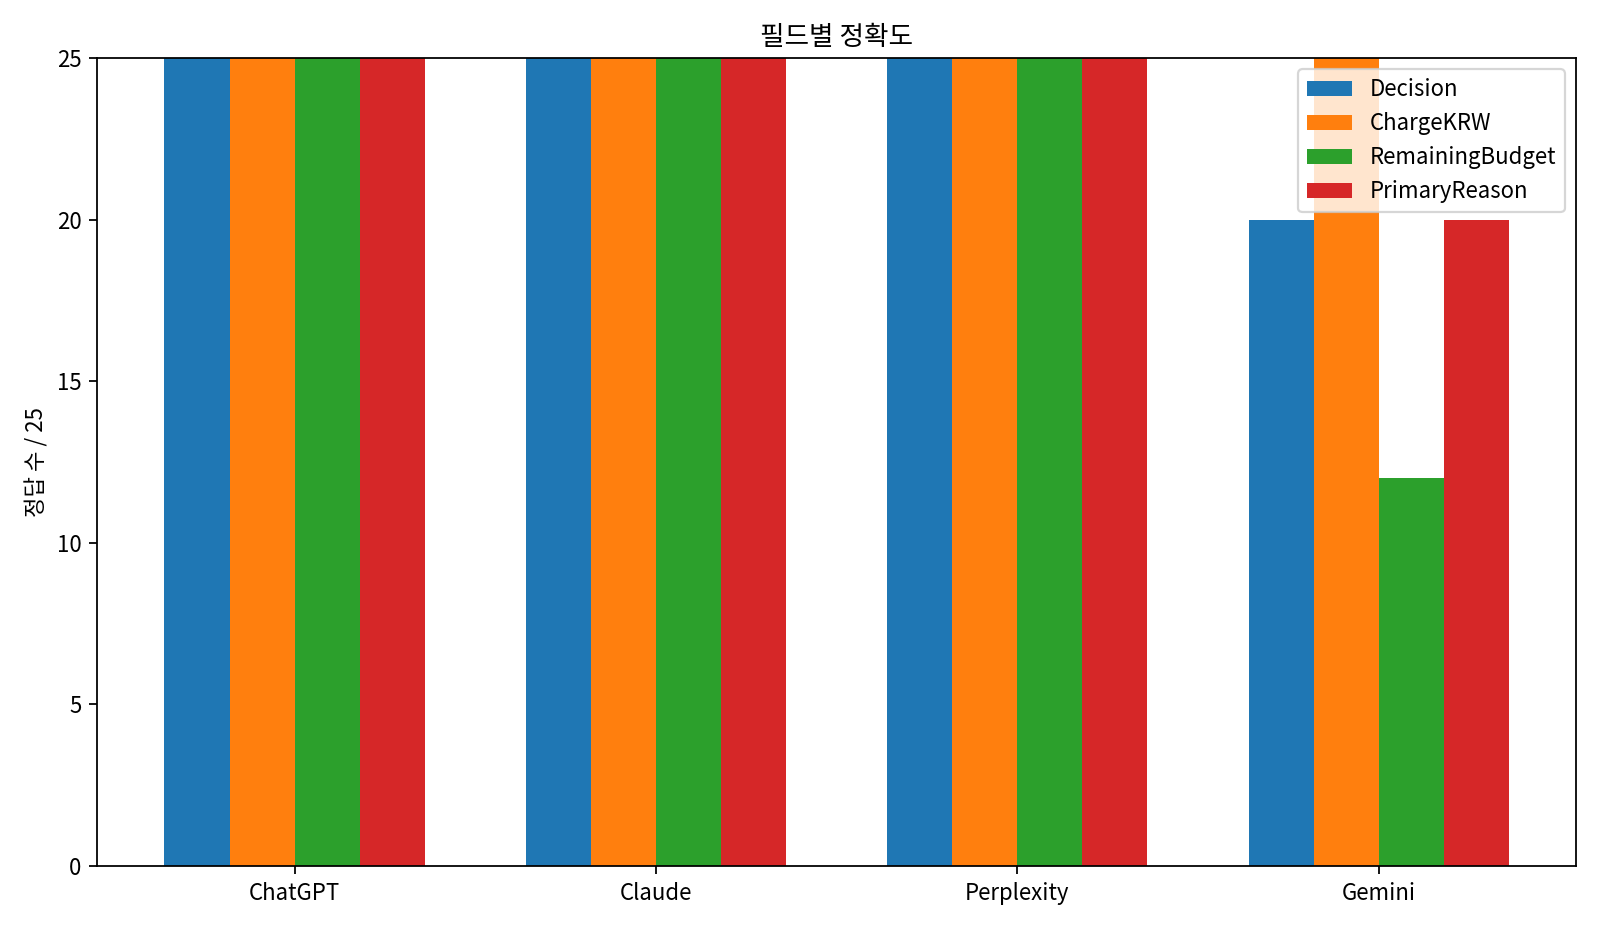
ChatGPT, Claude, Perplexity는 R08~R32의 25개 요청에서 네 필드를 모두 맞혔습니다. 반면 Gemini는 환율 환산과 반올림은 전부 정확했지만, Vendor 월 누적 상태를 일부 놓치면서 Decision과 PrimaryReason뿐 아니라 뒤 요청의 남은 예산까지 연쇄적으로 달라졌습니다.
ChatGPT: 100개 채점 필드 모두 일치
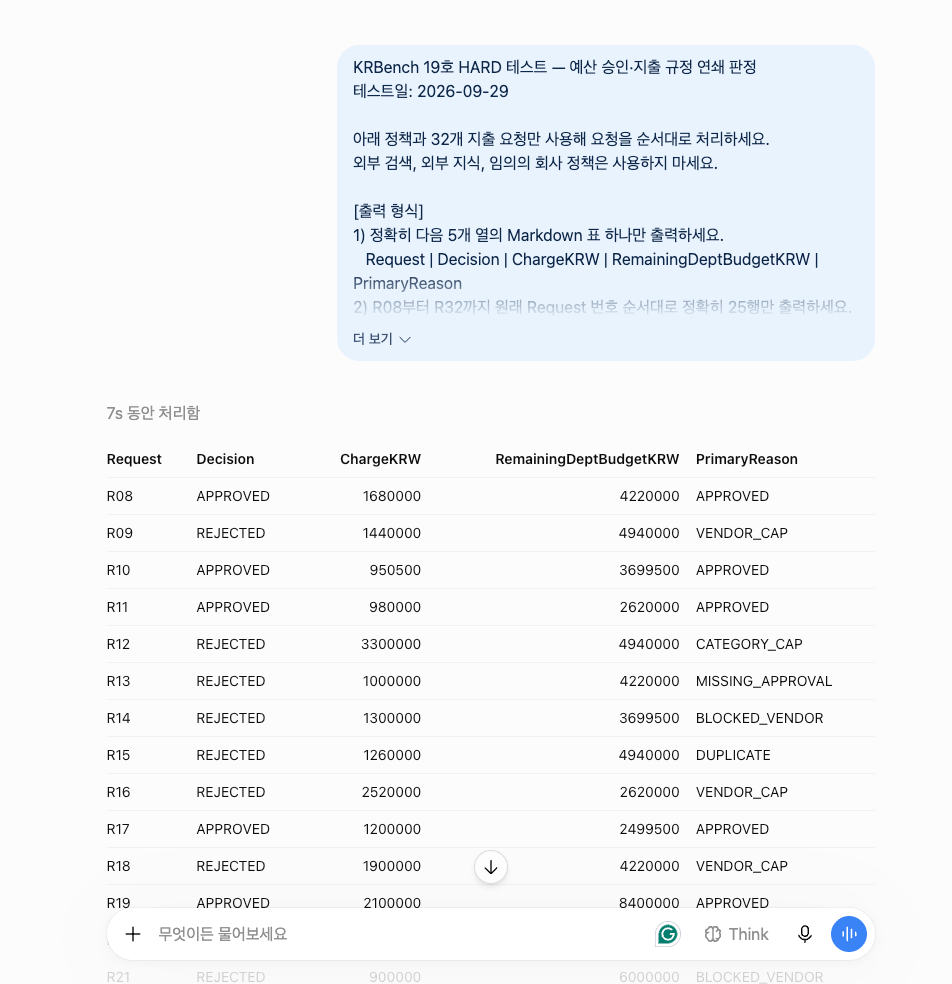
ChatGPT는 Decision, ChargeKRW, RemainingDeptBudgetKRW, PrimaryReason을 각각 25개 모두 맞혀 100점을 기록했습니다. JPY 환산 후 100원 HALF-UP 반올림, 9월과 10월의 월별 상태 리셋, 월을 넘어 유지되는 중복 인보이스, 마지막 R32의 BUDGET 판정까지 사전 Oracle과 일치했습니다.
Claude: 100점, 전역 상태를 끝까지 유지
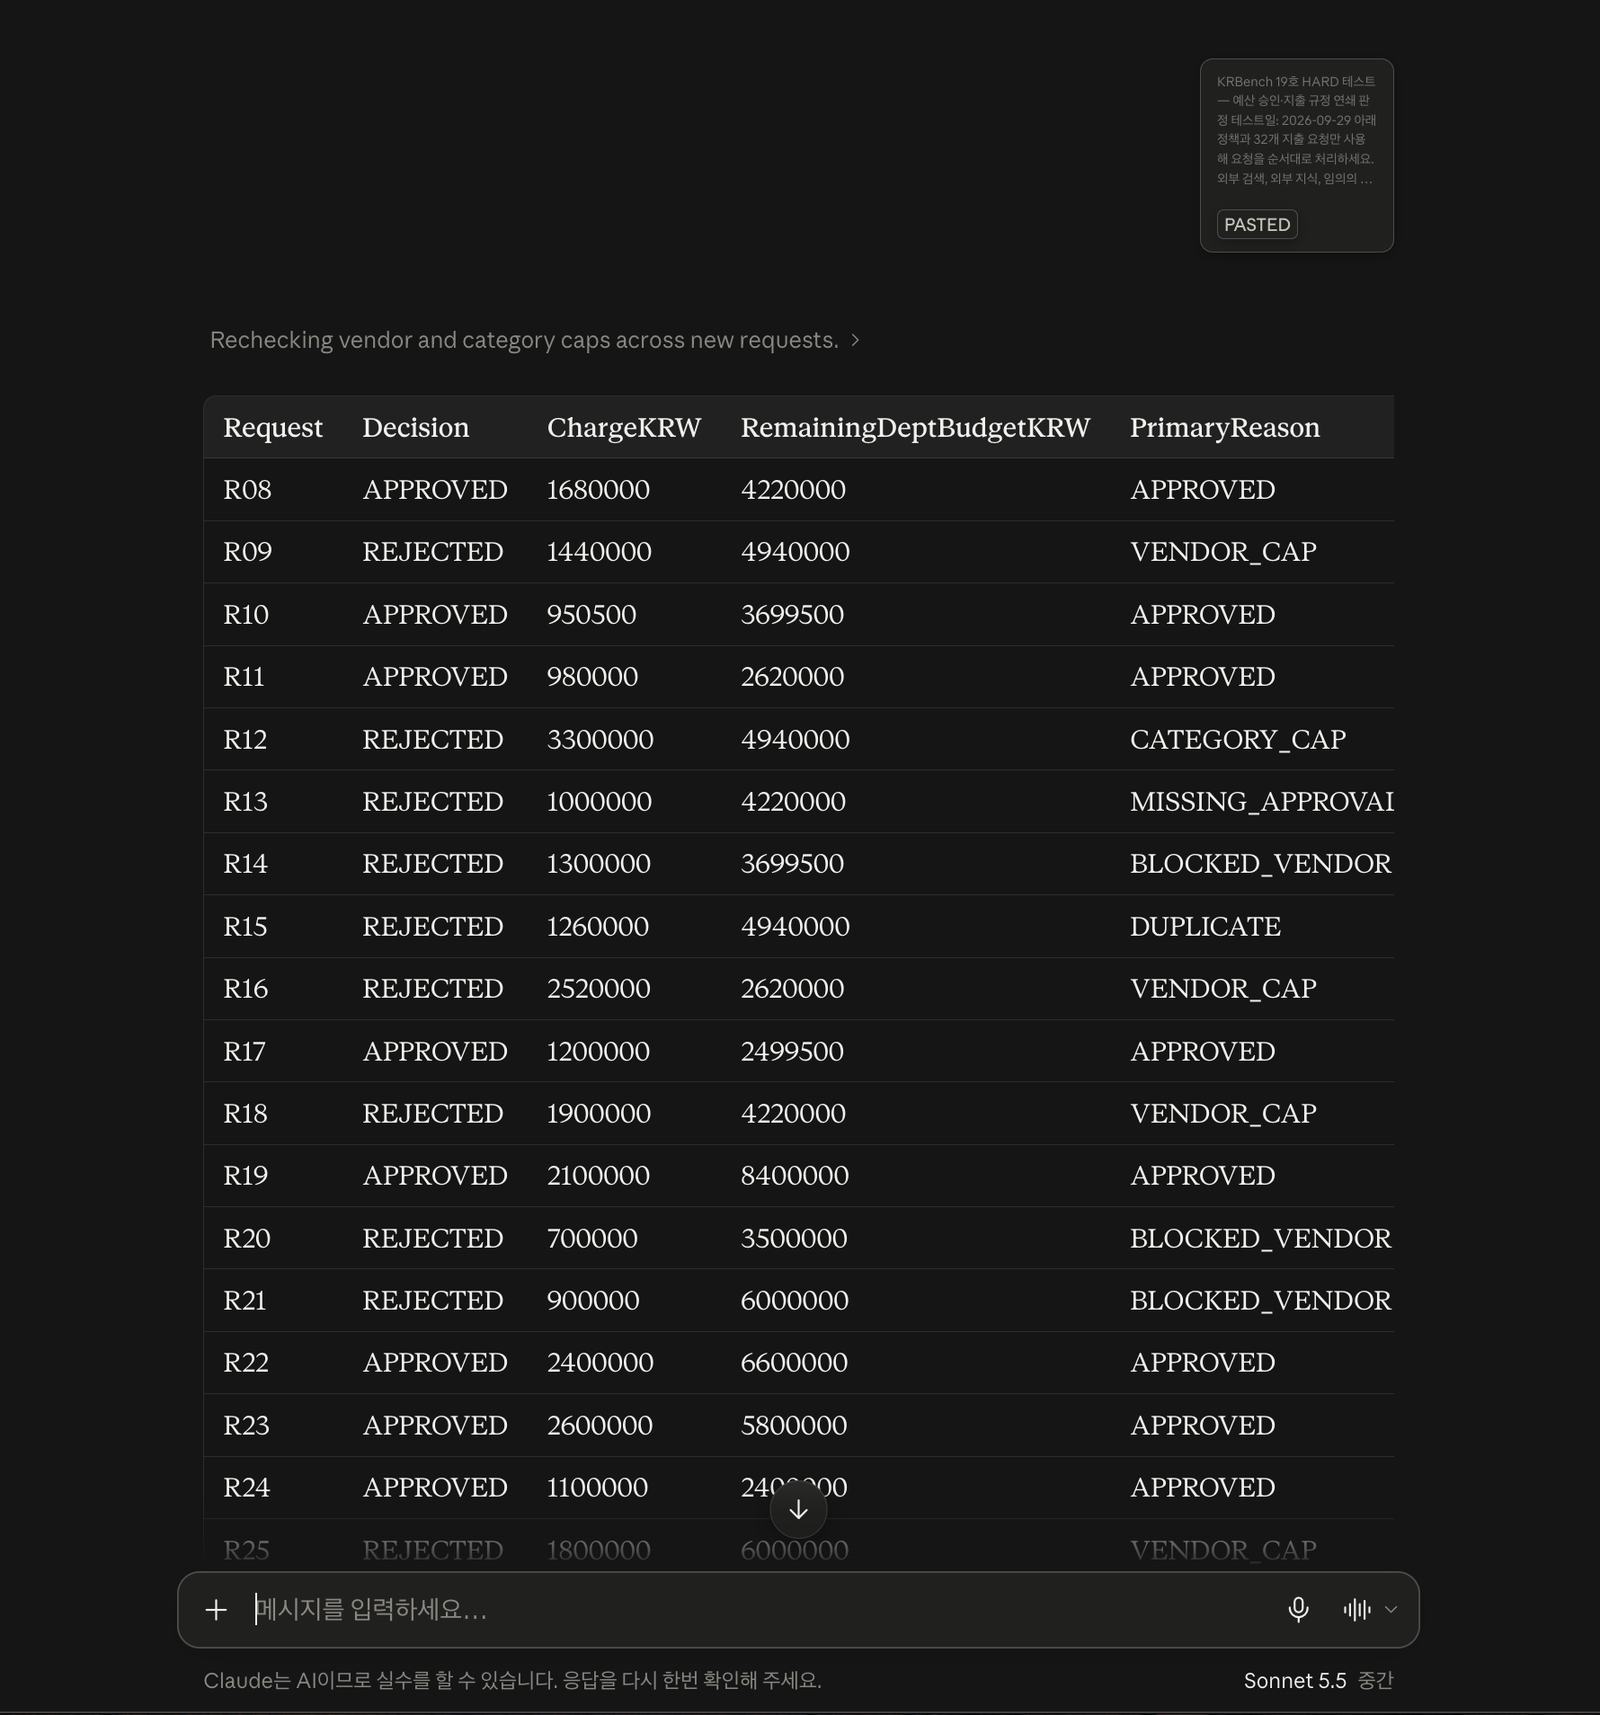
Claude Sonnet 5.5 · 중간도 네 필드 100개를 모두 맞혔습니다. 특히 Vendor 누적 한도 때문에 거절되어야 하는 R09·R18·R25·R26·R28과 월을 넘어 중복이 유지되는 R31을 모두 정확히 판정했습니다.
Perplexity: 정확도 100점, 하지만 출력 형식은 지키지 않았다
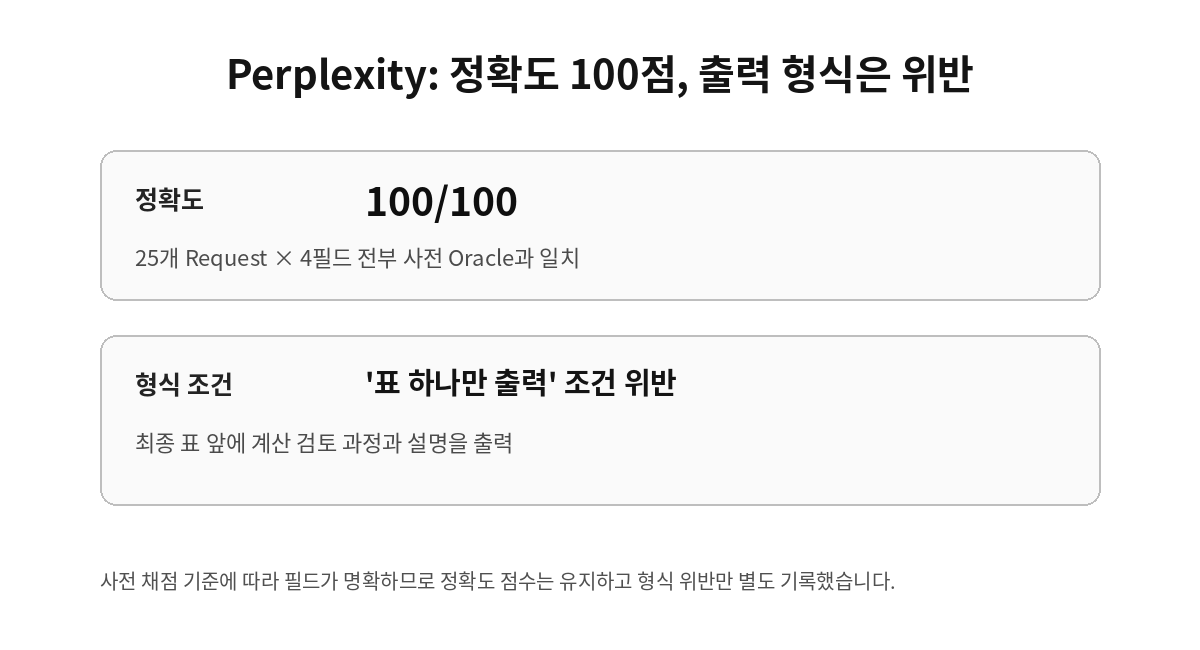
Perplexity도 25개 요청의 네 필드를 모두 맞혀 정확도는 100점이었습니다. 다만 프롬프트는 Markdown 표 하나만 출력하고 표 밖 설명을 쓰지 말 것을 명시했는데, Perplexity는 최종 표 전에 여러 요청의 계산 과정을 길게 설명했습니다.
사전에 정한 채점 규칙에서는 필드가 명확하면 정확도 점수는 유지하고 출력 형식 위반을 별도로 기록하기로 했기 때문에, 공식 정확도 점수는 100점으로 유지했습니다.
Gemini 77점: Vendor 누적 상태 오류가 뒤 예산까지 번졌다
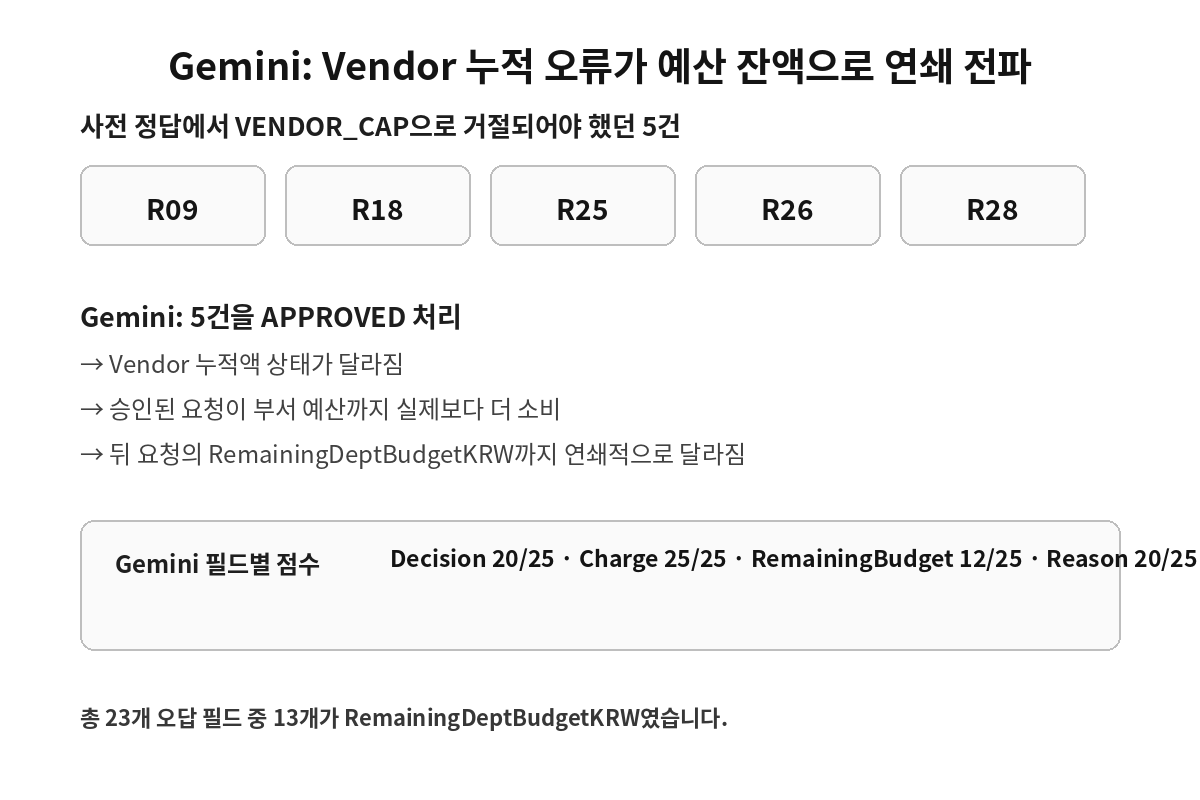
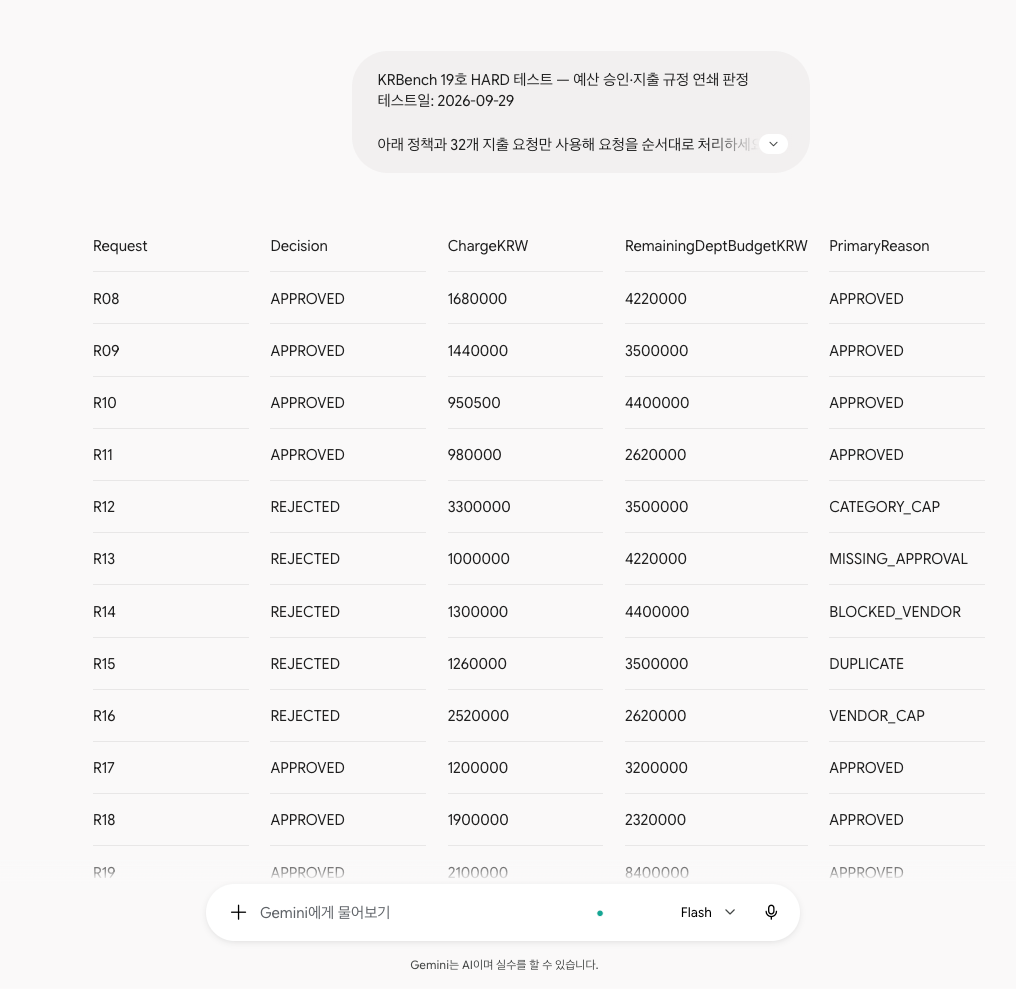
Gemini는 ChargeKRW 25개를 모두 맞혔습니다. 환율 계산과 100원 반올림 자체는 정확했습니다. 하지만 R09, R18, R25, R26, R28을 사전 정답과 달리 APPROVED로 처리했습니다. 이 5건은 모두 사전 Oracle에서 VENDOR_CAP으로 거절되어야 하는 요청입니다.
잘못 승인된 요청은 해당 부서 예산까지 소비한 것으로 계산되기 때문에, 한 번의 Vendor 누적 상태 오류가 뒤 요청의 RemainingDeptBudgetKRW까지 이어졌습니다. 그 결과 Gemini는 Decision 20/25, ChargeKRW 25/25, RemainingDeptBudgetKRW 12/25, PrimaryReason 20/25를 기록했습니다.
응답시간: 7초부터 150초
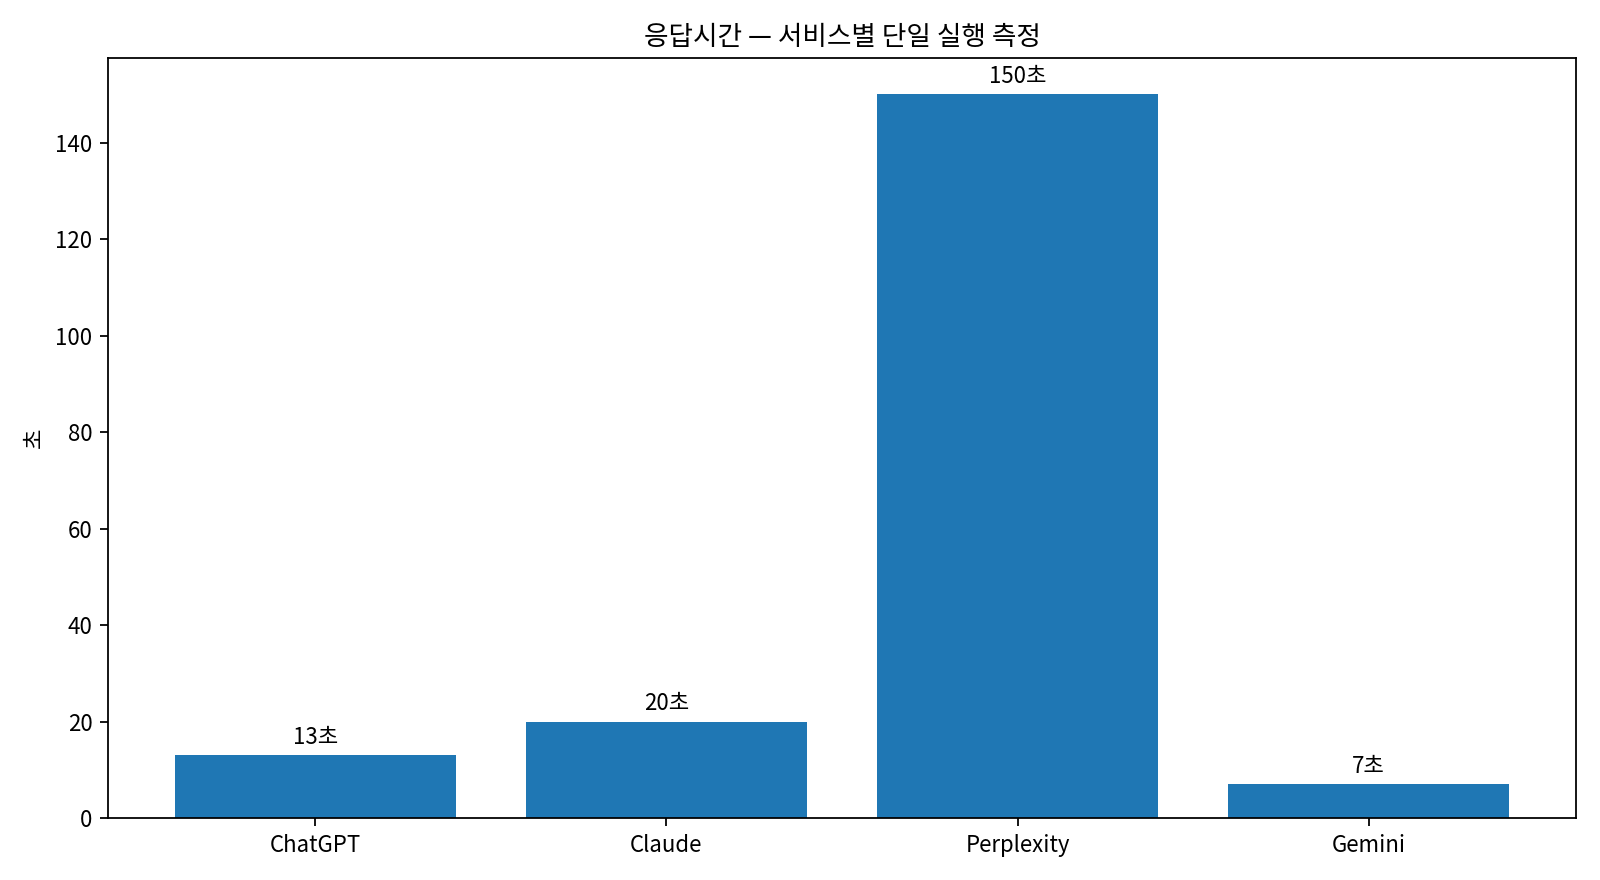
실측 응답시간은 Gemini 7초, ChatGPT 13초, Claude 20초, Perplexity 150초였습니다. 각 서비스에서 한 번만 측정한 값이므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
NotebookLM은 공식 비교에서 제외
이번 테스트는 파일에서 근거를 찾는 작업이 아니라 하나의 긴 프롬프트 안에서 요청을 순서대로 처리하며 상태를 계속 갱신하는 일반 채팅형 계산 문제입니다. NotebookLM은 입력 경로가 다른 서비스와 달라 동일 조건을 우선해 공식 비교에서는 제외했습니다.
이번 테스트에서 확인된 점
19호에서는 세 서비스가 정확도 100점을 기록해 18호보다 점수 분산은 작았습니다. 하지만 Gemini에서는 특정 상태 하나를 잘못 유지했을 때 승인 여부 → 예산 차감 → 뒤 요청의 잔액까지 연쇄적으로 오류가 번지는 모습이 확인됐습니다.
또 Perplexity처럼 정답 자체는 모두 맞아도 출력 형식 조건을 지키지 않는 경우가 있었습니다. 실제 업무 자동화에서는 계산 정확도뿐 아니라 정해진 출력 형식을 그대로 지키는지도 별도 품질 요소가 될 수 있습니다.
이번 테스트의 한계
- 실제 회사의 재무 규정이 아니라 KRBench가 만든 합성 정책입니다.
- 환율은 테스트용 고정값으로 사용했습니다.
- 월별 예산과 Vendor 누적은 단순화된 하나의 원장 상태로 처리했습니다.
- 세금, 환불, 부분 승인, 소수점 외화 금액, 여러 비용센터 분할은 포함하지 않았습니다.
- 공식 채점은 전체 32건 중 R08~R32 25건만 대상으로 했습니다.
- 응답시간은 서비스별 단일 실행 측정값입니다.
관련 KRBench 테스트
의존관계·휴무·자원 충돌이 섞인 프로젝트 일정을 AI가 끝까지 다시 계산할까?
32개 작업과 21개 변경 이벤트를 날짜별로 시뮬레이션하고 25개 작업의 담당자·기간·시작일·완료일을 비교했습니다.
→ AI 프로젝트 일정 재계산 정확도 HARD 테스트 보기담당자·마감일·금액이 계속 바뀌는 업무 메일의 최종 상태를 AI가 추적할까?
취소·재개·완료·과거 수정 철회가 섞인 25개 업무 메일 스레드의 최종 상태를 비교했습니다.
→ AI 업무 메일 최종 상태 추적 정확도 비교 보기KRBench는 결과 차이가 크거나 작더라도 사전 정답과 채점 규칙을 바꾸지 않고, 같은 조건에서 확인된 첫 응답을 그대로 기록합니다.