회의록에서 중요한 건 앞에 나온 말을 잘 요약하는 것보다, 회의 중간에 바뀐 담당자·일정·상태를 끝까지 따라가 최종 결정만 남기는 것입니다.
KRBench는 ChatGPT, Gemini, Claude, NotebookLM, Perplexity에 같은 가상 한국어 회의록을 주고, 담당자·내부 마감일·상태·최종 운영 수치까지 정답형으로 채점했습니다.
최종 결과
- ChatGPT: 100/100
- Gemini: 99/100
- Claude: 100/100
- NotebookLM: 100/100
- Perplexity: 99/100 — 단, 1점은 해석 여지가 있는 상태 분류
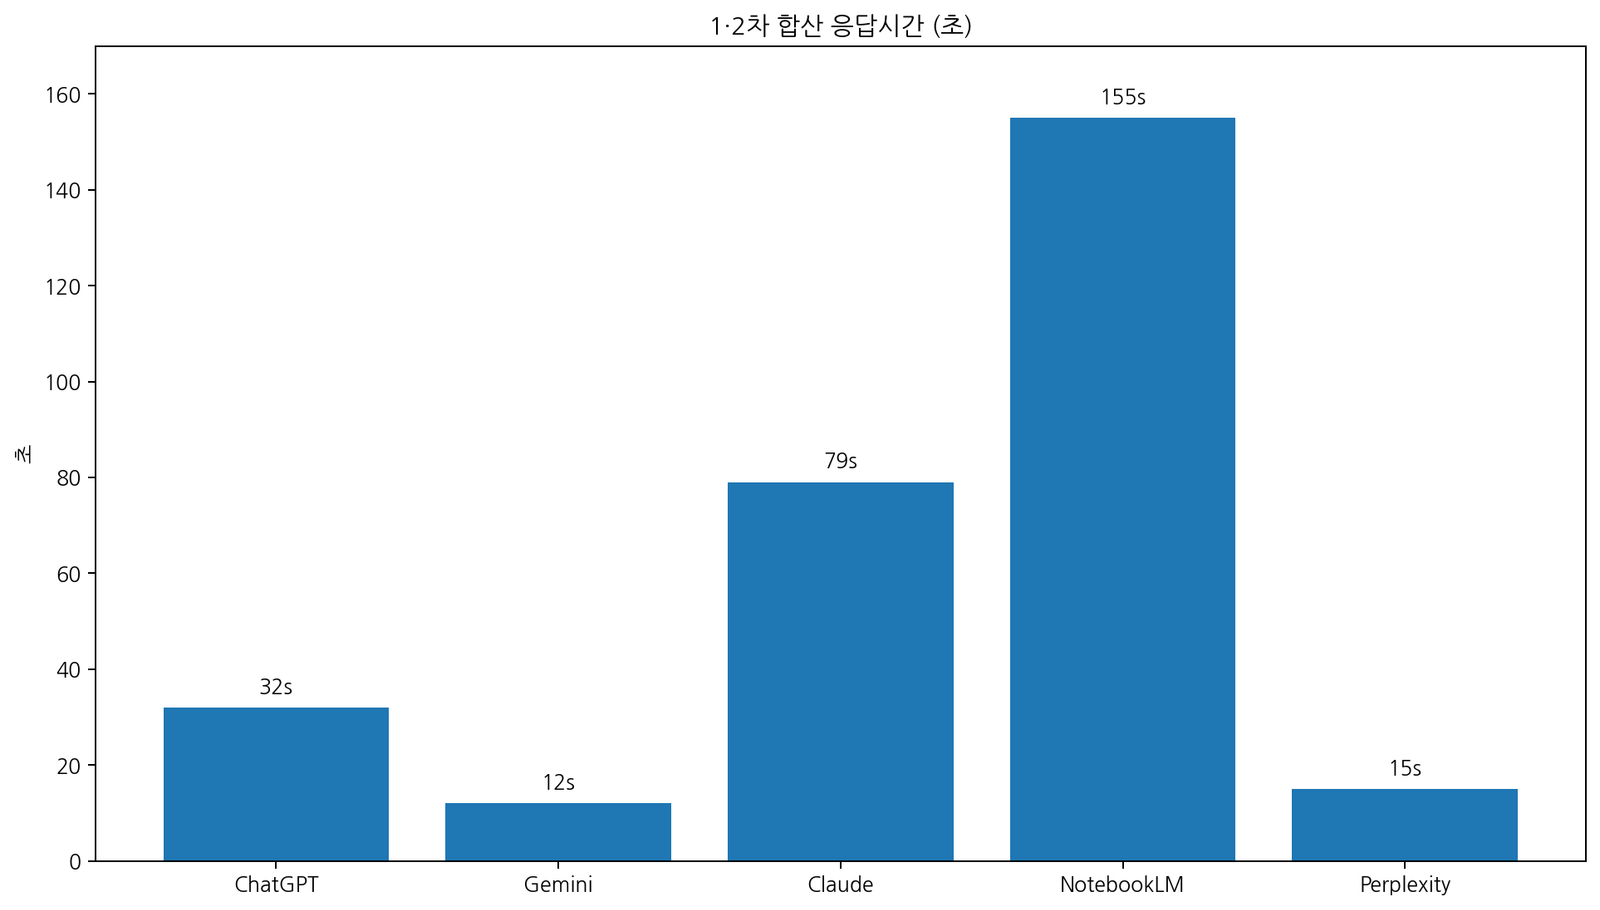
정확도만 보면 5개 서비스가 99~100점으로 사실상 평준화됐습니다. 반면 이번 두 번의 단일 실행에서 합산 응답시간은 12초부터 155초까지 차이가 났습니다.
처음부터 100점 테스트였던 것은 아니다
이번 실험은 처음에 40점짜리 1차 테스트로 시작했습니다. 담당자 변경, 마감일 변경, 완료·보류·조건부, 마지막 수치 정정을 섞어 이전 테스트보다 난도를 높였습니다.
그런데 먼저 실행한 ChatGPT와 Gemini가 모두 40/40을 기록했습니다. 이 정도로는 독자가 실제 차이를 보기 어렵다고 판단해, 1차 결과를 버리지 않고 60점짜리 2차 스트레스 테스트를 추가했습니다.
2차에는 회사 휴무일을 포함한 영업일 계산, 현재 액션 담당자와 후속 담당자 구분, 외부 선행조건, 취소·보류 판단, 그리고 제외·추가·증감을 반영해야 하는 계산형 수치를 넣었습니다. 2차 정답표를 고정한 뒤 동일한 소스와 프롬프트로 5개 서비스를 테스트했습니다.
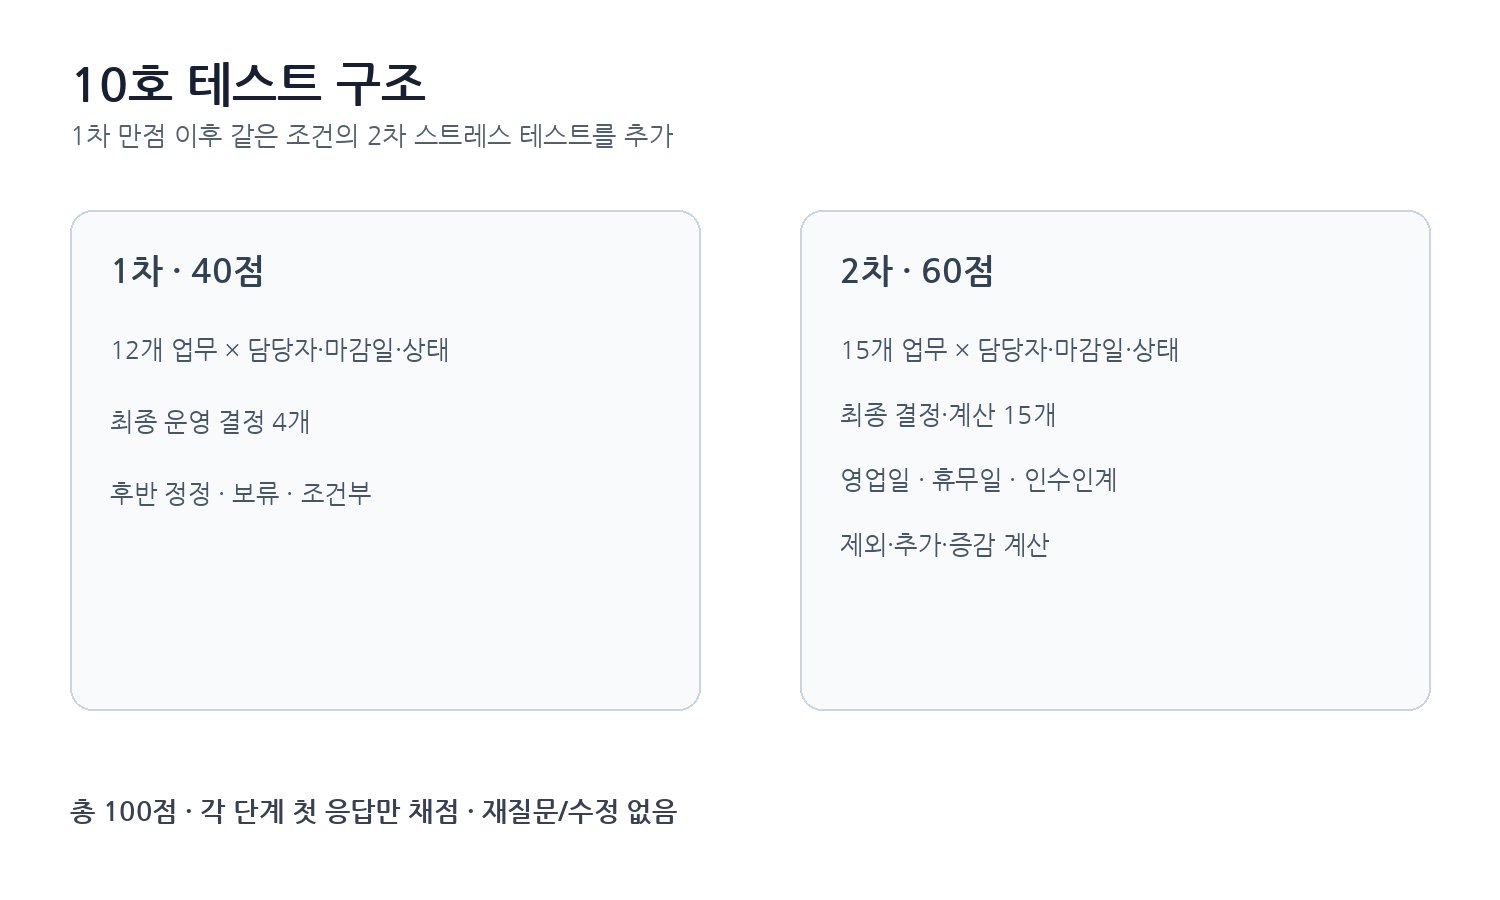
방법론상 주의: 2차 테스트는 모든 서비스를 보기 전에 완전히 사전등록된 것이 아니라, ChatGPT와 Gemini의 1차 만점 결과를 확인한 뒤 변별력을 높이기 위해 추가했습니다. 대신 2차 소스·프롬프트·정답은 만든 뒤 고정하고, 이후 모든 서비스에 동일하게 적용했습니다.
왜 NotebookLM은 이번에는 다시 포함했나
9호 코드 생성 테스트에서는 NotebookLM을 제외했습니다. 당시에는 소스 없이 새 Python 코드를 만드는 일반 코드 생성이 목적이어서, 소스 기반 사용 방식인 NotebookLM과 조건을 맞추기 어려웠기 때문입니다.
이번 10호는 반대로 하나의 회의록 소스를 읽고 최종 결정을 추출하는 작업입니다. NotebookLM의 사용 방식과 테스트 목적이 맞아 다시 비교 대상에 포함했습니다.
테스트 구성: 총 100개 채점 필드
| 단계 | 구성 | 배점 |
|---|---|---|
| 1차 | 12개 업무 × 담당자·마감일·상태 + 최종 운영 결정 4개 | 40점 |
| 2차 | 15개 업무 × 담당자·마감일·상태 + 결정·계산 15개 | 60점 |
| 합계 | 정답형 필드 100개 | 100점 |
각 단계는 새 대화 또는 새 노트에서 실행했고, 첫 응답만 채점했습니다. 틀린 답을 알려주거나 재질문·수정 요청을 하지 않았습니다.
최종 정확도: 5개 서비스가 99~100점
| 서비스 | 1차 | 2차 | 총점 | 합산 응답시간 |
|---|---|---|---|---|
| ChatGPT | 40/40 | 60/60 | 100/100 | 32초 |
| Gemini | 40/40 | 59/60 | 99/100 | 12초 |
| Claude | 40/40 | 60/60 | 100/100 | 79초 |
| NotebookLM | 40/40 | 60/60 | 100/100 | 155초 |
| Perplexity | 40/40 | 59/60 | 99/100 | 15초 |
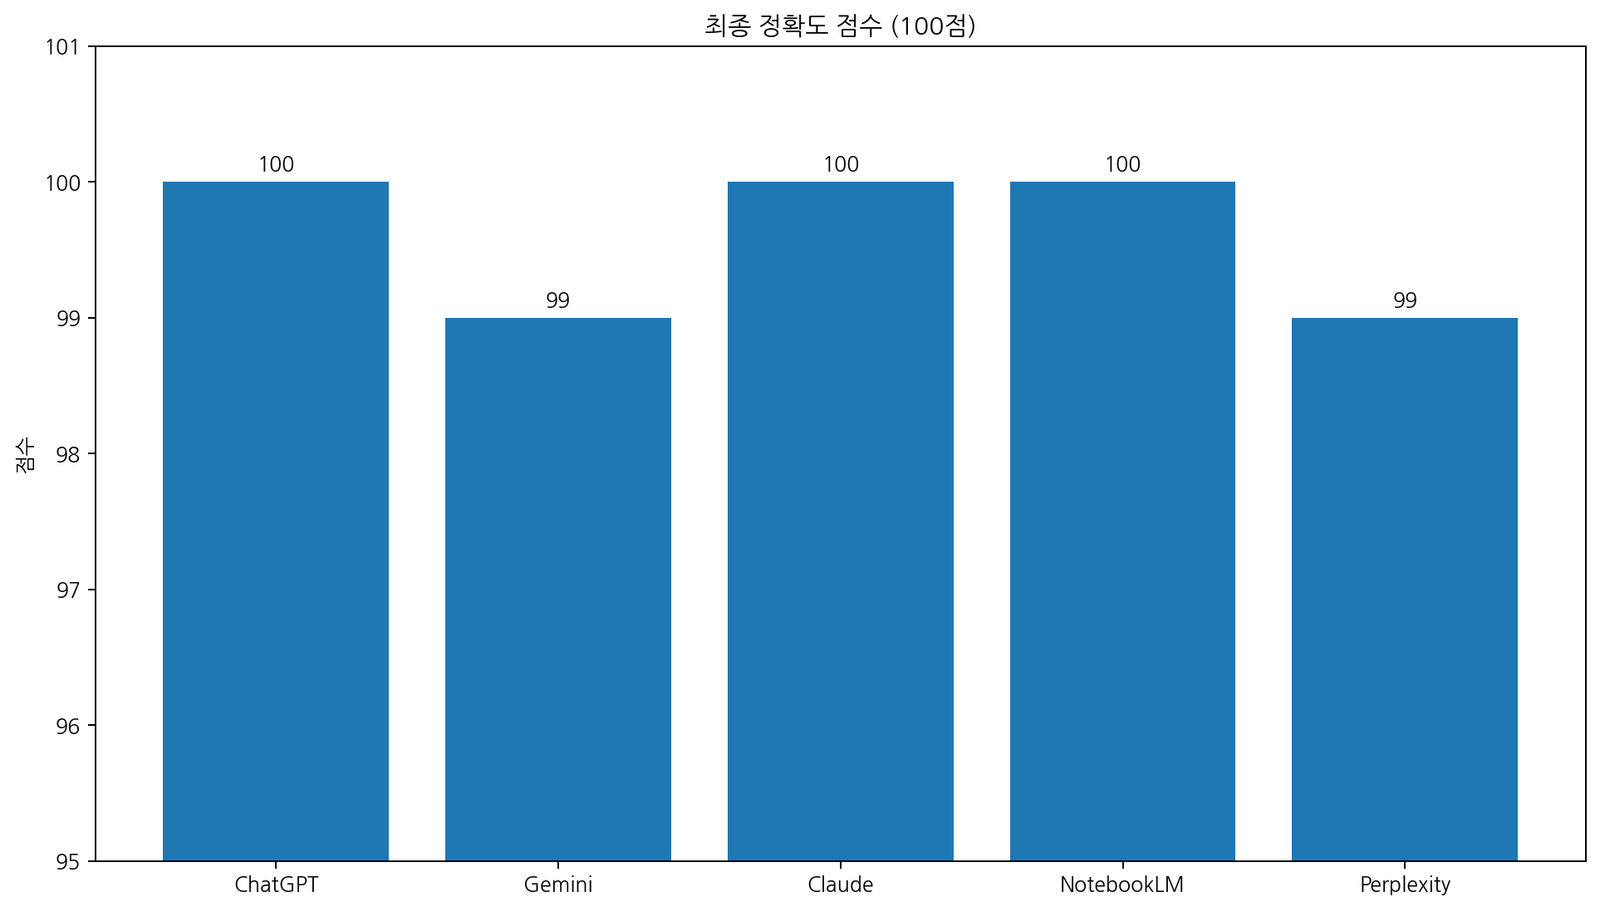
이 결과만 놓고 보면 이번 조건에서 회의록의 최종 상태를 읽어내는 정확도는 서비스 간 차이가 거의 없었습니다. 난도를 한 번 더 높였지만 대부분의 필드를 정확하게 처리했습니다.
Gemini의 1점은 명확한 계산 오류였다
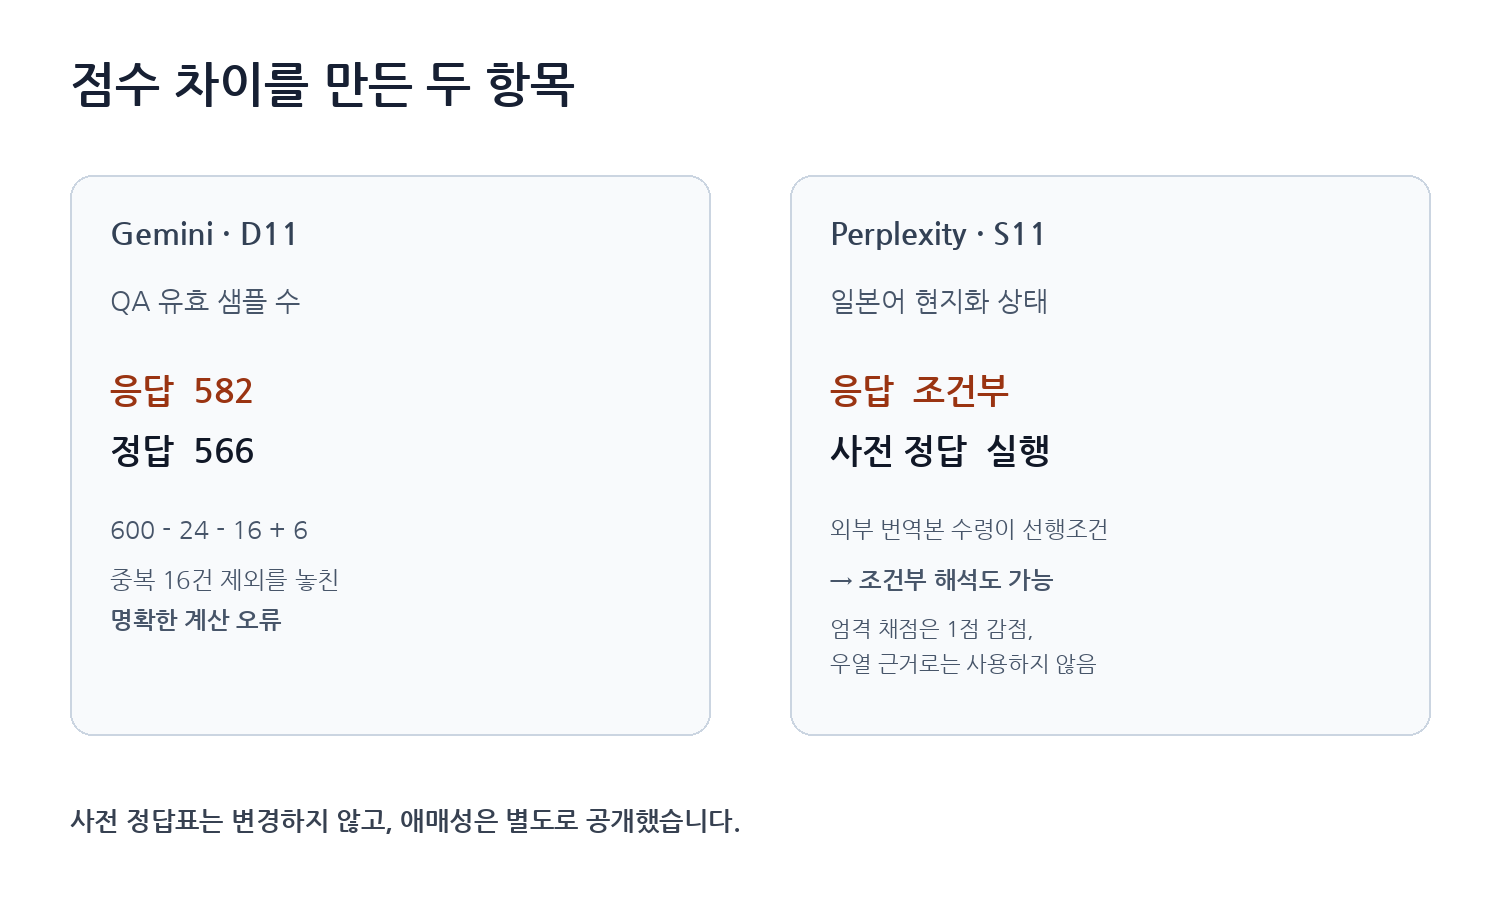
Gemini가 틀린 항목은 2차의 D11_QA유효샘플수였습니다.
- 최초 샘플: 600건
- 데이터 오류: 24건 제외
- 완전 중복: 16건 제외
- 오류 24건 중 라벨 문제였던 6건은 다시 포함
따라서 최종값은 600 - 24 - 16 + 6 = 566입니다. Gemini는 582라고 답했습니다. 결과상 완전 중복 16건 제외 조건을 반영하지 않은 값입니다.
Perplexity의 1점은 해석 여지가 있다
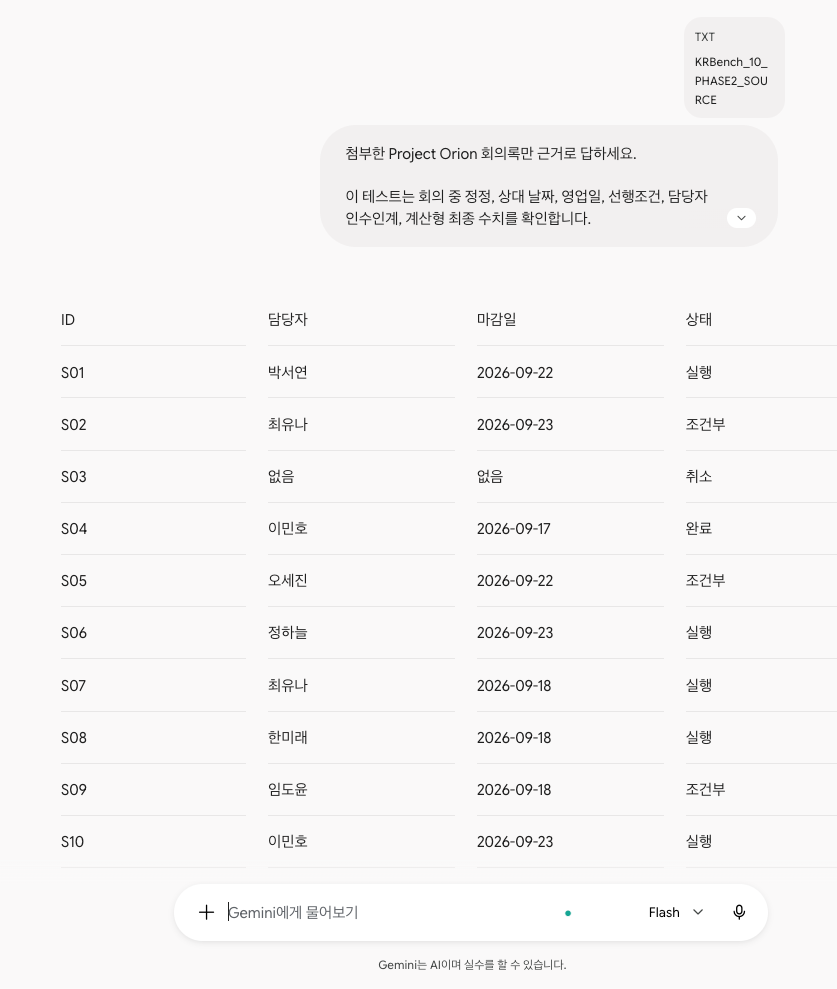
Perplexity는 2차 S11 ‘출시 메일 일본어 현지화’의 상태를 조건부라고 답했습니다. 사전에 고정한 정답표는 실행이어서 엄격 채점에서는 1점을 감점했습니다.
다만 회의록에는 외부 번역사가 9월 22일 번역본을 전달하고, 그 뒤 박서연이 최종 검수한다는 선행조건이 있습니다. 따라서 이 업무를 ‘조건부’로 해석한 것도 논리적으로 설명 가능합니다.
정답표를 결과에 맞춰 바꾸지는 않았습니다. 대신 엄격 채점 99점은 유지하되, 이 1점 차이를 서비스 간 우열을 판단하는 근거로 사용하지 않기로 했습니다.
정확도보다 응답시간 차이가 더 크게 보였다
두 단계의 응답시간을 합치면 다음과 같습니다.
- Gemini: 12초
- Perplexity: 15초
- ChatGPT: 32초
- Claude: 79초
- NotebookLM: 155초
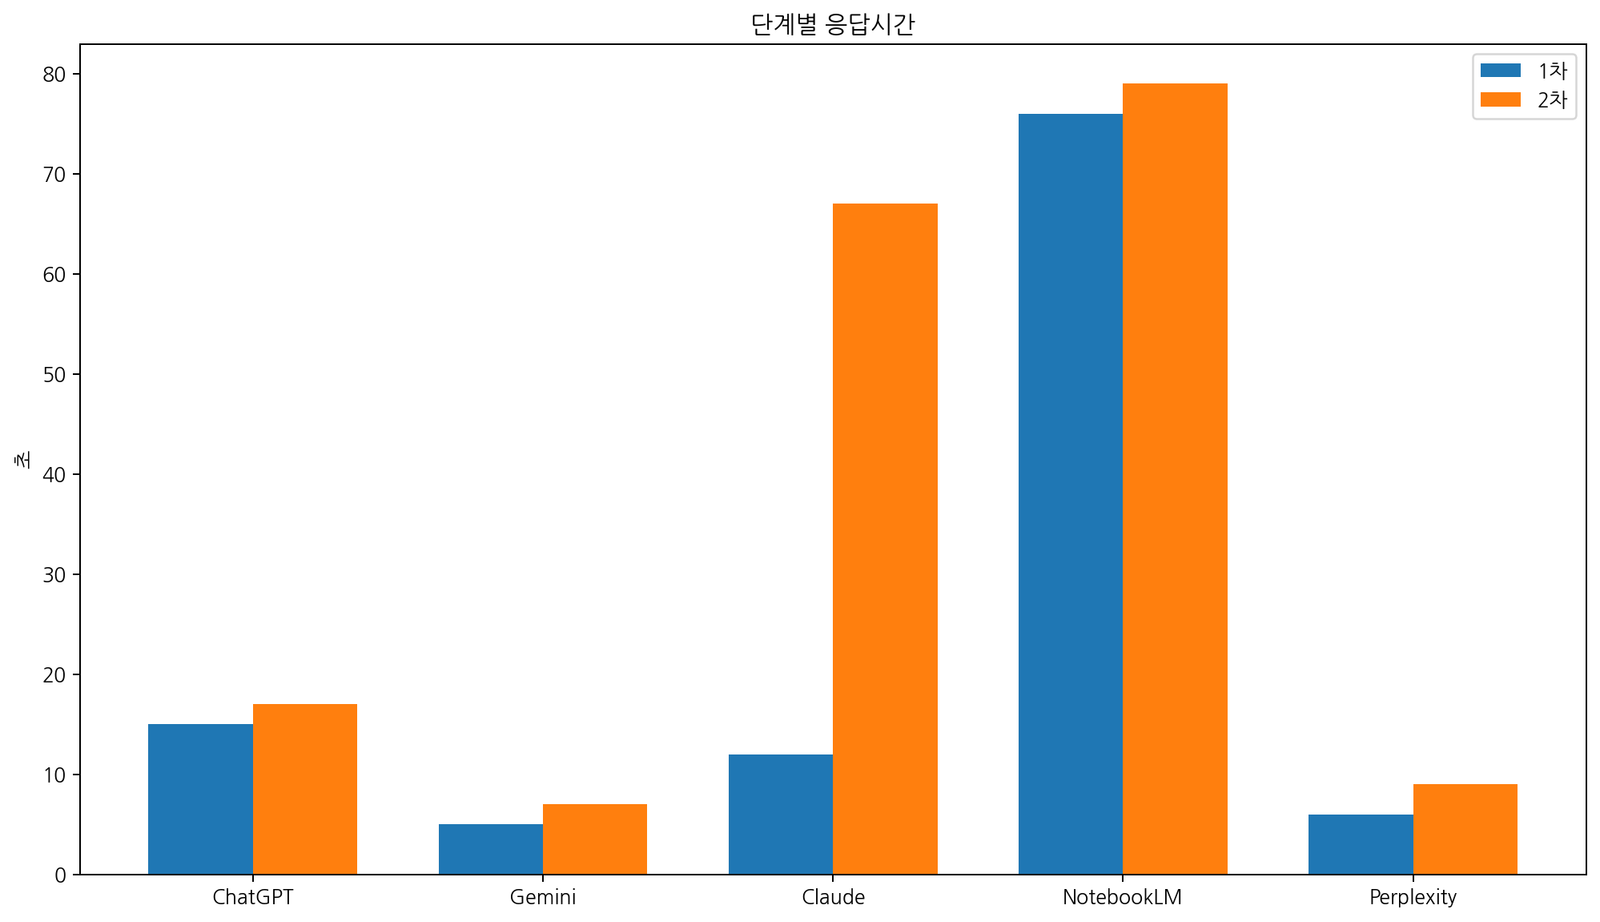
다만 이 시간은 각 단계에서 한 번씩만 측정한 값입니다. 서버 상태, 계정 환경, 모델 처리 과정에 따라 달라질 수 있으므로 일반적인 속도 순위로 확대하지 않았습니다.
이번 결과에서 확인된 점
이번처럼 텍스트 회의록 안에 최종 정정 규칙을 명확히 넣고, 출력 형식까지 구조화하면 현재 상위 AI 서비스는 상당히 높은 정확도로 최종 업무 상태를 정리했습니다.
특히 2차에서는 휴무일을 포함한 영업일 계산, 담당자 인수인계, 보류·취소, 여러 숫자를 조합하는 계산까지 넣었지만 5개 서비스 모두 59점 이상을 얻었습니다.
따라서 이번 테스트에서는 “어느 서비스가 압도적으로 정확한가”보다, 이 유형의 정형화된 회의록 추출 작업에서는 정확도 차이가 매우 작았다는 사실 자체가 더 중요한 결과였습니다.
이번 테스트의 한계
- 실제 회사 회의록이 아니라 KRBench가 만든 가상 회의록입니다.
- 음성 인식 품질은 평가하지 않았고, 완성된 텍스트 회의록을 입력했습니다.
- 출력 형식과 상태값을 명확하게 지정했기 때문에 자유형 요약보다 쉬운 측면이 있습니다.
- 100개 채점 필드는 서로 완전히 독립적인 100개 문제가 아닙니다. 같은 업무의 담당자·날짜·상태가 각각 1점입니다.
- 2차 스트레스 테스트는 ChatGPT와 Gemini의 1차 만점을 본 뒤 추가했습니다.
- 각 단계는 첫 응답 1회만 사용했으며 반복 측정 평균이 아닙니다.
- Perplexity S11 상태처럼 문맥에 따라 복수 해석이 가능한 항목이 있었습니다.
관련 KRBench 테스트
CSV 파일을 직접 분석하게 하면?
180행 한국어 이커머스 CSV와 25문항으로 조회·집계·비율·데이터 오류 탐지 정확도를 비교했습니다.
→ AI CSV 데이터 분석 정확도 비교 보기KRBench는 결과가 비슷하게 나오더라도 차이를 억지로 만들지 않고, 같은 조건에서 확인된 값을 그대로 기록합니다.
회의록 한 개가 아니라, 서로 충돌하는 PDF 6개를 동시에 읽히면?
최종 답뿐 아니라 어떤 문서와 정확한 라인을 근거로 사용했는지까지 100점으로 채점했습니다.
→ AI 복수 문서 교차검증 정확도 비교 보기