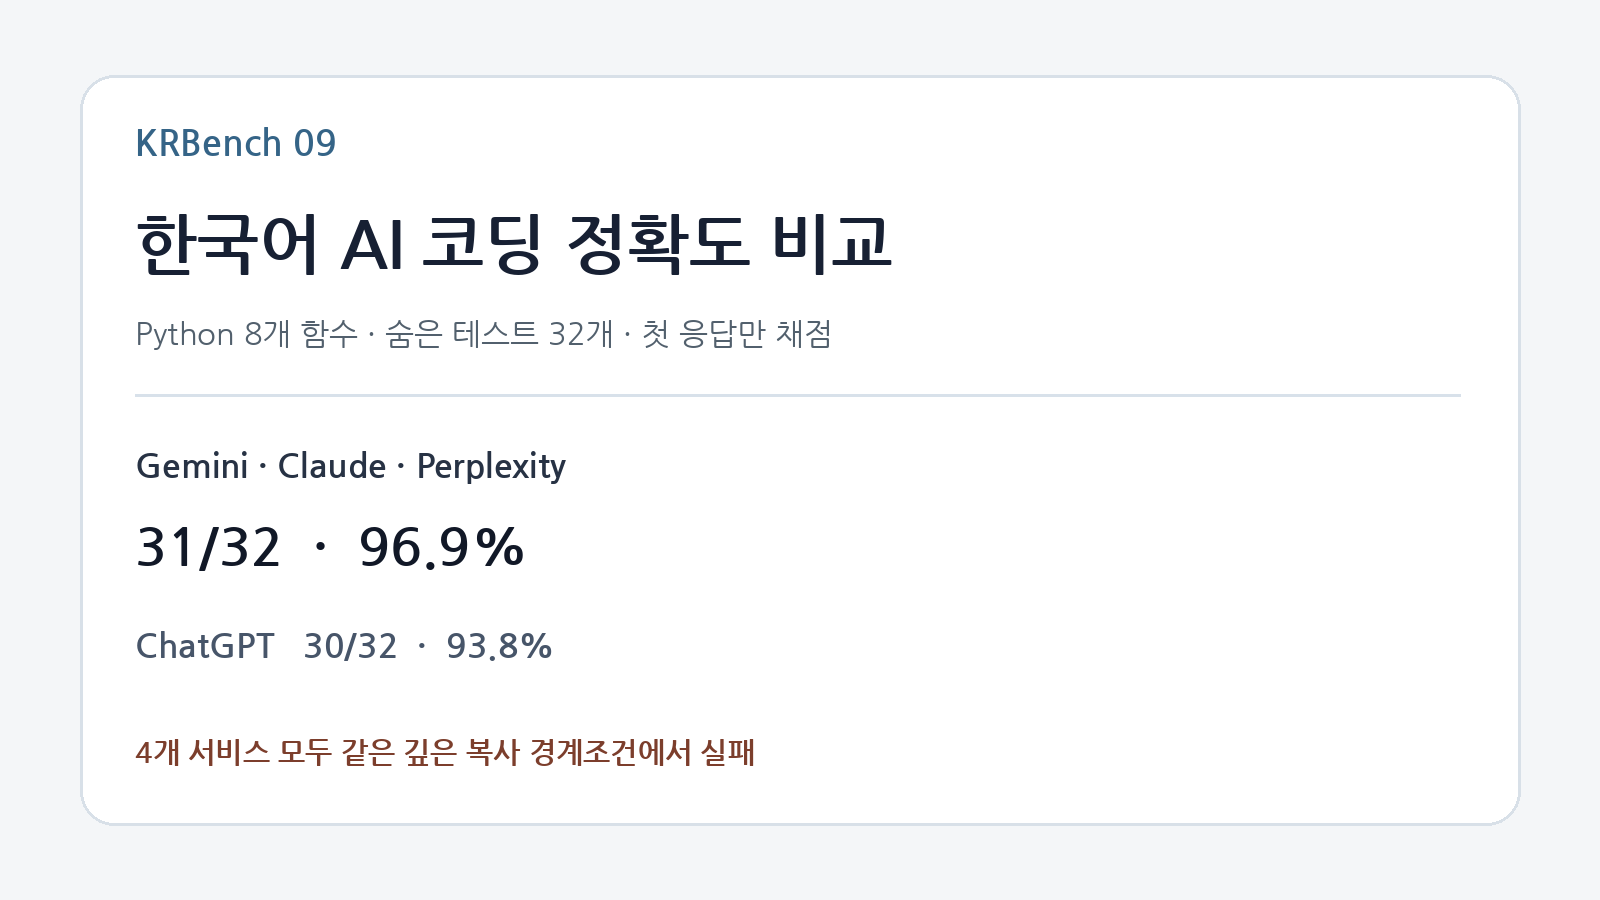
AI에게 한국어로 코딩 요구사항을 길게 설명하면, 실제로 실행 가능한 코드를 얼마나 정확하게 만들까?
KRBench는 ChatGPT, Gemini, Claude, Perplexity에 같은 한국어 Python 문제를 입력했습니다. 8개 함수를 한 번에 구현하게 한 뒤, 모델에는 공개하지 않은 숨은 단위테스트 32개로 첫 응답 코드를 직접 실행해 채점했습니다.
결과 요약
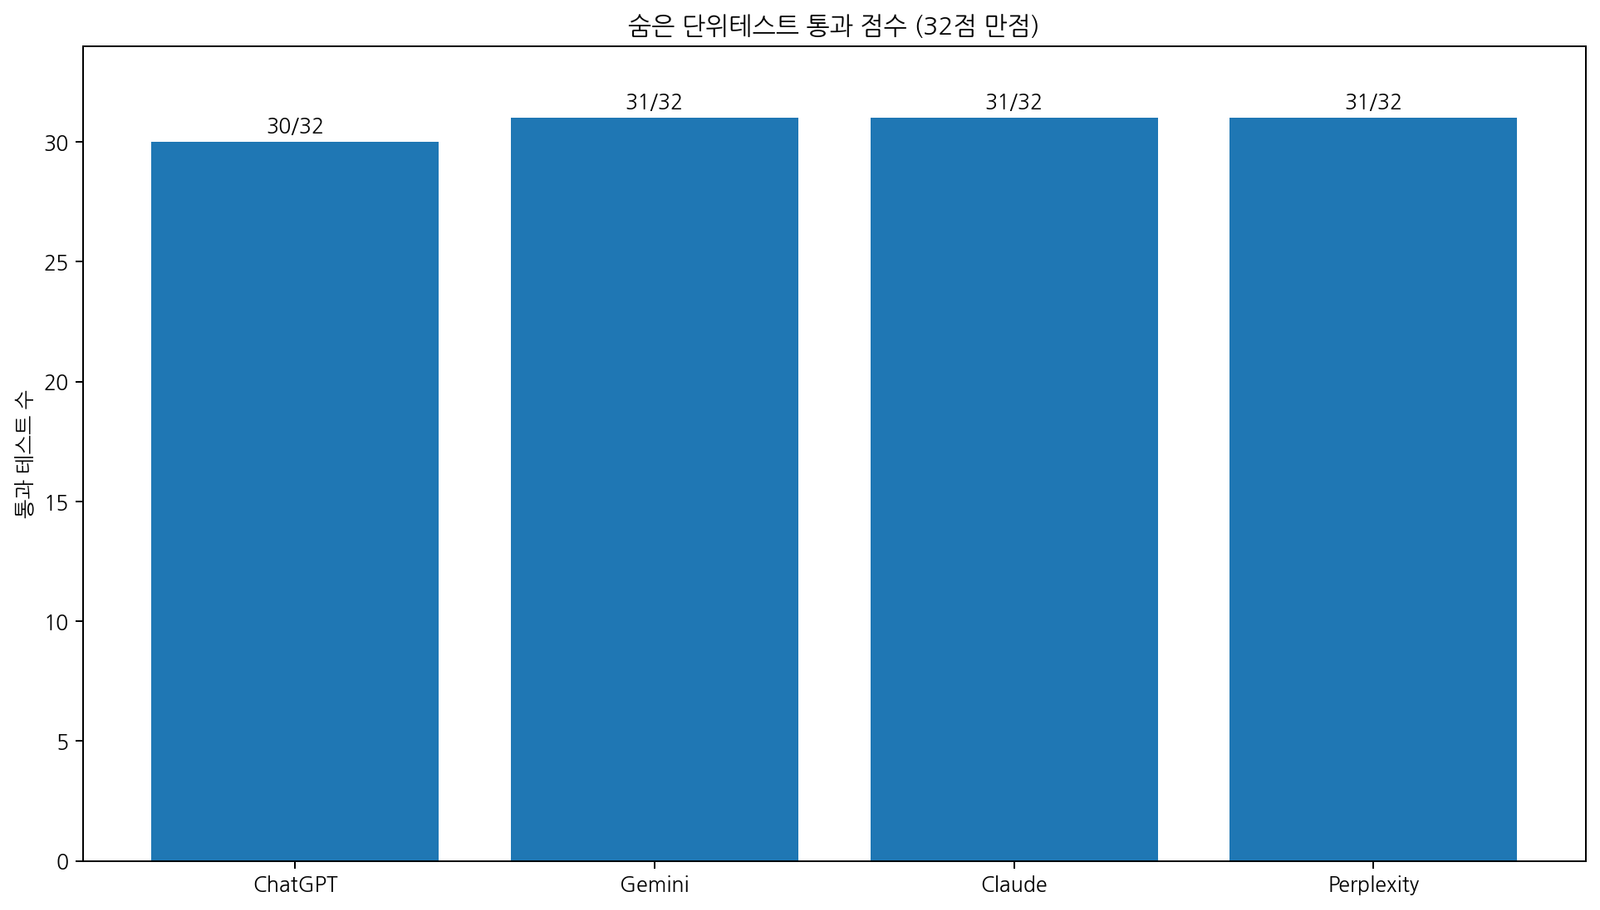
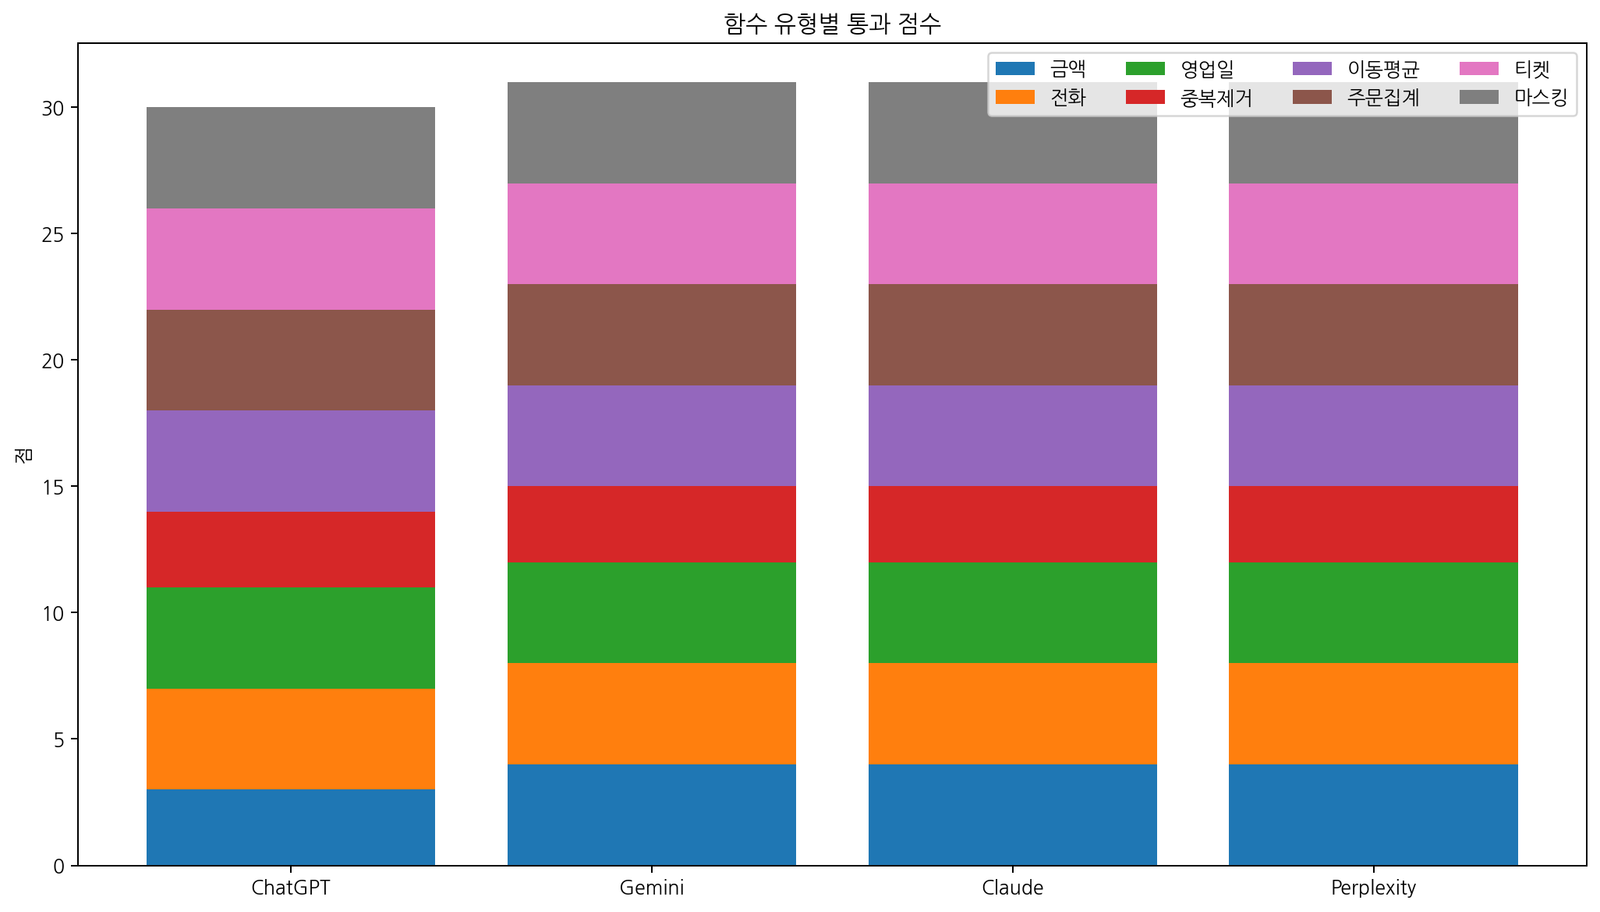
- Gemini: 31/32 (96.9%)
- Claude: 31/32 (96.9%)
- Perplexity: 31/32 (96.9%)
- ChatGPT: 30/32 (93.8%)
테스트 방법: 설명이 아니라 실제 실행 결과로 채점
이번 테스트에서는 “코드가 그럴듯해 보이는가”를 사람이 평가하지 않았습니다. 각 모델의 첫 답변에서 Python 코드만 저장하고 Python 3.12 환경에서 숨은 테스트를 실행했습니다.
| 구간 | 함수 | 주요 평가 내용 | 테스트 |
|---|---|---|---|
| M | parse_korean_money | 원·만·억 복합 금액 파싱, 잘못된 입력 | 4 |
| P | normalize_korean_mobile | 010·+82·공백·괄호 정규화 | 4 |
| B | business_days_inclusive | 주말·공휴일·역순 날짜 | 4 |
| D | dedupe_latest | 최신 레코드·동률·원본 독립성 | 4 |
| R | rolling_mean | None 처리·윈도 크기·예외 | 4 |
| S | summarize_orders | 취소·환불·고유 고객·동률 채널 | 4 |
| T | extract_ticket_ids | 정규식 경계·중복·대소문자 | 4 |
| K | mask_rrn | 형식 탐지·복수 마스킹·숫자 경계 | 4 |
모든 서비스는 첫 응답만 사용했고, 오류 메시지를 다시 전달하거나 수정·재생성을 요청하지 않았습니다. 외부 패키지는 허용하지 않고 Python 3.12 표준 라이브러리만 사용하도록 지시했습니다.
왜 이번에는 NotebookLM을 제외했나
이전 6호 PDF, 7호 OCR, 8호 CSV 테스트에는 NotebookLM도 참여했습니다. 그래서 연속해서 글을 본 독자라면 이번 비교에서 빠진 이유가 궁금할 수 있습니다.
이번 9호는 문서나 데이터 파일을 소스로 주는 테스트가 아니라, 소스 없이 동일한 한국어 요구사항만 보고 새 Python 코드를 생성하는 일반 코드 생성 테스트입니다.
Google 공식 도움말은 NotebookLM(Gemini Notebook)이 업로드한 소스를 사용해 질문에 답하거나 요청을 수행하며, 채팅에서는 소스 데이터에 기반해 답한다고 설명합니다. 따라서 NotebookLM까지 넣으면 다른 네 서비스와 입력·사용 방식이 달라질 수 있어 이번 테스트에서는 제외했습니다.
→ Google 공식: NotebookLM 소스 추가 및 지원 형식
→ Google 공식: NotebookLM 채팅의 소스 기반 응답
최종 결과: 네 서비스 모두 30개 이상 통과
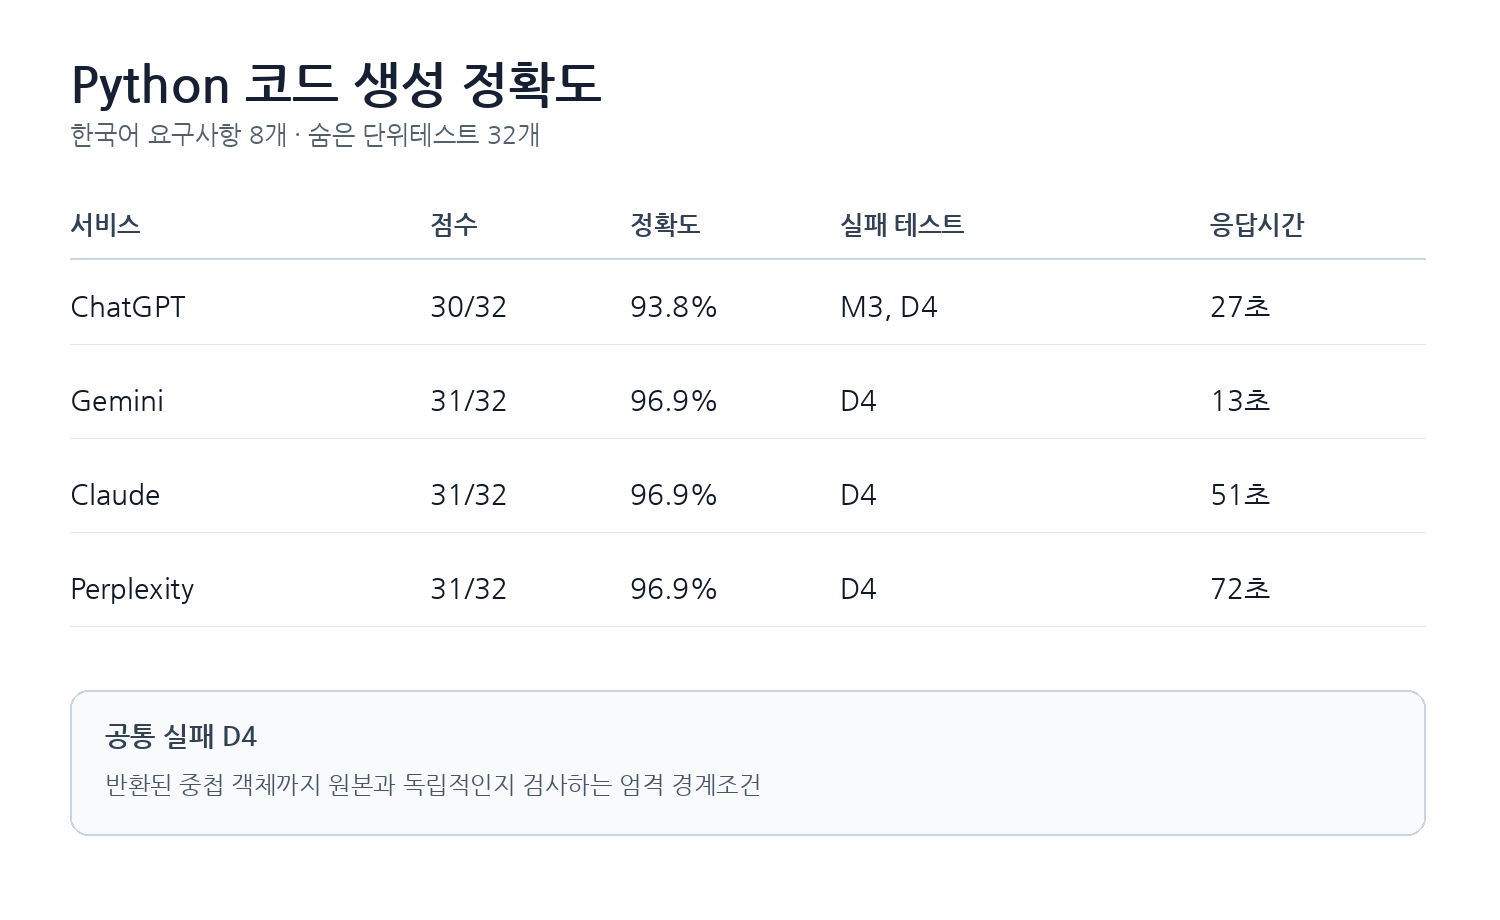
| 서비스 | 점수 | 정확도 | 실패 | 응답시간 |
|---|---|---|---|---|
| ChatGPT | 30/32 | 93.8% | M3, D4 | 27초 |
| Gemini | 31/32 | 96.9% | D4 | 13초 |
| Claude | 31/32 | 96.9% | D4 | 51초 |
| Perplexity | 31/32 | 96.9% | D4 | 72초 |
네 서비스가 모두 KRBench의 D4 경계조건에서 실패했다
가장 눈에 띄는 결과는 ChatGPT, Gemini, Claude, Perplexity 네 서비스가 모두 D4에서 실패했다는 점입니다.
D4는 dedupe_latest 함수가 반환한 dict의 내부 리스트를 수정했을 때, 입력으로 받은 원본 dict의 내부 리스트까지 함께 바뀌는지 검사했습니다.
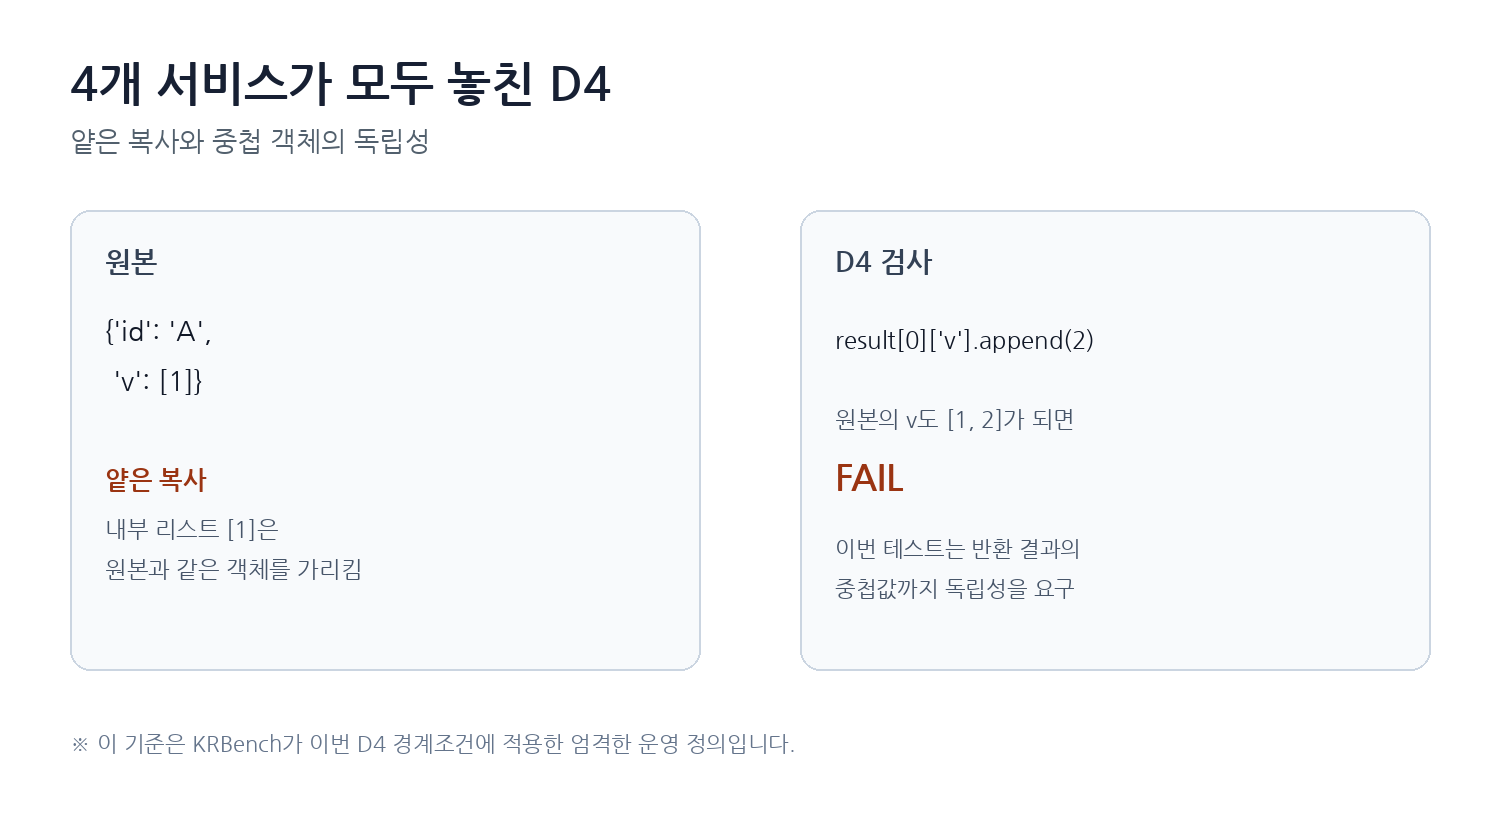
네 서비스 모두 원본 dict를 직접 수정하는 코드는 작성하지 않았지만, 반환 결과에 원본의 중첩 객체가 그대로 연결되는 구조였습니다.
D4 채점 기준: 이번 테스트에서는 프롬프트의 ‘원본 dict를 수정하지 마세요’를 엄격하게 해석해, 반환된 dict 내부의 리스트 같은 중첩 객체까지 원본과 독립적이어야 통과하도록 정의했습니다.
즉 이 결과는 “네 서비스 모두 복사를 전혀 하지 못했다”는 의미가 아니라, 이번에 정의한 깊은 독립성 경계조건까지는 만족하지 못했다는 의미입니다.
ChatGPT는 복합 한국어 금액에서 한 문제를 추가로 놓쳤다
ChatGPT의 추가 실패는 M3였습니다.
- 입력:
2억 3,450만원 - 정답:
234500000 - 결과:
ValueError
단순 원 금액, 소수 만 단위, 잘못된 입력 예외 처리는 통과했지만 ‘억 + 만’이 연속되는 복합 단위에서 단위 순서 검사 로직이 값을 거부했습니다.
Gemini·Claude·Perplexity는 D4 외 31개 테스트 통과
세 서비스는 금액 파싱, 한국 휴대전화 정규화, 영업일 계산, 이동평균, 주문 집계, 티켓 ID 추출, 주민번호 형태 마스킹 테스트를 모두 통과했습니다.
세 서비스의 점수는 같았지만 첫 응답 완료시간은 달랐습니다.
응답시간은 13초부터 72초
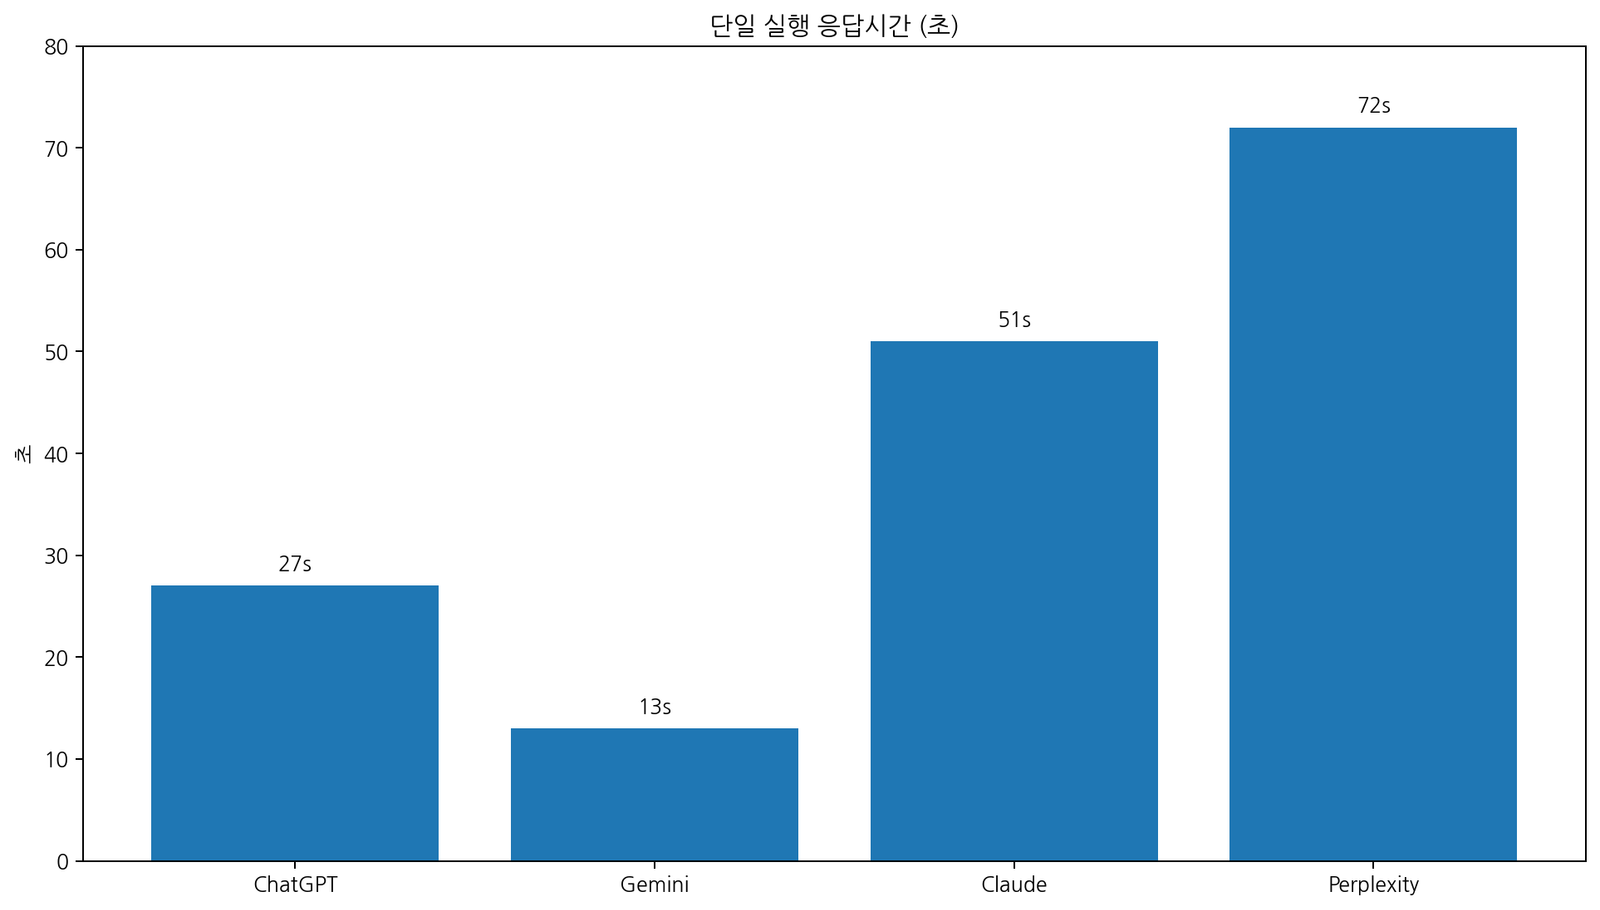
- Gemini: 13초
- ChatGPT: 27초
- Claude: 51초
- Perplexity: 72초
응답시간은 각 서비스에서 한 번만 측정한 값입니다. 서버 상태, 모델 처리 과정, 계정 환경에 따라 달라질 수 있으므로 일반적인 속도 순위로 확대해 해석하지 않았습니다.
이번 테스트의 한계
- Python 함수 8개와 숨은 테스트 32개로 진행한 단일 벤치마크입니다.
- 웹 개발, 프레임워크, 데이터베이스, 대규모 프로젝트 코드는 포함하지 않았습니다.
- 첫 응답 코드만 채점했고 디버깅 대화나 수정 능력은 평가하지 않았습니다.
- 테스트는 Python 3.12 표준 라이브러리 범위로 제한했습니다.
- D4는 ‘원본 비변경’을 중첩 객체의 독립성까지 포함하는 엄격 기준으로 정의했습니다.
- 응답시간은 각 서비스 1회 측정값입니다.
- NotebookLM은 소스 기반 도구라는 사용 방식 차이 때문에 이번 일반 코드 생성 비교에서 제외했습니다.
관련 KRBench 테스트
CSV를 직접 계산하게 하면 결과가 어떻게 달랐을까?
같은 한국어 이커머스 CSV 180행과 25문항으로 조회, 필터, 집계, 비율, 데이터 오류 탐지 정확도를 비교했습니다.
→ AI CSV 데이터 분석 정확도 비교 보기PDF 문서 이해 정확도도 같은 방식으로 측정했습니다.
같은 7페이지 한국어 PDF와 10개 질문으로 정답, 환각, 근거 페이지, 응답시간을 비교했습니다.
→ 한국어 PDF AI 정확도 비교 보기KRBench는 같은 입력과 같은 조건에서 직접 시험하고, 사람이 보기 좋은 코드가 아니라 실제 실행 결과로 비교합니다.
코딩 다음에는, 복잡하게 정정되는 한국어 회의록을 얼마나 정확히 정리할까?
ChatGPT, Gemini, Claude, NotebookLM, Perplexity에 같은 회의록을 주고 담당자·마감일·상태·계산형 최종값 100개 필드를 채점했습니다.
→ AI 회의록 정확도 비교 보기